Engram 原始设计:Conditional Memory via Scalable Lookup
论文:Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models,DeepSeek-AI + 北京大学,arXiv:2601.07372,2026[1]。 代码:官方实现 deepseek-ai/Engram(Apache-2.0)[4]
动机:语言建模的两面性
语言建模实际混合了两类性质不同的子任务:
- 组合推理:需要深层、动态的计算;
- 知识检索:命名实体、公式化套语等局部、静态、高度模式化的内容, 经典 N-gram 模型就能很好地刻画。
标准 Transformer 缺乏原生的知识查找原语,只能用计算模拟检索。
案例:解析一个实体花了六层深度
论文引用 Patchscopes 的实体解析实验[2]把这一缺陷具象化。Patchscopes 的做法很直接:取出一个 hidden state,塞进另一条 prompt 里让模型接着写—— 模型写出的文字,就是这个向量的"翻译"。具体三步:
- 源 prompt 为
Diana, Princess of Wales,取末 token "Wales" 在第 层的 hidden state(实体表征在实体名末 token 处聚合); - 目标 prompt 用描述模板
subject1: description1, …, x,把占位符 "x" 在同一层()的 hidden state 换成第 1 步取出的向量; - 继续前向,模型在 "x:" 后补出的实体描述,就是这一层向量的"翻译"。
在 Vicuna-13B 上逐层重复,得到下表(Engram 论文 Table 3 即转引自此):
| 层 | hidden state 翻译 | 解读 |
|---|---|---|
| 1–2 | 英国的一个构成国 | 词面先验:"Wales" 只是那个国家,上下文尚未生效 |
| 3 | 欧洲的一个国家 | 仍是国家义 |
| 4 | 女性君主自己持有、或王后配偶所持的称号 | 上文 "Princess of" 开始卷入,但只是泛化的头衔定义 |
| 5 | 威尔士亲王(及后来的国王)之妻的称号 | 头衔精确化为 "Princess of Wales",仍未绑定具体人物 |
| 6 | Diana, Princess of Wales(1961–1997),查尔斯王子的第一任妻子,以美貌与人道主义工作闻名 | 完整实体解析 |
三个阶段泾渭分明:词面先验(1–3 层,"Wales" = 国家,纯静态知识)→ 局部组合(4–5 层,注意力把左侧的 "Princess of" 逐步聚合进末 token, 重建这条高频 N-gram 的泛化模式)→ 全实体绑定(6 层,整合最左侧的 "Diana," 才消歧到具体的人)。
关键在于:这六层逐步"算"出来的每条信息——威尔士是英国的一部分、 Princess of Wales 是头衔、戴安娜是其最著名的持有者——都是训练语料中反复 出现的静态事实,一张 N-gram 查找表本可在 O(1) 内直接取回该实体的嵌入。 标准 Transformer 没有查找原语,只能用六层 Attention + FFN 在运行时 重建这张静态查找表,且代价由序列深度支付:这些层被占用后,留给高层 组合推理的有效深度就变少了。Patchscopes 还在 PopQA 的 400 个实体 (200 高频 + 200 长尾)上量化了该过程:生成描述与 Wikipedia 描述的 RougeL 相似度在最初约 5 层持续上升、随后缓慢下降,且长尾实体显著差于 高频实体——用计算模拟检索不仅慢,对低频知识还不可靠[2]。
Engram 的回应:把 O(1) 的 N-gram 查找模块插在浅层(论文采用第 2 层),让这类 局部静态模式在注意力消耗深度之前就被显式取回。
论文因此提出条件记忆作为与条件计算(MoE)互补的稀疏轴: MoE 稀疏激活参数以处理动态逻辑,条件记忆用稀疏查找取回静态嵌入 (static embeddings)以存取固定知识。 Engram 是这一范式的实例化:现代化改造的 N-gram 嵌入 + O(1) 查找[1]。
架构:Retrieval 与 Fusion 两阶段

图 1|Engram 架构(取自论文 Figure 1[1])。左:模块挂在 Vocab Embedding 之后的残差路径上、位于 Attention / MoE 之前,仅插入特定层以解耦记忆与计算, 输入/输出 embedding 保持原样;右:模块内部——2/3-gram 上下文各经 个 哈希头查表,Concat 后经两个 Linear 分别投影为 Key 与 Value, 与 Input Hidden 做缩放点积得到标量门控,门控后的记忆向量再经 Conv (深度因果卷积)注入残差主干。
总览(§2.1)
Engram 是一个条件记忆模块(conditional memory module):增强 Transformer 骨干,把静态模式存储(static pattern storage)与 动态计算(dynamic computation)在结构上分离。给定输入序列 与第 层的 hidden state ,模块在每个位置 上分两个功能阶段处理:
- Retrieval(§2.2):抽取并压缩后缀 N-gram,经确定性哈希取回 静态嵌入向量(static embedding vectors);
- Fusion(§2.3):取回的嵌入由当前 hidden state 动态调制 (dynamically modulate),再经一个轻量卷积(lightweight convolution)精炼。
输出经残差写回 ,随后进入该层标准的 Attention 与 MoE;模块不施加于 每一层,具体放置由系统级延迟约束决定(§2.5)。多分支骨干下的适配见 §2.4。
Retrieval:Tokenizer 压缩 + 多头哈希(§2.2)
Retrieval 阶段把局部上下文映射为静态记忆条目(static memory entries), 分两小步。
不需要知道——每个位置都无条件查表。对每个位置 ,取以 结尾、
向前看 个 token 的后缀 N-gram
——方向是回看历史(因果), 右边的 token 不参与。例:"Alexander the
Great" 在末 token 处取 2-gram (the Great) 与 3-gram (Alexander the
Great),两个阶数各自独立哈希寻址,然后窗口滑到下一位置重复。没有
"值不值得查"的预判断,也没有可学习的路由(对比 MoE 的动态激活)[1]。
"哪些该用"的筛选完全推迟到 Fusion 的门控 :取回的记忆与当前
hidden state 语义一致才注入,矛盾则 。这一筛选在训练中习得
——User as Engram 的玻璃盒测量显示,写入一条事实后 trigger 位置的门控
从 0.02 升至 0.99,非 trigger 位置保持 ≤0.04[3]。
Tokenizer 压缩。子词分词器以无损重建为先,常给语义等价的词分配不相交的
ID(如 Apple vs ␣apple)。Engram 预计算一个满射映射
,按归一化文本等价(NFKC、小写化等)把原始 token ID
折叠为规范 ID ,构成后缀 N-gram
。对 128k 词表,这一步可缩减约 23%
的有效词表规模,最大化语义密度。
该映射满足满射性(surjectivity)而不满足单射性(injectivity)。满射性保证 中每个规范 ID 都至少有一个原像,即折叠后不产生不可达的槽位;非单射性 则是压缩的来源:多个原始 ID 归并到同一规范 ID,大小写、重音、空白等表面 差异在寻址路径上被有意丢弃,使 "Apple pie" 与 "apple pie" 共享同一组记忆行 与同一份统计信号。需要指出的是,该折叠仅作用于 Engram 的哈希寻址;主干的 词嵌入与 LM head 仍使用原始词表。
官方实现将上述过程分为两个阶段[4]。词表构建阶段遍历全部原始 token ID,
经归一化链(normalizer chain)得到等价类键,并按键首次出现的顺序分配规范 ID,
固化为 old2new 查找表;推理阶段该映射实现为一次数组 gather,其后直接进入
multiplicative-XOR 哈希。相关源码(commit fb7f84a):normalizer 链见
engram_demo_v1.py
L68-L77,
查找表构建见
L84-L110,
推理期映射见
L112-L118。
Multi-head Hashing。全体 N-gram 的组合空间无法直接参数化,故沿用哈希 嵌入(hash embeddings)思路[5]:每阶 配 个哈希头,头 用确定性的 multiplicative-XOR 哈希 把压缩后的上下文映射进一张 素数大小 的嵌入表:
再把各阶()各头的检索向量拼接为 memory 向量:
动机:N-gram 的组合空间是爆炸的——词表 、3-gram 就有 种, 不可能给每个 N-gram 建一行嵌入。哈希把无限的 key 空间压进有限大小的表。
算法:为 N-gram 里每个位置配一个固定奇数乘子 ,交替"乘—异或", 再对素数表大小取模:
三个操作各司其职:乘法把 token ID 的比特打散(扩散,避免相邻 ID 扎堆); 异或把各位置的贡献无序地混合(比加法更难产生系统性碰撞); 取模素数把结果收敛到表内(素数表大小减少整除结构带来的周期性碰撞)。
确定性是工程前提:乘子按层固定、训练前即生成,因此地址只依赖输入 token ID, 在前向计算之前就可算出——这正是把 100B 参数表放主机内存提前预取的依据 (对比 MoE 依赖运行时 hidden state 的动态路由)。
为什么要 个头:哈希必有碰撞,单头撞了就是错行; 个头独立哈希、 结果拼接(),单个头碰撞只是多引入一份 噪声,还可由 Fusion 的门控 抑制——多哈希头用于缓解碰撞[1][5]。
Fusion:上下文感知门控 + 轻量卷积(§2.3)
Retrieval 得到的 是上下文无关的先验(context-independent priors), 天然缺乏上下文适应性,会受哈希碰撞 与一词多义噪声影响。Fusion 阶段用上下文感知门控(context-aware gating, 类 Attention 机制)消解这一歧义: 以当前 hidden state (已经过前置注意力聚合全局上下文)为动态 Query, 经投影后作 Key 与 Value:
Query/Key 先过 RMSNorm 保证梯度稳定(gradient stability);门控输出 强制语义对齐(semantic alignment)—— 若检索记忆与当前上下文矛盾, 趋向 0,自动抑制噪声。
之后接一个短 depthwise 因果卷积(short, depthwise causal convolution) 扩展感受野并增强非线性(kernel 、 dilation = 最大 N-gram 阶、SiLU 激活):
卷积零初始化(zero-initialized)使训练起点严格等价于恒等映射。最终经残差连接 (residual connection)写回主干: ,随后进入该层标准的 Attention 与 MoE。
与多分支骨干集成(§2.4)
骨干采用多分支残差流(mHC [6], 分支,可学习连接权重调制信息流)。 Engram 本身拓扑无关(topology-agnostic),适配多分支时采用参数共享 (parameter-sharing)策略:单一稀疏嵌入表与 Value 投影 跨所有分支共享,每个分支用独立的 Key 投影 实现分支特异的门控(branch-specific gating):
好处有二:分支门控各异而记忆同源;全部线性投影(1 个 + 个 )可融合为单个稠密 FP8 矩阵乘,充分利用现代 GPU 算力。
标准残差流是"单车道":每层只有一条残差流,所有特征挤在同一路信号上,
深度增加时会出现"梯度传得深 vs 表示不雷同"的跷跷板效应。
mHC(Manifold-Constrained Hyper-Connections)[6] 把残差流加宽成
条并行分支,分支间的混合/读取/回写由逐 token、逐层预测的系数
( 输入混合、 流间混合、 输出回写)动态决定;再把混合矩阵
约束到双随机矩阵流形(Birkhoff polytope)上,以恢复恒等映射、稳住训练。
论文配置 (官方实现里即 hc_mult = 4)。
对 Engram 的影响:模块要写回的是 条分支而非单条流,于是有了 §2.4 的参数共享设计——嵌入表与 共享(记忆同源),每分支一个 (门控各异)。消融显示分支特定融合是最关键的组件 (逐项移除时退化最大),因为并行的多条分支恰好提供了 mHC 所需的 表征分化,让门控能做出更细的区分。
仓库内已有专题笔记:deepseek-v4-1-flash-mhc.md(含 公式
与多次读写的系统优化)。
实验分析
稀疏分配:U 型缩放律
把总参数中不参与每 token 计算的部分记为"免费"预算 ,分配比 表示 MoE 路由专家 拿走 、Engram 嵌入槽位拿走 。 在两个算力档(2e20 / 6e20 FLOPs)下扫描 ,loss 呈稳定的 U 型, 且纯 MoE()并非最优[1]:
- 最优分配在 (即约 20–25% 稀疏预算分给 Engram);
- 10B 档(6e20)验证 loss 从 1.7248()降至 1.7109();
- 即使把 MoE 配比压到 ,仍与纯 MoE 基线持平。
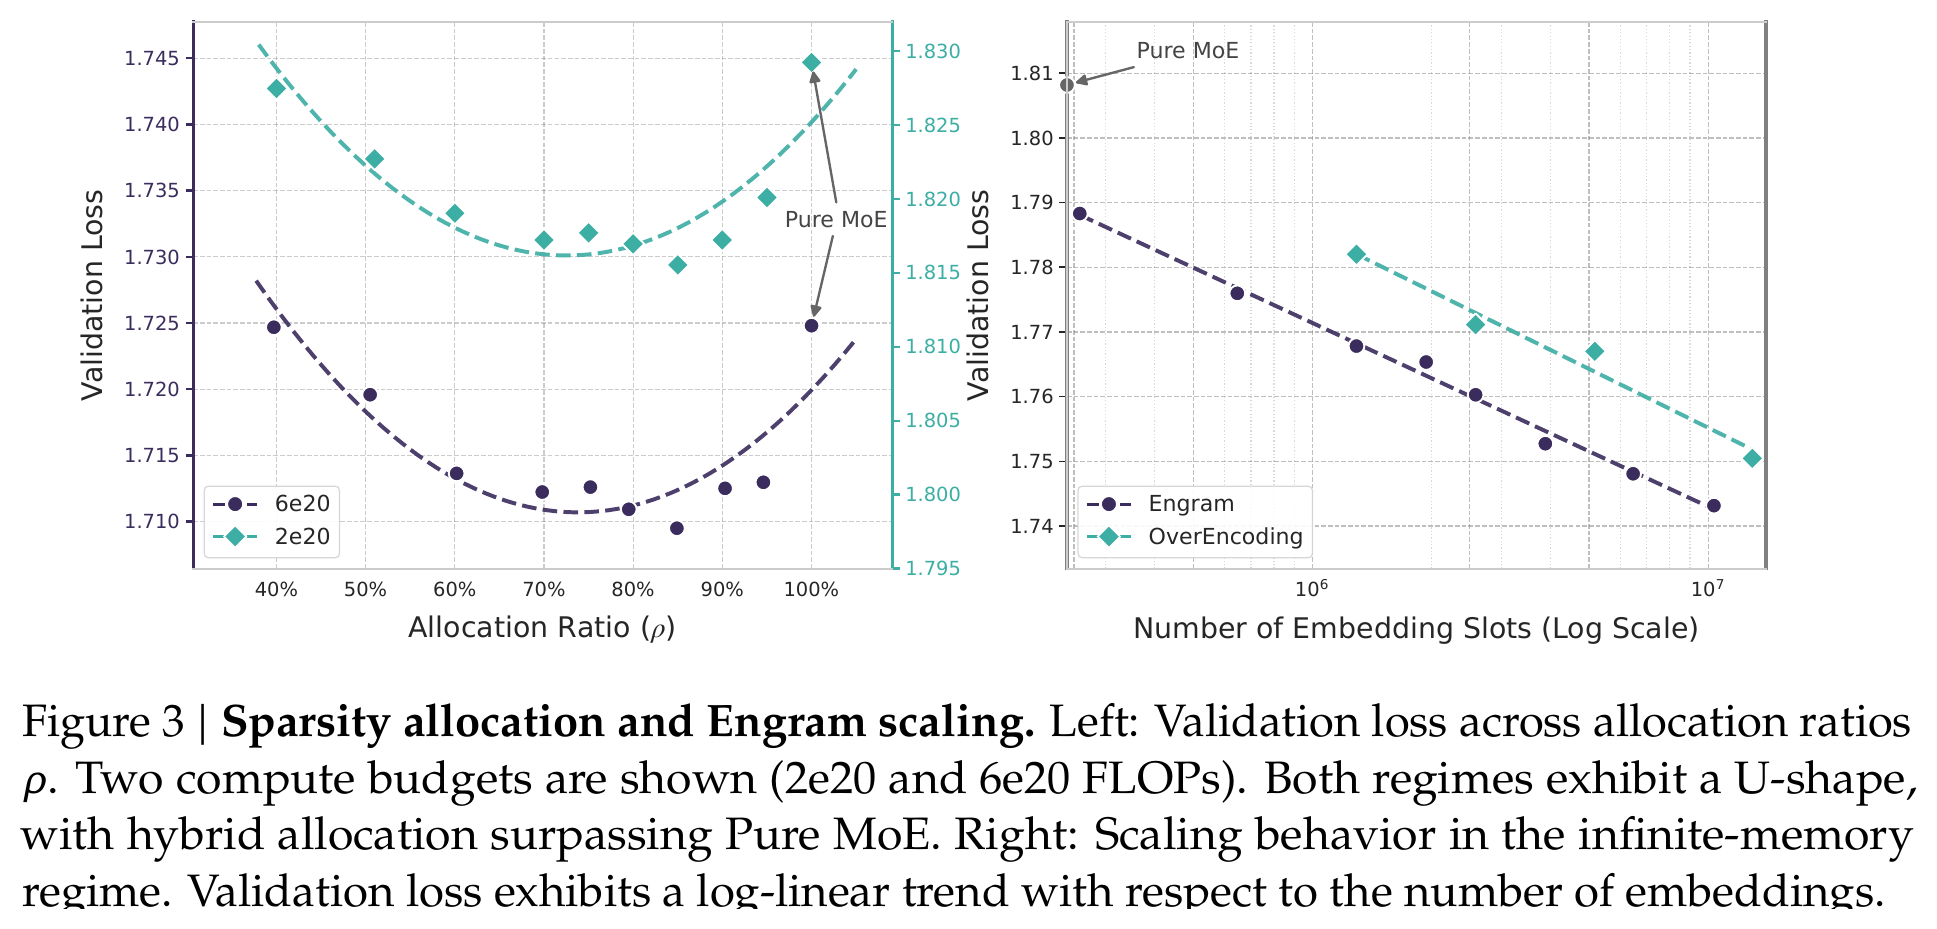
图 2|稀疏分配与 Engram 缩放(取自论文 Figure 3[1])。左:验证 loss 随分配比 的 U 型曲线(两个算力档),混合分配优于纯 MoE;右:无限记忆区间下 loss 随嵌入槽位数呈 log-linear。
两端失败模式互为印证: 缺少静态记忆、被迫用深度重建固定模式; 丢失条件计算能力、动态推理受损——记忆不能替代计算。右图同时 说明:固定 3B 骨干(激活 568M、训练 100B tokens),把 Engram 槽位从 扫到 (约 +13B 参数),loss 随槽位呈严格 幂律(log-log 线性)——记忆是可预测的缩放旋钮,且同等记忆预算下效率显著优于 OverEncoding 式的直接平均注入[1]。
27B:同参数、同 FLOPs 下的精度提升
四个模型同数据课程、同激活参数(3.8B)、同 262B tokens。Engram-27B 与 MoE-27B 严格 iso-parameter:专家数 72 → 55,腾出的 5.7B 全部变成 Engram 记忆; Engram-40B 进一步把记忆扩到 18.5B,激活预算不变。完整结果见论文 Table 1 (下图为原表截图)[1]:
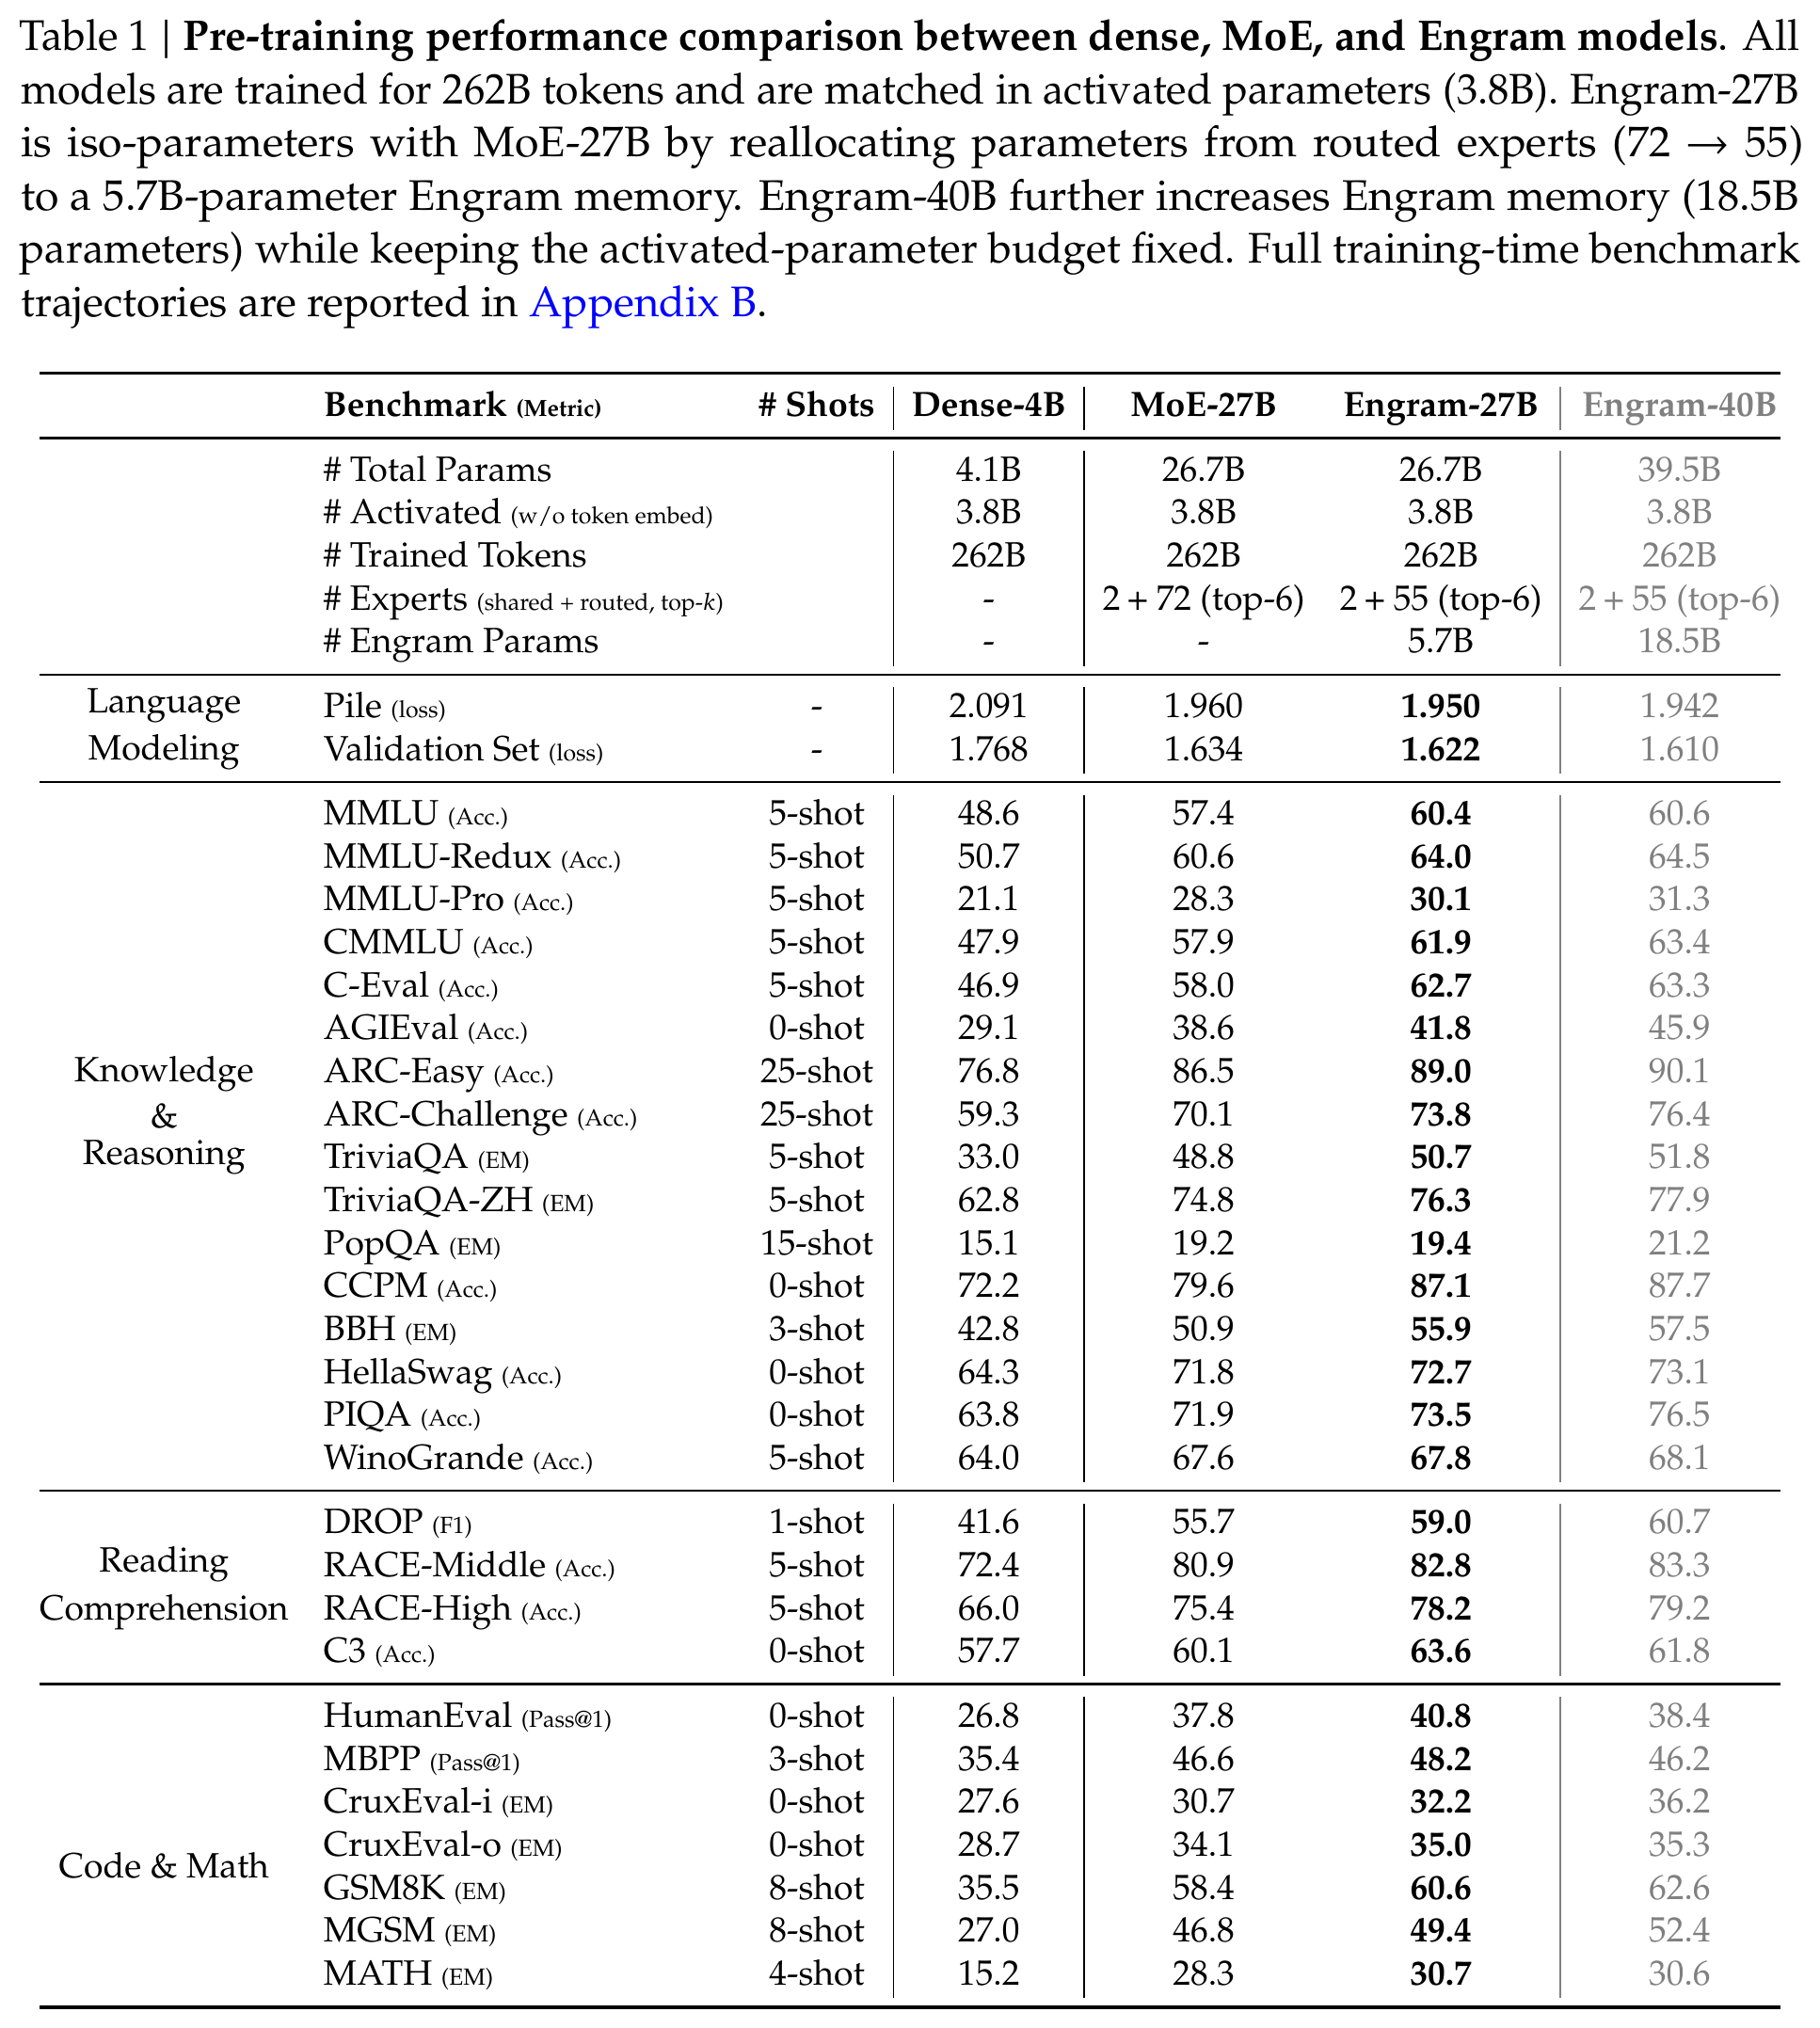
表 1|预训练性能对比(取自论文 Table 1[1],含 Dense-4B / MoE-27B / Engram-27B / Engram-40B 四档)。要点:MMLU 57.4 → 60.4、CMMLU 57.9 → 61.9、 BBH 50.9 → 55.9、ARC-Challenge 70.1 → 73.8、DROP 55.7 → 59.0、 HumanEval 37.8 → 40.8、MATH 28.3 → 30.7、GSM8K 58.4 → 60.6; 验证 loss 1.634 → 1.622。
💡 反直觉的关键观察 增益最大的不是知识检索任务,而是通用推理(BBH +5.0)与代码 / 数学—— 记忆原语改善的是整个网络的表征效率,而不仅仅是"背知识"。 Engram-40B 进一步降低预训练 loss(1.610),但多数基准未全面领先 27B, 论文归因于当前 token 预算下的欠训练(loss 差距到训练末期仍在扩大)[1]。
机理:等效于加深网络
- LogitLens:把每层 hidden state 投影到 LM Head,Engram 变体的逐层 KL 散度 系统性低于 MoE 基线,且浅层差距最大——特征组合完成得更早,更早达到高置信预测。
- CKA 表征对齐(Few-NERD 实体末 token):Engram 模型的层间相似度对角带明显 上移。典型例子:Engram-27B 第 5 层的表征 ≈ MoE 基线第 12 层。
- 解释:显式查找免除了早期层的静态重建,等效增加有效深度;同时把局部依赖 外包给查找,释放注意力容量给全局上下文。
长上下文:注意力容量释放的直接证据
用 YaRN 扩展到 32k 上下文[1]。论文 Table 2 给出多档对比,关键在于iso-loss 与 iso-FLOPs 两种口径下 Engram 都占优:
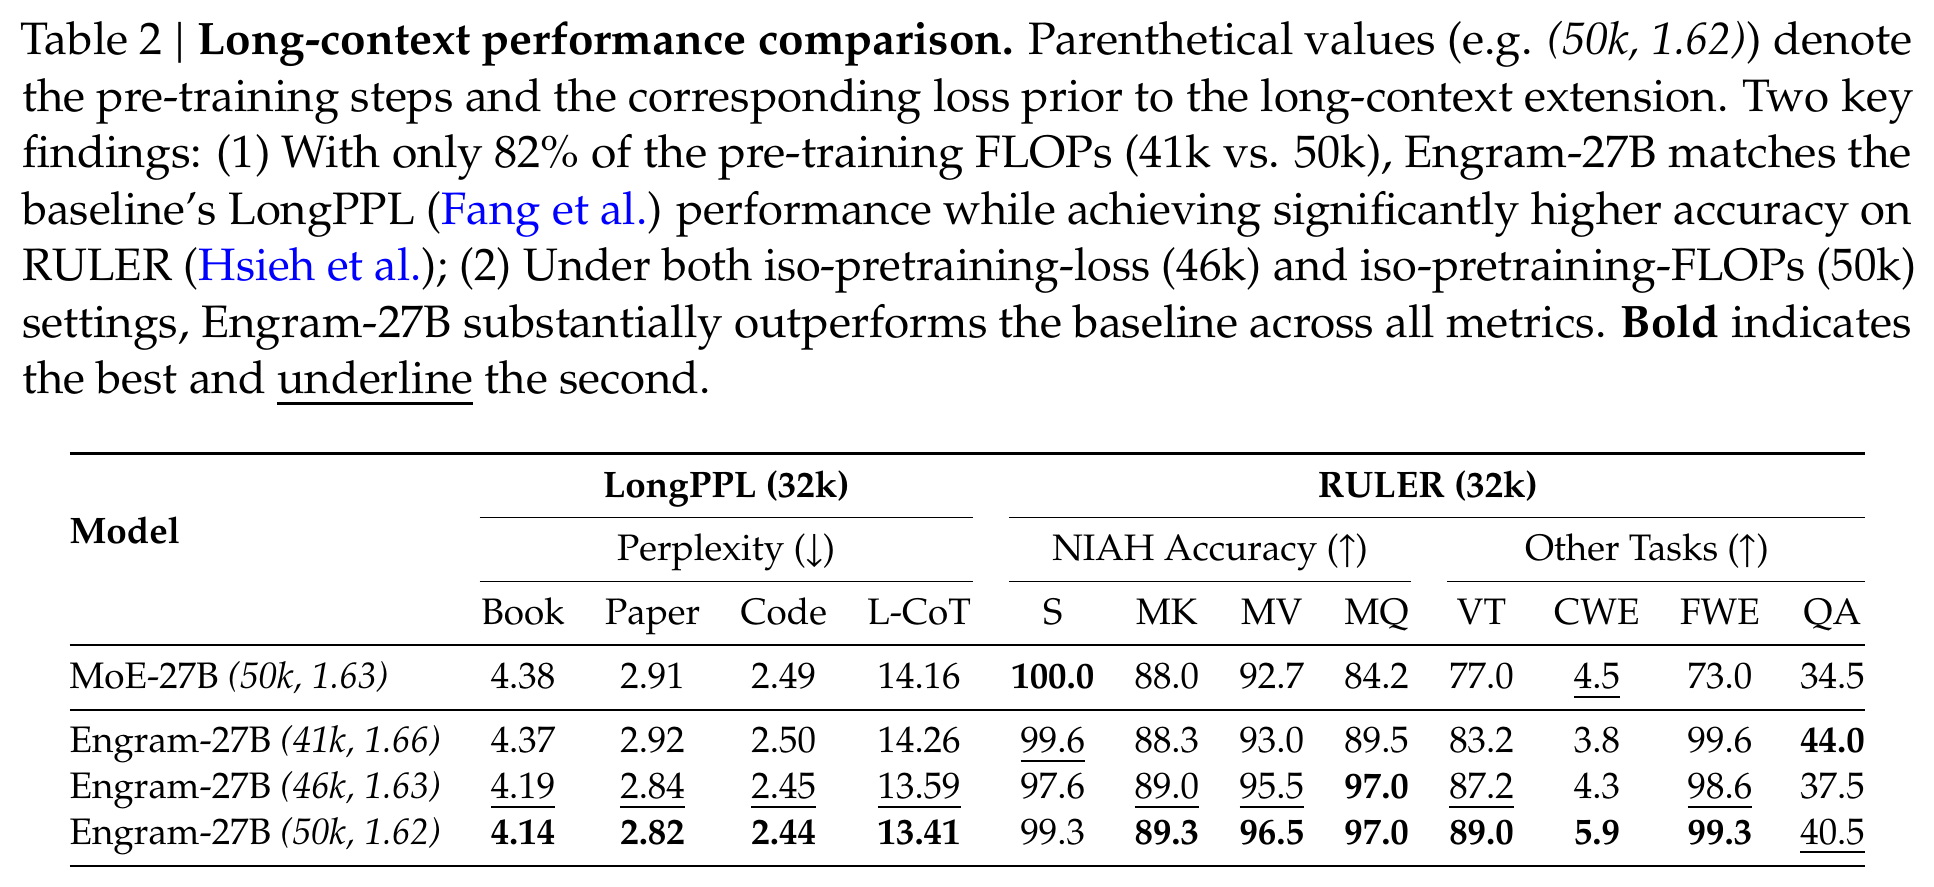
表 2|长上下文性能对比(取自论文 Table 2[1])。iso-loss 口径(46k 步,loss 1.63) 下 Multi-Query NIAH 97.0 vs 84.2、Variable Tracking 87.2 vs 77.0、 FWE 98.6 vs 73.0;即使只用 82% 的训练算力(41k 步,loss 1.66), LongPPL 持平而 RULER 仍全面反超(QA 44.0 vs 34.5)。
这与"局部依赖外包给查找、注意力腾出手处理全局上下文"的假设一致。
消融与敏感性
受控设置:12 层 3B MoE 骨干(激活 0.56B),训练 100B tokens;MoE 基线验证 loss 1.808,固定 1.6B Engram({2,3}-gram,第 2、6 层)降至 1.768(Δ=0.04)[1]。
- 放置位置:单模块层扫描(1→12 层)中第 2 层最佳(1.770),越深越差。 存在权衡——插得早可在骨干消耗深度前卸载局部模式,但过早则 尚未聚合 上下文、门控精度受限。拆成两个小模块放第 2、6 层优于任何单层插入: 兼顾早干预与富上下文门控。
组件重要性(逐项移除,退化从大到小):
- 多分支骨干内的分支特定融合;
- 上下文感知门控;
- Tokenizer 压缩。
轻量卷积仅边际贡献;固定预算下给 4-gram 分配容量略次优(稀释了更高频的 2/3-gram 容量)。
- 推理时完全抑制稀疏嵌入输出:事实知识灾难性崩溃,仅保留 29–44% 原性能 (TriviaQA 仅 29%)——Engram 是参数化知识的主要存储库;阅读理解非常鲁棒, 保留 81–93%(C3 达 93%)——上下文依赖任务主要靠骨干。
- 门控可视化(Engram-27B:mHC × 第 2、15 层 = 每 token 8 个门控标量): 在局部静态模式完成处一致激活——英文多 token 实体 ("Alexander the Great"、"the Milky Way")、套语("By the way")、中文成语 与历史实体("四大发明"、"张仲景")。
后续工作
User as Engram
后续独立工作[3]把条件记忆推向 per-user 个性化记忆:把用户事实写成 Engram 哈希表少量行的局部覆写(约 88 KB/用户),推理技能放在一条跨用户共享的 LoRA 中。因 DeepSeek 未放出 Engram 训练权重,作者基于 nanochat 骨干自训 4 个 Mini-Engram(178M–1.22B,共享 51.2M 哈希表,单卡 Blackwell), 在缩小约两个数量级的尺度上复现并细化了本笔记的多处结论[3]。
独立复现两大签名发现(原论文分别以敏感性实验与 LogitLens 观察到):
- 抑制 Engram 查找对事实问答的伤害远大于阅读理解(敏感性不对称), 幅度按模型/语料规模缩小约 10 倍,与预期一致;
- LogitLens 显示 Engram 模型比稠密孪生更早解析出预测——有效深度 前移在 nano 尺度同样成立。
"编辑函数" vs "写入地址"的精确量化(d20@1536,20 用户, 无关文本 val bpb 变化):
| 写入方式 | Δbpb | 受损用户 |
|---|---|---|
| per-user LoRA(rank-64, Q/K/V) | +1.784(用户范围 +0.44~+3.74) | 17/20 |
| per-user Engram 行 | +0.00005 | 0/20 |
相差约 33,000 倍(3 seed 均值)。玻璃盒验证:写入后 trigger 位置的门控 α 从 0.02 升至 0.99、非 trigger 位置保持 ≤0.04;全部 16 条测试事实在非 trigger 位置、所有层的残差变化严格为 0(逐位不变)——局部性是地址化 存储的架构性质,不是训练出的近似。
两个新约束:
- 推理时注入的事实必须写在深层查找:同一批行写进浅层查找,召回从 ~100% 跌至约 1/4(编辑离输出太远,会被上层重算)。这与预训练放置偏浅 (原论文消融中第 2 层最佳)是两种场景的不同最优:预训练要早卸载局部 模式,事后写入要靠近输出。
- 门控会匹配、不会组合:两条事实各自召回 99.2%,但需要真正串联时 top-1 从 90.6%(问题尾词恰好命中第二条 trigger)跌至 12.9%(真组合); 单用户 1000 条事实时 top-1 仅 35%,而逐事实独立写入无上限(≥0.98)—— 密度上限源于共激活行的前向干涉,不是哈希碰撞。记忆存不下组合推理, 是「记忆不能替代计算」的又一注脚。
分层架构:内容进表、技能共享。per-user Engram(内容)+ 单条共享 LoRA(技能)对阵 per-user LoRA(20 用户,d20)[3]:
| 指标 | 分层设计 | per-user LoRA |
|---|---|---|
| 直接召回 top-1 | 100% | 99% |
| 间接推理 indirect_any | 44%(3 seed 均值 41%) | 6%(均值 7%) |
| 无关文本 Δbpb | +0.386(全部来自共享技能) | +1.784 |
| 变差的用户 | 0/20 | 17/20 |
| 每用户存储 | 88 KB | 14.2 MB(约 161 倍) |
知识库规模对决检索:分层设计的 44% 不随 KB 规模变化;检索 top-3 召回从 KB=34 的 62% 崩至 KB=1000 的 9%,Qwen2.5-3B-Instruct (约 2.5 倍大)+RAG 在 KB≥100 后被分层设计反超。LOCOMO 分类上, Engram 写入在 single/multi-hop 与 reasoning 全胜检索基线 (multi-hop 最高 +178%),open-domain 反输约 53%——逐字长句无法由 单 token 偏置重建,仍需检索承担。
系统面:约 50 行的多租户服务器在 d12@1280 上服务 100 用户/100 事实 时仍达 226 req/s(租户增至 3 倍吞吐仅降 3%),行覆写应用 0.03 ms(p50)—— 确定性寻址 + 行级覆写让多租户隔离成为一次数组赋值。
该工作可视为条件记忆范式的第一次外部压力测试:局部性、可组合性、 可解释性全部兑现,同时把"记忆 ≠ 推理"的边界量化成了具体数字。
设计取舍与解读
- 记忆与计算的分界是学出来的,不是写死的:门控决定"这一步该查表还是该算", 门控行为的可视化与抑制实验(见原论文 §6.3)证实模型确实把事实知识放进了表里。
- 放置位置是建模与系统的联合约束:建模偏好早干预(第 2 层附近), 系统希望插入更深以延长延迟掩盖窗口——最终用"拆分多模块"同时满足两边, 这也是后续部署(如 V4.1-Flash 放第 1、14 层)的配平逻辑。
- 与 RAG 的区别:Engram 是参数内、可训练、O(1) 且无外部语料依赖的查找, 面向的是"局部、静态、高频"的语言模式;外部知识仍需检索系统承担。
- 用深度换检索:让底层不再做静态重建,等效于把有限深度"花在刀刃上" ——这是理解条件记忆收益的关键视角。
参考文献
[1] CHENG X, TIAN R, ZENG W, et al. Conditional memory via scalable lookup: a new axis of sparsity for large language models[J/OL]. arXiv preprint arXiv:2601.07372, 2026. https://arxiv.org/abs/2601.07372.
[2] GHANDEHARIOUN A, CACIULARU A, PEARCE A, et al. Patchscopes: a unifying framework for inspecting hidden representations of language models[C/OL]//Proceedings of the 41st International Conference on Machine Learning. PMLR, 2024: 15466-15490. https://arxiv.org/abs/2401.06102.
[3] LI B. User as engram: internalizing per-user memory as local parametric edits[J/OL]. arXiv preprint arXiv:2606.19172, 2026. https://arxiv.org/abs/2606.19172.
[4] DEEPSEEK-AI. Engram: official implementation of conditional memory via scalable lookup[CP/OL]. 2026. https://github.com/deepseek-ai/Engram.
[5] TITO SVENSTRUP D, HANSEN J M, WINTHER O. Hash embeddings for efficient word representations[C/OL]//Advances in Neural Information Processing Systems: vol. 30. 2017. https://arxiv.org/abs/1709.03933.
[6] XIE Z, WEI Y, CAO H, et al. mHC: manifold-constrained hyper-connections[J/OL]. arXiv preprint arXiv:2512.24880, 2025. https://arxiv.org/abs/2512.24880.
© 2026 Yang Huan · yanghuan9812@qq.com