Spark-X2.5 架构(4B / 1.7B)
权重与实现:
XHToken/Spark-X2.5-4B[1] 与-1.7B[2], Apache-2.0 开源。官方没有技术报告,本页的结构结论全部出自随权重发布的两类文件:config.json与modeling_spark.py[3] /configuration_spark.py[4]。 训练口径(约 20 万亿 token 预训练、长上下文阶段把序列扩到 1M、SFT → 多域 RL → MOPD 合并) 只出现在模型卡与官方博客 [5],没有算法细节,本页不复述、也不采信。
Spark-X2.5-4B / 1.7B 是科大讯飞全资子公司词元星火(XHToken) 2026-09-01 开源的 端侧通用语言模型,卖点是"端侧原生百万 token 上下文"与 agent / 代码能力。 从代码看,它的架构可以一句话概括:一个标准的 GQA 解码器,把每 4 层里的 1 层换成 全注意力、其余 3 层换成滑窗注意力,再给每个注意力头加一个输出门控。
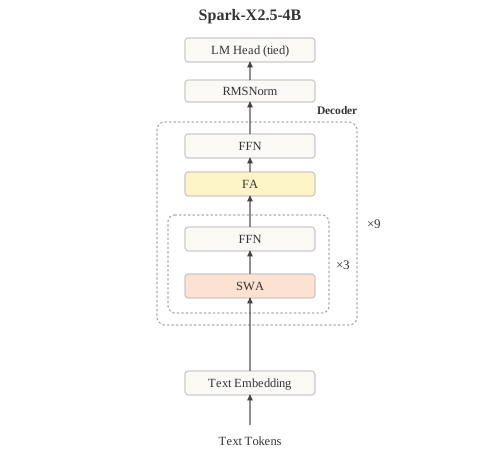
图 1|Spark-X2.5-4B 逐层架构(本图为根据
config.json与modeling_spark.py自行绘制,非论文原图)。方向自下而上为前向:Embedding → 9 个「3 层滑窗 + 1 层全 注意力」的周期 → 最终 RMSNorm → tied LM Head。实线色块表示 SWA、FA、FFN 等模块, 内层虚线框与 ×3 表示滑窗层组重复 3 次,外层虚线框与 ×9 表示整个周期重复 9 次; 灰底 FFN 全部为 dense。
1. 配置总览
| 配置项 | 4B | 1.7B |
|---|---|---|
hidden_size |
2560 | 2048 |
num_hidden_layers |
36 | 28 |
layer_types |
3 ×sliding + 1 ×full,重复 9 次 |
同构,重复 7 次 |
num_attention_heads |
16 | 8 |
num_key_value_heads |
4 | 2 |
head_dim |
256 | 256 |
headwise_attn_output_gate |
true(sigmoid) |
true(sigmoid) |
intermediate_size |
10240 | 6656 |
hidden_act |
gelu |
gelu |
sliding_window |
512 | 512 |
max_position_embeddings |
1 048 576 | 1 048 576 |
vocab_size |
131072 | 131072 |
tie_word_embeddings |
true |
true |
dtype |
bfloat16 |
bfloat16 |
一个容易忽略的点:head_dim 固定 256,与 hidden_size 不成整除关系。 4B 的 16 个 Q 头投影出 维,比 hidden 的 2560 还宽; 1.7B 则是 ,恰好等于 hidden。也就是说 4B 的注意力分支 相对更"宽",参数预算更多压在注意力和 KV 上。
2. 混合注意力:1 层全注意力 + 3 层滑窗
layer_types 是 config 里显式列出的 36 / 28 项数组,形如
sliding, sliding, sliding, full 循环 [1]。解码层按它在构造期决定自己用不用滑窗:
Spark2_5DecoderLayer.__init__读config.layer_types[layer_idx], 若为sliding_attention就把config.sliding_window(512)写进该层的 attention, 否则置None;同时按层型取对应的partial_rotary_factor[3];Spark2_5Model.forward为两种层型各建一套 mask:全注意力用create_causal_mask,滑窗层用create_sliding_window_causal_mask, 再按层型分发 [3]。
融合 QKV 单投影"] N1 --> G["g_proj
→ num_heads 维"] QKV --> R["RoPE
按层型选 θ 与旋转比例"] R --> A["Attention
full / sliding mask"] G --> S["sigmoid"] A --> M["⊙ 逐头输出门控"] S --> M M --> O[out_proj] O --> R1["+ residual"] X --> R1 R1 --> N2[RMSNorm] N2 --> MLP["MLP(GeGLU)"] MLP --> R2["+ residual"] R1 --> R2
图 1|Spark-X2.5 单个 decoder layer 的数据流(据
modeling_spark.py绘制)[3]。
这里的关键不是"用了滑窗"(Gemma 系列早就在用),而是层型配比决定了 KV cache 的 增长层数:只有 1/4 的层会随序列线性增长,其余层的 KV 被封在 512 token 以内。 下一节的量化估算会看到,这正好对应官方宣称的"约为传统全局注意力模型的四分之一"。
3. 逐头输出门控(head-wise output gate)
注意力部分最"非标准"的设计是输出门控。Q / K / V 由一个融合投影
q_k_v_proj 一次算出(输出维 ),
另外用一个 的 g_proj 产出每个头一个标量的门控分数 [3]:
式 1|逐头输出门控:门控分数经
sigmoid后按头广播,乘在注意力输出上 [3]。
- 门控是逐头的(),不是逐维、也不是整层一个标量;
- 计算时把注意力输出与门控都升到 fp32 再相乘,最后回落到权重 dtype [3];
- 代码里
gate_attn_act_mode还支持silu,但两个开源的 checkpoint 都用sigmoid[1]。
这个设计与 Qwen3.5 的 attn_output_gate 是同类思路(都把门控做在注意力输出端),
但实现位置不同:Qwen3.5 把门控拼在 q_proj 的双倍输出里,Spark-X2.5 用独立的 g_proj。
4. 分层 RoPE:两套位置编码参数
同一个模型里,全注意力层和滑窗层用不同的 RoPE 配置,这是 Spark-X2.5 把 1M 上下文和端侧效率捏在一起的关键一手 [4]:
| 层型 | rope_theta |
partial_rotary_factor |
实际旋转维度 |
|---|---|---|---|
full_attention |
5 000 000 | 0.25 | head_dim 的前 64 维 |
sliding_attention |
10 000 | 1.0 | 全部 256 维 |
- 全注意力层要覆盖 1M token 的长程依赖,所以把基频抬到 (低频 → 衰减更慢 → 远距离位置仍可区分);滑窗层只有 512 的视野,用常规 就够。
- 只有 1/4 的维度做旋转(64 / 256),剩下 192 维不施加位置编码(相当于 NoPE)。 这是长上下文模型里常见的取舍——把位置信息集中在少数维度,给其余维度留出 与位置无关的表达空间。
Spark2_5Model.forward在每次前向开头按层型各算一组cos/sin缓存起来复用 (compute_rope_cos_sin),而不是每层重算 [3]。
5. 其余组件
- 归一化:
Spark2_5RMSNorm,计算时升到 fp32,再乘回权重并落回原 dtype [3]。 注意没有 QK-Norm——这是它与 Qwen3.5、Gemma4 的一个直接区别。 - MLP:
down( gelu(gate(x)) * up(x) ),即 GeGLU(门控型,激活是 GELU 而非 SwiGLU 的 SiLU)[3]。attention_bias与mlp_bias均为false。 - 权重共享:
tie_word_embeddings = true,LM head 直接用 embedding 矩阵做 线性变换(F.linear(hidden, embedding.weight))[3]。 - embedding 精度:输入 embedding 取出后立刻转 fp32 参与主干计算 [3]。
6. 参数与 KV Cache 估算
参数量(4B,tied,bf16 权重不计 embedding 两次):
| 部件 | 计算 | 参数量 |
|---|---|---|
| 每层注意力 | + + | ≈ 26.3 M |
| 每层 MLP | ≈ 78.6 M | |
| 每层合计 | ≈ 104.9 M | |
| 36 层 | ≈ 3.77 B | |
| embedding(与 LM head 共享) | ≈ 0.34 B | |
| 合计 | ≈ 4.11 B |
与 "4B" 的命名吻合。同理 1.7B 约为 B。
KV Cache(bf16;每个 token 每层 = 2 × 4 个 KV 头 × 256 维 × 2 B(bf16)= 4 KB):
| 项 | 计算 | 大小 |
|---|---|---|
| 9 层全注意力(1M token) | ≈ 36.9 GB | |
| 27 层滑窗(封顶 512) | ≈ 56.6 MB | |
| 假设 36 层全为全注意力 | ≈ 147 GB | |
| 比值 | = 1 / 4 |
1.7B 同理:每 token 每层 2 KB,7 层全注意力在 1M 下约 14 GB。
两点解读:
- 因为全注意力层恰好占 1/4,KV cache 也约等于全注意力版本的 1/4—— 这正是官方"约为传统全局注意力模型四分之一"说法的出处(此处为该口径的 理论下界,未计显存碎片、并行切分等开销)。
- 1M 上下文仍然很贵:即便砍到 1/4,4B 在 1M token 下也要约 37 GB 的 KV。
官方 SGLang 部署示例把
--context-length 1048576标成"需要充足显存、 必要时调低",说的就是这件事 [5]。
7. 与 Qwen3.5 / Gemma4 的差异
本页只做结构判断,横向细节见 分类首页, 这里只记三条与 Spark-X2.5 直接相关的结论:
- 廉价层选择不同:Spark-X2.5 用滑窗注意力(缓存有界但非零), Qwen3.5 用门控 Delta 线性注意力(缓存与序列长度无关), Gemma4 也用滑窗(窗口 1024,比 Spark 的 512 宽一倍)。
- 省 KV 的手段不同:Spark-X2.5 只"减层数";Gemma4 在减层数之外, 还把全注意力层压成 1 个 KV 头 + K/V 共享投影,KV 更小但单层表达更受限。
- 模态不同:Spark-X2.5 是纯文本;Qwen3.5 / Gemma4 的参数量里含 视觉(和音频)塔,因此"同尺寸"并不等于同算力预算。
8. 开源实现位置(均 pin 到 commit)
模型代码随权重发布在 Hugging Face 仓库,commit 0bcb356(4B)/
14d6e83(1.7B);框架侧的 transformers 通过 auto_map 加载 [1]。
| 组件 | 代码位置 |
|---|---|
| 融合 QKV + 门控投影 | modeling_spark.py#L152-L155 |
| 逐头 sigmoid 门控 | modeling_spark.py#L198-L206 |
| 按层型设置滑窗 / 旋转比例 | modeling_spark.py#L224-L229 |
| 两套 attention mask | modeling_spark.py#L355-L359 |
| 按层型构建 RoPE 缓存 | modeling_spark.py#L369-L374 |
| RMSNorm(fp32) | modeling_spark.py#L96-L107 |
| GeGLU MLP | modeling_spark.py#L116-L132 |
| tied embedding 输出 | modeling_spark.py#L464-L466 |
| RoPE θ / 旋转比例读取 | configuration_spark.py#L109-L115 |
| 层型 / 滑窗 / RoPE 配置 | config.json |
生态侧,llama.cpp 的 PR #27868 为 Spark2_5ForCausalLM 加了 GGUF 转换与推理图,
并在描述里明确列出了本页提到的全部特征:融合 QKV、逐头 sigmoid 门控、
滑窗与全注意力混合、按层型区分的 RoPE 维度与基频 [6]。
这份 PR 是核对架构的一份独立旁证。
参考文献
[1] XHToken. Spark-X2.5-4B model card[EB/OL]. (2026-09-01)[2026-10-11]. https://huggingface.co/XHToken/Spark-X2.5-4B/tree/0bcb35678590218655dff3765b9e61c83b35e9c4.
[2] XHToken. Spark-X2.5-1.7B model card[EB/OL]. (2026-09-01)[2026-10-11]. https://huggingface.co/XHToken/Spark-X2.5-1.7B/tree/14d6e83c13c7add2b62a7c39b2131f4ed1cddcf8.
[3] XHToken. modeling_spark.py (Spark-X2.5-4B)[EB/OL]. (2026)[2026-10-11]. https://huggingface.co/XHToken/Spark-X2.5-4B/blob/0bcb35678590218655dff3765b9e61c83b35e9c4/modeling_spark.py.
[4] XHToken. configuration_spark.py (Spark-X2.5-4B)[EB/OL]. (2026)[2026-10-11]. https://huggingface.co/XHToken/Spark-X2.5-4B/blob/0bcb35678590218655dff3765b9e61c83b35e9c4/configuration_spark.py.
[5] XHToken (SparkLLM Team). Spark-X2.5 4B&1.7B: pushing the limits of agentic capabilities in on-device models[EB/OL]. (2026-09-01)[2026-10-11]. https://github.com/XHToken/Spark-X2.5.
[6] ggml-org. llama.cpp: [Model] support for Spark2_5ForCausalLM implementation[EB/OL]. (2026)[2026-10-11]. https://github.com/ggml-org/llama.cpp/pull/27868.
© 2026 Yang Huan · yanghuan9812@qq.com