RKNPU:Rockchip NPU 架构与编程模型
RKNPU 是 Rockchip 随 RK3588 / RK3576 等 SoC 提供的神经网络加速单元,
在器件树与内核驱动里以 rknpu / rknn 命名。它源自 NVIDIA 开源的
NVDLA(Deep Learning Accelerator)数据通路,是一台定点/浮点卷积引擎,
而不是通用矩阵单元:没有 matmul 原语,一次矩阵乘要表达成 卷积[1]。
本专题分四篇:
- 硬件架构:块流水线(CNA→CORE→DPU)、寄存器映射、 CBUF 与累加器、数据类型、三核与 IOVA;
- 块内部结构:cube 布局、CNA 的两个加载器与权重解压、 CORE 的 MAC/CACC、DPU 的 SDP 流水与 LUT、PPU、DMA 仲裁;
- 编程架构:PC/regcmd 任务模型、ping-pong 寄存器组、
mainline
rocket的 uAPI、matmul-as-1×1-conv 与 tile 切分; - 软件栈与仓库定位:完整 FOSS/BSP 软件栈,以及 rockchip-npu-notes 为何是"面向编程的硬件参考"而非编程接口。
本专题基于 Greg Ordinary 的逆向工程笔记
rockchip-npu-notes[1]
整理。该笔记由 AI 协助撰写,作者声明不保证准确性,多数结论标注了证据等级
([HW sweep] 实机扫描 / [source-confirmed] 开源源码印证 / [TRM] 手册)。
本文只在有源码或实测支撑处下判断,并保留其证据标签。
一张图看懂三核架构
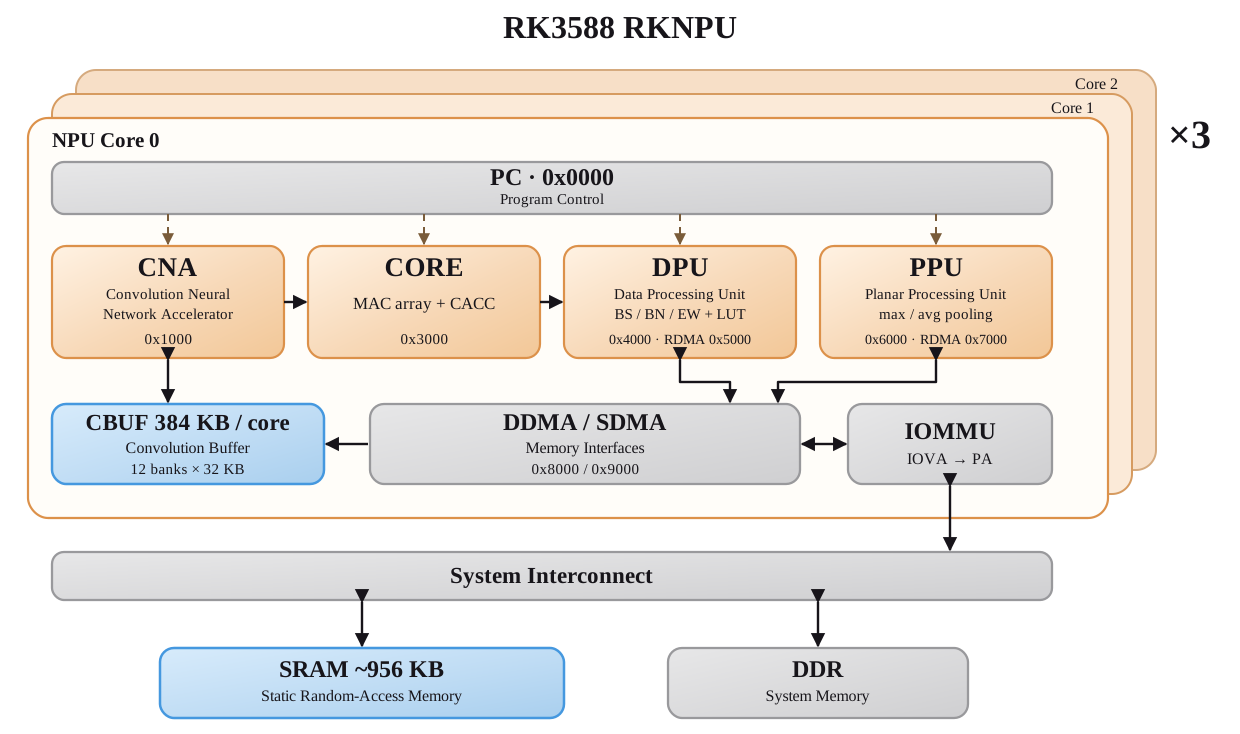
图 1|RK3588 RKNPU 三核架构。前景展开一个核,后方两层错位框与 ×3 表示三核复制。 每核包含 PC、CNA→CORE→DPU 卷积 / 矩阵乘通路、独立的 PPU 池化通路,以及 384 KB CBUF(12 banks × 32 KB);内存接口与 IOMMU 以简化连接表示。 DDR 和约 956 KB 的系统 SRAM 位于核框外,SRAM 的使用取决于系统分配与驱动支持[1]。
这张图够全面吗?三处要修正
原图(本页初稿)覆盖了主干,但用于"介绍 RKNPU 架构"时有一处全称错误、一处职责 错误、若干缺项,已在图 1 中修正:
| 位置 | 原图 | 修正 |
|---|---|---|
| CNA 全称 | Convolution Network Accelerator |
Convolution Neural Network Accelerator(漏了 Neural)——见下节 |
| CORE 职责 | output size / format unit |
MAC 阵列 + CACC 累加器(INT34 / INT48 / FP44);输出尺寸由 CNA 几何寄存器与 DPU 写出共同决定 |
| 片上内存 | 泛称 SRAM / L2 |
每核 staging 是 CBUF(12 × 32 KB = 384 KB);约 956 KB 片上 SRAM 是厂商独占路径,不是 CPU 侧 L2 |
还缺的内容(图 1 已补进一部分,其余在正文展开):
- PPU-RDMA(0x7000) 与 DPU-RDMA(0x5000) 两个读 DMA 块;
- 各块寄存器基址(PC
0x0/ CNA0x1/ CORE0x3/ DPU0x4/ DPU-RDMA0x5/ PPU0x6/ PPU-RDMA0x7/ DDMA0x8/ SDMA0x9); - 三核复制(图 1 以错位叠框与 ×3 表示);
- DPU 内部的 BS / BN / EW 仿射级与 LUT;
- 累加器宽度(int8→INT34、int16→INT48、fp16→FP44/48);
- 没有 matmul 原语,矩阵乘只能降级为 卷积;
- DDR 只是外部系统内存,NPU 通过 IOMMU/IOVA 访问,而非直连。
不随核复制。三核在 device tree 里表现为 npu@fdab0000、npu@fdac0000、
npu@fdad0000 三个节点[1];mainline 驱动下
一个 fd 只能绑定一个核,要用满三核需开 3 个及以上 fd[1]。
CNA 的全称是什么
CNA = Convolution Neural Network Accelerator(卷积神经网络加速器)。
Linux 内核的器件树绑定(rockchip,rk3588-rknn-core.yaml)把它明确列为
reg-names 的 cna,注释即 "Convolution Neural Network Accelerator
registers"[2];部分中文资料写作 "Convolutional Neural Network Accelerator"
(多一个 -al),指同一单元。原图写的 Convolution Network Accelerator
漏了 Neural,是不完整的。
CNA 是"卷积通道"的总称:它把输入特征(feature)与权重(weight)从 DDR 搬进 每核的 CBUF,并驱动随后的 MAC 阵列;卷积 / 矩阵乘的几何参数(H/W/C 与 stride、 pad)在 CNA 的寄存器里配置[1][3]。真正做乘加与宽位累加的是相邻的 CORE。
先记住这几条
- NVDLA 派生,不是自研 ISA。 块、缓冲区、流水级与寄存器组织都能在 NVDLA 文档里找到对应;若干关键字段则是 Rockchip 追加(如 PC 命令块、反卷积模式)[1]。
- 卷积引擎,无 matmul。 按 卷积执行: K 变成输入通道、N 变成输出通道、M 变成空间高度[1][3]。
- 命令 = 内存里的一段 regcmd。 硬件层(hardware layer)不是 CPU 逐条写寄存器,
而是 PC 块从内存流式读取
NPUOP(op, value, reg)命令字[1]。 - 3 核独立。 每个核有自己的 CBUF 与调度;
rocket下按 fd 绑定核[1]。 - 性能不在 MAC 上。 在
rocket路径、600 MHz、权重常驻的工作点,matmul 只有 ~460 GOP/s(约 fp16 峰值的 15%),受 DMA 与派发限制,所以量化省的是内存而非时间[1]。
本专题页面
| 页面 | 主题 |
|---|---|
| RKNPU 硬件架构 | 块流水线与 NVDLA 血缘、寄存器映射、CBUF、累加器、数据类型、三核 |
| RKNPU 块内部结构 | cube 布局、CNA/DCOMP、CORE MAC/CACC、DPU SDP 流水与 LUT、PPU、DMA |
| RKNPU 编程架构 | PC/regcmd 任务模型、ping-pong、rocket uAPI、matmul-as-1×1-conv 与 tiling |
| RKNPU 软件栈与仓库定位 | FOSS/BSP 软件栈、rockchip-npu-notes 的"面向编程的硬件参考"定位 |
参考文献
[1] GREGORDINARY. Rockchip NPU reverse-engineering notes[EB/OL]. (2026)[2026-10-09]. https://github.com/gregordinary/rockchip-npu-notes/tree/81b0d17da0b8a472c1a1e6f7d2ddba6b34d10111
[2] VIZOSO T. dt-bindings: npu: rockchip,rk3588-rknn-core.yaml[EB/OL]. Linux kernel, (2026)[2026-10-09]. https://github.com/torvalds/linux/blob/6c377d19d4a5116d9bec5203aa3c6c11523e7898/Documentation/devicetree/bindings/npu/rockchip,rk3588-rknn-core.yaml#L32
[3] GREGORDINARY. rocket-userspace: include/npu_hw.h[EB/OL]. (2026)[2026-10-09]. https://github.com/gregordinary/rocket-userspace/blob/f86cf52c666b4eddadc17d80d6c558b4067c0d6b/include/npu_hw.h#L25-L33
© 2026 Yang Huan · yanghuan9812@qq.com