Gemma4-12B 架构
权重与配置:
google/gemma-4-12B-it[1]。 实现见 transformers 的modeling_gemma4.py[2] 与configuration_gemma4.py[3]。 无技术报告;本页结论均出自config.json与框架源码(已 pin commit)。
Gemma4-12B 是 text + vision + audio 的 unified 模型
(Gemma4UnifiedForConditionalGeneration)。它的文本主干延续 Gemma 系列的
局部 : 全局 = 5 : 1 比例,但"全局"(全注意力)层被压得比同类都狠:
只有 1 个 KV 头,而且 K 与 V 共用同一个投影。
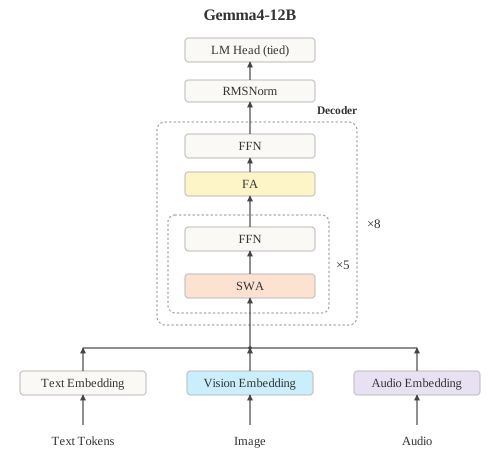
图 1|Gemma4-12B 文本主干逐层架构(本图为根据
config.json与modeling_gemma4.py自行绘制,非论文原图)。方向自下而上为前向;每 5 层 滑窗注意力(蓝)接 1 层全注意力(黄),重复 8 次;灰底卡片为 dense FFN。 右侧另列多模态输入分支。注意 12B 是稠密模型,Gemma4 家族的 E4B / E2B 才是 MoE 变体。
1. 配置总览(文本主干)
| 配置项 | 取值 |
|---|---|
hidden_size |
3840 |
num_hidden_layers |
48 |
layer_types |
5 ×sliding_attention + 1 ×full_attention,重复 8 次 |
| 滑窗层 | 16 Q / 8 KV 头(GQA 2×),head_dim 256,窗口 1024 |
| 全局层 | 16 Q / 1 KV 头,global_head_dim 512,K ≡ V |
hidden_activation / intermediate_size |
gelu_pytorch_tanh / 15360 |
| 归一化 | q / k RMSNorm(head_dim 上)+ 无参 v_norm |
| 位置编码 | 分层:全局 θ=1e6、rope_type proportional、partial 0.25;滑窗 θ=1e4 |
max_position_embeddings |
262 144 |
vocab_size / tie_word_embeddings |
262 144 / true |
final_logit_softcapping |
30 |
| MoE | enable_moe_block = false(12B 稠密)、num_kv_shared_layers = 0 |
| 视觉 / 音频 | patch 16、280 soft token、3×3 pooling / 嵌入 640 维、每 token 640 采样 |
2. 5 : 1 的局部 : 全局比例
48 层里只有 8 层是全注意力(约 17%),其余 40 层是窗口 1024 的滑窗注意力。
这个 sliding_window_pattern = 6 的比例来自 Gemma3 的配置默认值
(configuration_gemma3.py 里 sliding_window_pattern 默认 6)[4],
Gemma4 只是把窗口从 4096 缩到 1024 [1]。
比例更激进的好处是 KV cache 随序列增长的部分只有 8 / 48 层;代价是长程依赖 全部压在这 8 层上——所以它们的设计必须省得更狠,见下一节。
3. 全注意力层:减头数 + K≡V
Gemma4TextAttention 用 config.per_layer_config[layer_idx] 取本层的
head_dim 与 num_key_value_heads,于是两类层拿到不同的头配置 [2]:
| 滑窗层 | 全局(全注意力)层 | |
|---|---|---|
head_dim |
256 | 512(global_head_dim) |
| KV 头数 | 8 | 1(num_global_key_value_heads) |
| V 投影 | 独立 v_proj |
不建,直接用 key 当 value |
per_layer_config 的构造只对 full_attention 层做覆盖
(configuration_gemma4.py 里按 layer_type == "full_attention" 生成),
且 KV 头的覆盖由 attention_k_eq_v 开关控制 [3]。
代码层面 K ≡ V 是这样落地的:use_alternative_attention = attention_k_eq_v and
not self.is_sliding,为真时 self.v_proj 干脆不创建;前向里
value_states = ... if self.v_proj is not None else key_states [2]。
所以全局层的 KV cache 每 token 每个这种层只有 1 个头 × 512 维,
比"16 头 × 512 维"的全注意力小一个数量级——这是 Gemma4 在 5 : 1 比例下
仍能撑住长上下文的关键。
另外 num_kv_shared_layers = 0 [1],即没有启用 Gemma4 里那套
"后续层复用前层 KV"的机制;代码里保留的 is_kv_shared_layer /
store_full_length_kv 分支在当前 checkpoint 上不生效 [2]。
4. 归一化与位置编码
- q / k RMSNorm 作用在
head_dim上(不是 hidden 维),并且每个 KV 头也 有独立的v_norm——后者是无参数的 RMSNorm(with_scale=False), 只做幅度归一化、不学习缩放 [2]。 - RoPE 分层:全局层用 θ=1e6 且
rope_type = proportional、partial_rotary_factor = 0.25(512 维里只旋转 128 维);滑窗层用默认 θ=1e4 的全旋转 [1]。这与 Spark-X2.5 的分层思路一致,只是具体数值不同。 - 输出端 softcap:logits 先除以 30、取 tanh、再乘回 30
(
final_logit_softcapping),限制 logit 幅度 [1][2]。
5. 多模态分支(unified)
视觉侧是 patch 16 的编码器,经 3×3 pooling 压成 280 个 soft token,
mm_embed_dim 3840 与文本主干对齐;音频侧嵌入 640 维、每 token 对应 640 个采样点 [1]。
use_bidirectional_attention = "vision" 表示视觉 token 走双向注意力、
文本 token 保持因果 [1][3]——这一点在 Gemma4TextAttention 里体现为
is_causal = use_bidirectional_attention != "all" [2]。
6. 开源实现位置(pin 到 commit)
transformers commit 536ecc0:
| 组件 | 代码位置 |
|---|---|
Gemma4TextAttention 定义 |
modeling_gemma4.py#L1151 |
按层取 head_dim / KV 头 |
modeling_gemma4.py#L1162-L1163 |
use_alternative_attention(K≡V 开关) |
modeling_gemma4.py#L1164 |
| q / k / v RMSNorm | modeling_gemma4.py#L1181-L1186 |
全局层不建 v_proj |
modeling_gemma4.py#L1188-L1196 |
| V 取 K(K ≡ V) | modeling_gemma4.py#L1232 |
final_logit_softcapping |
modeling_gemma4.py#L1853-L1856 |
per_layer_config 构造 |
configuration_gemma4.py#L210-L223 |
sliding_window_pattern 默认 6(Gemma3) |
configuration_gemma3.py#L106-L111 |
参考文献
[1] Google DeepMind. Gemma 4 12B IT model card[EB/OL]. (2026)[2026-10-11]. https://huggingface.co/google/gemma-4-12B-it/tree/707f0a3b8a3c7ad586ed01e27eafbad8a27dd0f7.
[2] Hugging Face. transformers: modeling_gemma4.py[EB/OL]. (2026)[2026-10-11]. https://github.com/huggingface/transformers/blob/536ecc007387a50e77603bb5d92100e9b07514cc/src/transformers/models/gemma4/modeling_gemma4.py.
[3] Hugging Face. transformers: configuration_gemma4.py[EB/OL]. (2026)[2026-10-11]. https://github.com/huggingface/transformers/blob/536ecc007387a50e77603bb5d92100e9b07514cc/src/transformers/models/gemma4/configuration_gemma4.py.
[4] Hugging Face. transformers: configuration_gemma3.py[EB/OL]. (2026)[2026-10-11]. https://github.com/huggingface/transformers/blob/536ecc007387a50e77603bb5d92100e9b07514cc/src/transformers/models/gemma3/configuration_gemma3.py.
© 2026 Yang Huan · yanghuan9812@qq.com