Qwen3.5-4B 架构
权重与配置:
Qwen/Qwen3.5-4B[1]。 实现代码不在 HF 仓库里,随transformers发布,见modeling_qwen3_5.py[2]。 同样没有技术报告,本页结论均出自config.json与框架源码(已 pin commit)。
Qwen3.5-4B 是多模态模型(Qwen3_5ForConditionalGeneration):一条文本主干
加一个视觉塔。文本主干是标准的 3 : 1 混合结构,但"廉价层"用的不是滑窗注意力,
而是 Gated DeltaNet 线性注意力——这一点与 Spark-X2.5 / Gemma4 分道扬镳。
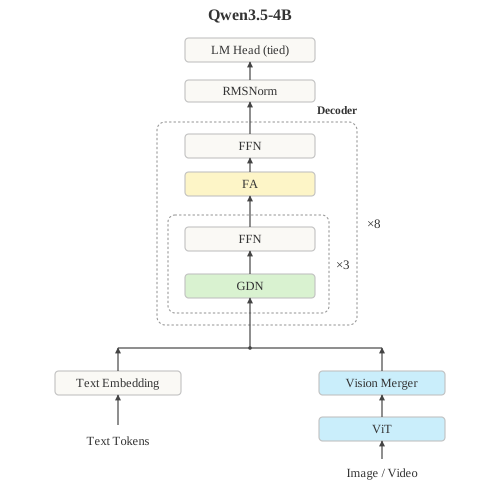
图 1|Qwen3.5-4B 文本主干逐层架构(本图为根据
config.json与modeling_qwen3_5.py自行绘制,非论文原图)。方向自下而上为前向;每 3 层 GDN(绿)接 1 层全注意力(黄),重复 8 次;灰底模块为 dense SwiGLU FFN。 实线框表示模块,嵌套虚线框表示层组的重复范围;底部视觉分支经 ViT 与 Vision Merger 接入文本主干的同一条序列。
1. 配置总览(文本主干)
| 配置项 | 取值 |
|---|---|
hidden_size |
2560 |
num_hidden_layers |
32 |
layer_types |
3 ×linear_attention + 1 ×full_attention,重复 8 次 |
full_attention_interval |
4 |
| 全注意力 Q / KV 头 | 16 / 4(GQA 4×),head_dim 256 |
attn_output_gate |
true(逐头输出门控) |
| 线性层 | linear_conv_kernel_dim 4;16 K-head / 32 V-head,d 128 |
hidden_act / intermediate_size |
silu / 9216 |
| 位置编码 | mRoPE:θ=1e7、partial_rotary_factor 0.25、mrope_section [11,11,10] |
max_position_embeddings |
262 144 |
vocab_size / tie_word_embeddings |
248 320 / true |
mtp_num_hidden_layers |
1(推理时不加载,见 §4) |
| 视觉塔 | depth 24、patch 16、hidden 1024、spatial_merge_size 2、输出投到 2560 |
2. 廉价层:Gated DeltaNet,而不是滑窗
Qwen3_5DecoderLayer 按 config.layer_types 在两种子模块里二选一:线性层用
Qwen3_5GatedDeltaNet,全注意力层用 Qwen3_5Attention [2]。GDN 层的内部顺序是:
in_proj_qkv:一个融合线性层,一次产出 Q / K / V 三路 [2];causal_conv1d:逐通道(depthwise)短卷积,核宽 4,负责把局部上下文混进 Q/K/V,相当于给递归加一个廉价的前置局部感受野 [2];- 门控 Delta 递推:衰减门由
g = -exp(A_log) * softplus(a + dt_bias)给出, 再按 delta 规则更新状态 [2]; RMSNormGated+out_proj输出回 hidden 维 [2]。
关键在于状态的形状:[batch, num_v_heads, k_head_dim, v_head_dim],
与序列长度完全无关 [2]。训练 / prefill 走 chunkwise 分块算法(块内矩阵乘、
块间串行传递状态),只有自回归 decode 才回到逐 token 递推——推导见
Gated Delta Network。
与 Spark-X2.5 的滑窗层相比,两者的"便宜"含义不同:
| SWA(Spark-X2.5 / Gemma4) | GDN(Qwen3.5) | |
|---|---|---|
| 保留什么 | 固定窗口内的精确注意力 | 一个固定尺寸的递归矩阵 |
| cache | 有界但不为零(随窗口增长) | 与序列长度无关 |
| 代价 | 窗口外信息完全不可见 | 状态容量有限,多条关联会碰撞 |
3. 全注意力层
只占 8 / 32 层,但本身设计得比较完整:
- GQA:16 个 Q 头 / 4 个 KV 头,
head_dim256,scaling = 1/sqrt(d); - q / k RMSNorm:归一化作用在
head_dim上(不是 hidden 维)[2]; - 逐头输出门控:
q_proj的输出维是num_attention_heads * head_dim * 2, 多出来的那一半即门控分支,与 Spark-X2.5 的独立g_proj等效但实现更紧凑 [2]; - mRoPE:三维(时间 / 高 / 宽)交错旋转,
mrope_section[11,11,10], θ=1e7,且只旋转 25% 的维度(partial_rotary_factor0.25)[1]。
4. 训练期 MTP,推理期不加载
config.json 里 mtp_num_hidden_layers = 1,说明预训练用了 1 层 Multi-Token
Prediction 头 [1];但 transformers 把 ^mtp.* 列进
_keys_to_ignore_on_load_unexpected [2]——checkpoint 里带这些权重,
推理时直接丢弃。所以画架构图时不应把 MTP 算进推理路径。
5. 多模态分支
视觉塔是一个 24 层 ViT(patch 16、hidden 1024、16 头),经 spatial_merge_size = 2
的空间合并与 temporal_patch_size = 2 的时序打包后,投影到文本主干的 2560 维 [1]。
文本侧通过 image_token_id / video_token_id(以及 vision_start / vision_end)
把这些 token 插进同一条序列 [1]。
6. 开源实现位置(pin 到 commit)
transformers commit 536ecc0:
| 组件 | 代码位置 |
|---|---|
Qwen3_5GatedDeltaNet 定义 |
modeling_qwen3_5.py#L490 |
| depthwise causal conv1d(k=4) | modeling_qwen3_5.py#L508-L519 |
衰减门 g 的计算 |
modeling_qwen3_5.py#L605 |
| chunkwise / 递归 gated delta rule | modeling_qwen3_5.py#L610-L640 |
Qwen3_5Attention 定义 |
modeling_qwen3_5.py#L735 |
| q_proj 双倍输出(输出门控) | modeling_qwen3_5.py#L747-L748 |
| q / k RMSNorm(head_dim 上) | modeling_qwen3_5.py#L759-L760 |
| 层型分派(linear / full) | modeling_qwen3_5.py#L847-L856 |
| MTP 权重忽略加载 | modeling_qwen3_5.py#L911 |
参考文献
[1] Alibaba Qwen Team. Qwen3.5-4B model card[EB/OL]. (2026)[2026-10-11]. https://huggingface.co/Qwen/Qwen3.5-4B/tree/851bf6e806efd8d0a36b00ddf55e13ccb7b8cd0a.
[2] Hugging Face. transformers: modeling_qwen3_5.py[EB/OL]. (2026)[2026-10-11]. https://github.com/huggingface/transformers/blob/536ecc007387a50e77603bb5d92100e9b07514cc/src/transformers/models/qwen3_5/modeling_qwen3_5.py.
© 2026 Yang Huan · yanghuan9812@qq.com