DuetServe:单 GPU 内用 SM 级空间复用协调 prefill 与 decode
DuetServe 的核心主张是:LLM serving 不必在"聚合(共享 GPU)"与"分离(独立 GPU 集群)"之间二选一——现代 GPU 的 SM 可以在同一个卡里划出多个逻辑"子 GPU",prefill 与 decode 默认混批执行,只在预测到 decode TBT 要违反 SLO 时,才临时把 SM 划开做空间隔离,争用消退后重新合并。 论文发表于 ICML 2026(PMLR 306)[1],实验平台为双 H100。
- 论文:http://arxiv.org/abs/2511.04791,PDF 归档于
assets/papers/gao2026duetserve-harmonizing-prefill-and-decode-via-adaptive-gpu-multiplexing.pdf
本笔记分三部分:§1 复述 Introduction 中对现有 serving 方案(chunked prefill 与 PD 分离)的问题描述;§2 是论文 Motivation 的三个 Observation——每一条都对应一组实验,用来量化支撑 §1 里的定性断言;§3、§4 简述方法与验证结果。
1. Introduction:两条既有路线为何无法同时满足高吞吐与低 TBT
1.1 背景:两阶段不对称,同步混批的代价
LLM 推理分两相,资源画像互为镜像:prefill 把整段 prompt 一次前向算完,compute-bound,靠大 batch 吃满 GPU 上的大量 SM;decode 逐 token 流式产出,每步都要读一遍 KV cache,memory-bound,受 HBM 容量与带宽约束。这直接塑造了两个指标:TTFT(Time-to-First-Token)主要由 prefill 决定,TBT(Time-Between-Tokens)由 decode 决定。为提高吞吐,现代框架普遍采用 continuous batching[2]:每个解码步都允许进出请求。但把长 prefill 同步插进正在进行的 decode batch,会把两相耦合在同一条 kernel 序列里,decode TBT 被显著抬升:论文原文(§1)However, inserting long prefills into an ongoing decode batch synchronously couples the two phases, which can severely inflate TBT and lead to SLO violations.
1.2 路线一:chunked prefill——token budget 限制不了每次迭代的真实时长
chunked prefill(Sarathi-Serve[3])的思路是用 token budget 限制单次迭代的工作量:每次迭代先尽量调度 decode(每个 decode 请求消耗 1 个 token 预算),剩余预算给 prefill,塞不下整段 prompt 就切成 chunk。预算通常取在线性层 roofline 曲线的"knee"处以最大化线性层利用率,而这个饱和点随硬件增强不断上移——论文给出的数字是从 A100 的 2K tokens 升到 H100 的 8K tokens(H100 上 vLLM、SGLang 等框架把默认 token budget 相应调大[5])。
Introduction 指出这条路线有两个失效点,且互相关联:
- 吃满大 budget,单次迭代延迟仍然过长。 H100 上 8192-token 预算的 prefill-only batch,迭代延迟一致超过 180 ms;一旦 decode 混入同一个同步执行流,decode TBT 被抬到同样水平,击穿典型的 100 ms TBT SLO[3]。
- "线性层主导"假设对长上下文请求越来越不准。 attention 计算随 prompt 长度二次增长、KV cache 读取随 context 增长,固定 token budget 天然控制不了这些"预算外"的访存开销——这正是 §2 中 Observation 1/2 用实验展开的问题。
1.3 路线二:PD 分离——用整卡粒度买到隔离,代价是资源浪费与失衡
另一条路线是 prefill-decode disaggregation(DistServe[4] 等):把两相放到独立 GPU 集群上执行,prefill 不再打断 decode,TBT 稳定可控。但 Introduction 指出这种"整卡隔离"有两个结构性问题:论文原文(§1–2)As an alternative, prefill-decode disaggregation isolates the two phases on separate GPU clusters (…), but it introduces KV transfer and memory duplication overheads and can suffer from resource imbalance under time-varying traffic (e.g., excess prefill capacity under decode-heavy workloads, or the reverse).
- 复制与搬运开销:分离后各 GPU 上都放完整模型副本,两相之间还要传输 KV cache,内存与互连开销由此而来;
- 比例是"粗粒度静态"的:两相的资源比例定在整台 GPU 粒度,而真实流量时变——decode-heavy 时 prefill 容量过剩(prefill-heavy 时则相反);重新按比例调整意味着重新划分 GPU 配置,变更代价高、节奏慢,追不上请求级的流量波动。
1.4 DuetServe 的定位:按需的"分离级隔离"
两条路线各有短板,论文由此引出自适应设计:默认像聚合系统那样混批执行,只在预测到 TBT 劣化时才切到 GPU 空间复用(spatial multiplexing)模式。其关键思路是把 GPU 的 SM 划分成并发执行的逻辑"子 GPU",让 prefill 与 decode 在争用期各占一组 SM,得到分离系统才有的相间隔离;争用消退后回到完全共享,常态下不再支付隔离的固定成本。
DuetServe 由三个组件支撑(贡献列表,概览见 §3):
- attention-aware roofline model——基于算子的计算/访存画像预测混合 batch 的迭代延迟,提前发现 TBT 违约风险;
- GPU partitioning optimizer——在预测到违约时,求出在 TBT 约束下吞吐最大的 SM 划分,而不总是靠划分来隔离;
- interruption-free execution engine——look-ahead decode 调度 + 异步 kernel 发射,消除 CPU–GPU 同步空泡,保证并发执行不被打断。
实验(双 H100、Qwen3-8B/14B、三个真实 trace)的结果是:吞吐相对 SOTA 框架最高提升 1.3×,同时保持低 TBT。
2. Motivation:三个 Observation 用实验把 §1 的问题钉死
Motivation 一章先重述 chunked prefill 调度器(Sarathi-Serve[3])的工作方式:decode 优先、每个请求一次迭代占 1 个 token 预算;剩余预算给 prefill,预算小于整段 prompt 时就切块填满。这套机制的"最优"依赖两个显式假设——线性层主导延迟、attention 开销可以被总 token 数隐含覆盖——论文用三组实验把 §1 中对 chunked prefill 与 PD 分离的定性批评逐条量化。
2.1 Observation 1:吃满 token budget 也会违反 TBT SLO
第一个实验校验"线性层 knee"这一默认 budget 的可信度。图 1(a) 显示 4096×4096 线性层的吞吐饱和点从 A100 的 tokens 移到 H100 的 ,这解释了 vLLM 等框架在 H100 上把预算放大到 8192 的动机;单看线性层,这个选择确实"合理"。但端到端模型执行还包括 attention、norm 等算子:图 1(b) 中,H100 上 8192 预算的 prefill-only batch 迭代延迟一致 >180 ms;同一同步 batch 再混入 decode 时,decode TBT 被抬到同样水平——超出典型的 100 ms TBT SLO[3]。Observation 1(原文)Fully consuming the token budget can violate TBT SLOs despite full linear layer utilization, while reducing the token budget improves latency at the cost of throughput efficiency.
这形成两难:把预算减下来确实能压低 TBT,但代价是放弃线性层利用率与吞吐效率。这正是 §1.2 第 1 个失效点的量化:同步混批的 chunked prefill 下,"线性层吞吐优先"与"decode TBT 稳定"无法同时满足。
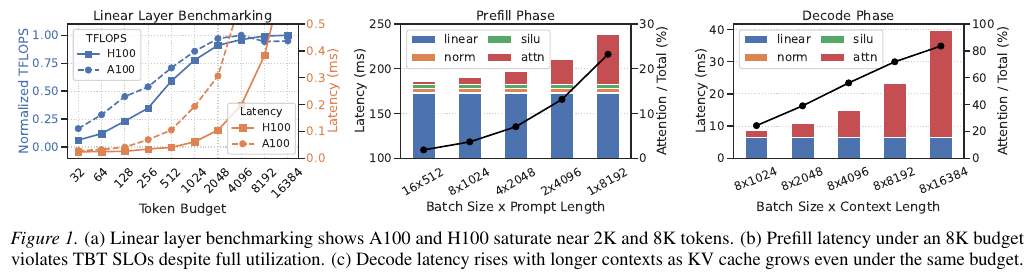
图 1|token budget 的来源与失效(取自论文 Figure 1[1])。(a) A100/H100 线性层的归一化 TFLOPS 与延迟随 token budget 变化,饱和点分别约在 2K / 8K tokens——默认 budget 的出处;(b) H100 上 8192 budget 的 prefill-only batch 迭代延迟一致 >180 ms,单个 8192-token prefill 中 attention 占比约 25%;(c) 同一 8-token 预算的 decode-only batch,延迟随 context 增长上升超过 4×。
2.2 Observation 2:token budget 天然忽略 attention 开销
第二个实验聚焦 attention:图 1(b) 最右端单个 8192-token prefill 中,attention 已占前向延迟约 25%;decode 侧更严重——图 1(c) 显示,decode-only batch 即便每步只用同样的固定 token 预算(每步 8 tokens),随 context 增长延迟变化也超过 4×:attention 延迟随 KV cache 尺寸上升,KV cache 读取逐渐主导 runtime。Observation 2(原文)The token-budget-based scheduling policy ignores attention cost during both prefill and decode phases, failing to provide consistent TBT latency control.
也就是说,token budget 度量的是"线性层要算多少 token",而不是"这批要执行多久";长上下文场景里决定 TBT 的恰恰是后者。这印证了 §1.2 第 2 个失效点:预算式调度器无法为长上下文负载提供稳定的 TBT 控制,迭代时长随 context 漂移,SLO 约束在不显式建模 attention 的调度器里根本无法被表达。
2.3 Observation 3:PD 分离守住 TBT,却交出大半吞吐
Motivation 还做了 PD 聚合与 PD 分离的同环境对照:Qwen3-8B、双 H100 80 GB。聚合侧为 Agg-vLLM(chunked prefill、budget 8192,两卡各放完整模型副本、轮换处理请求);分离侧为 Disagg-Dynamo(1P+1D,KV cache 经 NIXL 传输,完全隔离两相)。工作负载按官方 vLLM 分离 demo 配置:每请求 8000 输入 tokens、200 输出 tokens;逐步提高 QPS,测 TTFT / TBT / 总 token 吞吐(图 2)。
结果正是 §1.3 的量化版:
- 分离系统 TBT 确实平稳(隔离有效),但 TTFT 在 QPS>4 后陡升;聚合系统要到 QPS=7 才饱和——分离系统的 prefill 处理能力反而是先枯竭的那个;
- 总 token 吞吐:Disagg-Dynamo 不到 Agg-vLLM 的一半。
根因是论文点明的 resource imbalance:等容量配置下,聚合系统两块 GPU 都在跑 prefill(等于 prefill 吞吐翻倍);而 1P+1D 分离只有一块 GPU 负责 prefill,随 QPS 上升成为系统瓶颈,prefill worker 的吞吐越来越落后于 decode worker,整体系统吞吐随之退化。要纠正这种失衡只能重新调整两相 GPU 数的比例——粗粒度重配开销大、响应慢(呼应 §1.3)。
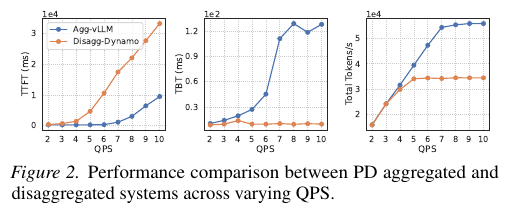
图 2|PD 聚合与分离系统的对照实验(取自论文 Figure 2[1])。左:分离系统 TTFT 在 QPS>4 陡升;中:分离系统 TBT 基本走平;右:分离系统总 token 吞吐(橙线)不足聚合系统(蓝线)的一半。
2.4 Opportunity:prefill 与 decode 资源画像互补,SM 共存成为第三条路
Motivation 最后用一组 GPU 内部测量指出机会:在 H100 上以 TPC(2 个 SM)为最小分区单位,用 cudaMemcpy 与 gemm 微基准测性能随活动 TPC 数的缩放(图 3(a)):有效 HBM 带宽随活动 SM 数超线性上升——20% 的 SM 就能拿到约 60% 的峰值带宽;而 FLOPs 除离散 TPC 颗粒度的量化效应外基本随 SM 数线性。也就是说,把 SM 同时分给多个并发 kernel 时,访存与算力资源都不会线性打折。
端到端层面(图 3(b)(c))则刻画出互补性:compute-bound 的 prefill 阶段把 SM 吃满却让大部分 HBM 带宽闲置;memory-bound 的 decode 阶段恰好相反——高 HBM 流量、SM 大量空闲。论文原文(§3,原文为粗体)This complementary behavior reveals an opportunity for resource co-execution, where compute-intensive and memory-intensive workloads can share SM and HBM resources more efficiently.
这引出第三条路线:不需要"整卡分离"才能获得隔离,也不需要"永远混批"才能保利用率——把 SM(而非 GPU)作为隔离的粒度,并只在预测到争用时启用。于是三个 Observation 与这个机会正好补全了论证闭环:Obs 1/2 支撑"chunked prefill 压不住迭代延迟",Obs 3 支撑"整卡 PD 分离浪费资源",Opportunity 支撑"SM 级空间复用可行"。
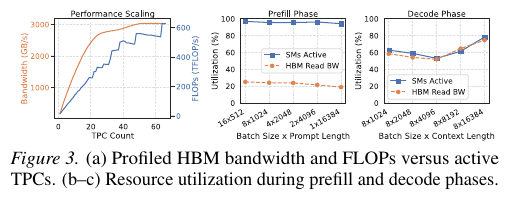
图 3|SM 级共存的机会(取自论文 Figure 3[1])。(a) H100 上有效 HBM 带宽与 FLOPs 随活动 TPC 数(每 TPC 2 个 SM)的缩放:带宽超线性(20% SM 达约 60% 峰值带宽),FLOPs 近线性;(b) prefill 阶段 SM Active 接近饱和、HBM Read BW 低;(c) decode 阶段相反。两相互补的画像支撑 SM 级共存。
3. 方法概览:三个组件分别接住 §1 的三类问题
DuetServe 的整体工作流如图 4:每轮迭代先按常规 chunked prefill 方式组 batch(优先正在进行的 decode,再按剩余 budget 收 prefill);用 roofline 模型预测混合 batch 延迟,若满足 TBT 约束则按时间共享方式执行;若预测违约,则把工作负载拆成 decode-only 与 prefill-only 两个不相交集合,各配独立、不重叠的 SM 分区并发执行。
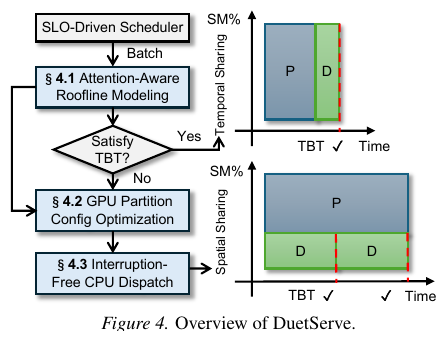
图 4|DuetServe 的调度总览(取自论文 Figure 4[1])。SLO 驱动调度器组 batch → attention-aware roofline 建模评估是否满足 TBT → 满足则时间共享执行;不满足则进入 GPU 划分配置优化,并由无中断 CPU 发射引擎以 SM 粒度空间共享执行。
三个组件分别与 §1 的问题一一对应:
- Attention-aware roofline model(对应 Obs 2)。把算子分为 token-level(只看 batch 总 token 数:线性投影、LayerNorm、激活)、sequence-level(attention,逐请求依赖 query 长度 与缓存 KV 长度 )与 communication 层(TP 内 ring AllReduce)。每个算子延迟估计为 ;attention 按请求逐项 累加;总延迟为 。它提前预测 TBT 违约而非事后补救,并补上了 Obs 2 指出的"attention 开销盲区"。
- GPU partitioning optimizer(对应 Obs 1/3)。预测违约时,枚举解码侧 SM 数 ,只保留满足 的方案,在 下最大化吞吐 。优化天然偏向把 SM 多分给 prefill、decode 只留恰好满足 TBT 的下限。底层用 libsmctrl[6] 在驱动层按 stream 掩蔽 SM 可见性,提供透明、细粒度、启动开销可忽略的 SM 控制。
- Interruption-free execution engine(对应 §1.1 同步耦合)。decode 与 prefill 各绑定一条 CUDA stream 并被分配到各自的 SM 区;decode 用 CUDA Graph 捕获/重放(启动开销 <0.5 ms;prefill 因动态 shape 与控制流只能 CPU 逐 kernel 发射);look-ahead decode 按请求预留多个 KV cache 槽位、预先准备未来 步的元数据,然后 CPU 连续启动 张已录制的 CUDA Graph 而不做中间同步;decode 先于 prefill 启动,避免 CPU 侧空泡(论文 Figure 5 的时间线示意)。
这套设计的本质是把两个"常开"换成两个"按需":Obs 3 指出的整卡粒度隔离(PD 分离)被换成只在违约命中时启用的 SM 粒度隔离;Obs 1/2 与 §1.1 指出的同步混批被换成"预测 + 无中断并发执行"。
4. 验证简述:两条路线作为对照
实验平台:2×H100 80 GB(NVLink),Qwen3-8B(TP=1)与 Qwen3-14B(TP=2);三个真实 trace:Azure-Code(19 366 请求,平均输入/输出长度约 2 k / 28)、Azure-Conv(8 819 请求,约 1.2 k / 211)、Mooncake(采样 1 000 请求,约 12 k / 343),Poisson 到达。基线覆盖 §1 两条路线:vLLM v0.10.1-v1(chunked prefill、budget 8192)、SGLang-Default(吞吐优先、机会性执行 prefill-only batch)、SGLang-Chunked(Sarathi 式 mixed-chunk、budget 8192)、Dynamo v0.5.1+vLLM 后端(1P+1D,KV 经 NIXL)。
- Qwen3-8B、Azure-Code(QPS=16):DuetServe 保持 TBT <150 ms,吞吐 13.57 req/s;vLLM 与 SGLang-Chunked 的 TBT 均超过 200 ms;SGLang-Default 因反复插入 prefill-only batch 中断 decode,TBT 无界增长到 >680 ms。吞吐比 SGLang-Default 高 1.1×。轻载下 TTFT 略高是刻意的设计折中:用闲置资源推进 prefill,以保住 decode TBT 的稳定。
- Mooncake(QPS=5):DuetServe 2.72 req/s vs vLLM 2.14 req/s,约 1.3×。
- Qwen3-14B(TP=2、Azure-Code):DuetServe 的 TBT 仅次于 Dynamo-1P1D 但吞吐最高;Dynamo-1P1D 虽 TBT 最低,却因 prefill GPU 成为瓶颈而吞吐垫底——与 Obs 3 的观察一致,而 DuetServe 用 SM 粒度规避了整卡失衡。
结论是:相比"守 TBT 而牺牲吞吐"(chunked prefill 大预算 / SGLang-Default)与"守 TBT 而浪费整卡"(1P+1D 分离),DuetServe 都能取得更优的(吞吐,TBT)组合。
参考文献
[1] GAO L, JIANG C, ZARCH H E, et al. DuetServe: harmonizing prefill and decode for LLM serving via adaptive GPU multiplexing[C/OL]//Proceedings of the 43rd International Conference on Machine Learning (ICML 2026). PMLR, 2026. http://arxiv.org/abs/2511.04791. DOI:10.48550/arXiv.2511.04791.
[2] YU G I, SEO J, HAN D, et al. Orca: a distributed serving system for transformer-based generative models[C/OL]//16th USENIX Symposium on Operating Systems Design and Implementation (OSDI 22). USENIX Association, 2022: 521-538. https://www.usenix.org/conference/osdi22/presentation/yu.
[3] AGRAWAL A, KEDIA N, PANWAR A, et al. Taming throughput-latency tradeoff in LLM inference with Sarathi-Serve[C/OL]//18th USENIX Symposium on Operating Systems Design and Implementation (OSDI 24). USENIX Association, 2024: 117-134. https://www.usenix.org/conference/osdi24/presentation/agrawal.
[4] ZHONG Y, LIU S, CHEN J, et al. DistServe: disaggregated prefill and decoding for goodput-optimized large language model serving[C/OL]//18th USENIX Symposium on Operating Systems Design and Implementation (OSDI 24). USENIX Association, 2024. https://www.usenix.org/conference/osdi24/presentation/zhong.
[5] KWON W, LI L, ZHUANG S, et al. Efficient memory management for large language model serving with PagedAttention[C/OL]//Proceedings of the 29th Symposium on Operating Systems Principles (SOSP '23). ACM, 2023: 611-626. https://doi.org/10.1145/3600006.3613165.
[6] BAKITA J, ANDERSON J H. Hardware compute partitioning on NVIDIA GPUs[C/OL]//2023 IEEE 29th Real-Time and Embedded Technology and Applications Symposium (RTAS). IEEE, 2023. https://github.com/appointr/libsmctrl.