NPU 上的 Kernel Fusion:独立任务的资源互补与多引擎调度
我们的优化目标是在同一 NPU 的执行范围内,将输入已经就绪、彼此无数据依赖、主要使用不同执行资源的任务横向融合,显式调度矩阵、向量和数据搬运引擎,使它们重叠执行,缩短相同工作量的完成时间。 常见 megakernel 工作把更大的算子链或任务图放入统一设备入口,结合中间数据复用、跨算子流水、启动开销摊销和设备侧调度;我们的切入点是其中的独立任务资源互补。Megakernel 可以承载这种执行方式,但是否长期驻留、是否覆盖整模型,与能否实现资源重叠是不同问题;第一阶段静态组织两个或三个独立任务,就可以研究配额、同步域和片上缓冲区如何影响收益。
1. 问题边界与优化目标
研究对象首先是 HMX 主导的矩阵任务 + HVX 主导的独立向量任务,确认并发后再加入 DMA。任务可以来自同一图的独立分支、不同 micro-batch 或不同请求。一个 GEMM 与读取其输出的归一化存在依赖;要重叠它们,需要另行设计 tile 流水。
表 1|一期任务、执行资源与检查项
| 任务 | 初始实验对象 | 希望主要使用的资源 | 必须检查的实际行为 |
|---|---|---|---|
| 矩阵任务 | 输入布局已准备好的 GEMM | HMX | 是否仍需大量 HVX packing、反量化或数据搬运 |
| 向量任务 | 另一份数据的激活、归约或 normalization | HVX | 是否与 争用 VTCM 访问或 DDR 带宽 |
| 搬运任务 | 独立缓冲区的 DDR ↔ VTCM 传输 | DMA | 是否确实由 DMA 推进;copy 的名称不能证明执行路径 |
“独立”要求输入已就绪,读写区间不存在 RAW、WAR、WAW 冲突,临时缓冲区也不发生别名冲突。图上的独立性还需经过内存规划核对:QNN 文档指出,VTCM 地址复用会给原本可重排的算子增加执行顺序约束qnn-scheduling。
核心假设是:后端的提交、等待或资源保留粒度,大于任务实际使用的资源粒度,使其他 ready task 无法充分利用空闲引擎。 应从时间线定位限制发生在提交队列、算子返回边界、worker pool、片上内存生命周期,还是引擎配额,并先核对目标后端已有的并发能力。
优化目标分为三项,分别测量:
- 提高有效重叠:矩阵、向量、搬运在依赖允许时独立推进,降低整体完成时间。
- 控制并发代价:联合选择 tile、worker 份额和缓冲区,限制共享带宽竞争、等待和拖尾。
- 保留独立进度:任务完成后可释放自己的状态与缓冲区,为后续领取工作保留条件。
执行入口合并还能减少提交与调用开销;这项收益应与引擎重叠分开报告。
2. Related Works
本节梳理相关工作如何从性能问题引出优化机会。Motivation 回答“为什么需要优化”:现有执行方式有什么限制,论文用哪些时间线、利用率或停顿统计证明这些限制。Opportunity 回答“为什么有改善空间”:哪些工作已经就绪、哪些资源可以同时使用,以及放宽哪一层执行边界后能形成合法重叠。融合、队列、配额搜索和调度器则是利用这些机会的具体方法。
Ascend 的矩阵计算核为 AIC(AI Cube Core),向量计算核为 AIV(AI Vector Core);本节引用的论文图分别以 Cube 和 Vector 标注它们[1]。
最接近我们出发点的 motivation,是 HyperParallel-MoE 的 AIC/AIV 交替闲置,以及 Tacker/Aker 的 Tensor Core/CUDA Core 交替活跃[1][2][3]:软件按较粗的任务边界推进,使一个资源工作时,另一个资源空闲。对应的 opportunity 是不同执行资源能够同时工作,而且存在可在这些资源上并行推进的合法任务:Tacker/Aker 的任务来自独立应用,HyperParallel-MoE 则需要拆出满足依赖的 tile。PipeThreader、MPK 和 VDCores 也从资源空闲或流水气泡引出细粒度执行机会[4][5][6]。各工作的任务来源、依赖粒度与共享资源约束不同,需要逐项说明。
下表依据各工作的论述,分别归纳 motivation、opportunity 和利用机会的方法;与一期问题的联系在后文说明。GPU 方法提供设计依据,其性能结果仍需在目标 NPU 上验证。CCF 等级采用 2026 年 3 月 31 日发布的第七版目录,标注的是会议或期刊的现行等级,论文年份仍保留发表年份;预印本暂无适用等级。
表 2|相关工作的 Motivation、Opportunity 与优化方法
| 工作 | Motivation:问题与观察 | Opportunity:可利用的条件 | 利用机会的方法 |
|---|---|---|---|
Tacker[2] HPCA [2022]  |
GPU 整体显示忙碌,Tensor Core 与 CUDA Core 却交替闲置,传统共置未充分利用异构资源 | 独立 LC/BE 应用提供资源互补的任务,两类执行资源可以同时工作 | 静态融合互补任务,调整工作份额,预测融合时长并按 QoS 选择 |
| Aker[3] IEEE TC [2025] |
延续异构资源利用不足的问题;负载比例变化还会使融合尾部低效 | 独立任务的计算/访存需求互补,可按工作量选择共同执行的部分 | 自适应选择融合版本,部分工作融合,余下工作回到原 kernel,并结合 QoS 调度 |
HFuse[7] CGO [2022]  |
独立 kernel 的线程级并行没有充分用于隐藏指令等待 | 一组线程等待时,另一独立线程集合可能有可发射指令 | 线程分区、局部 barrier 与线程/寄存器配置搜索;仍需检查共同 CTA 生命周期的拖尾 |
| POD-Attention[8] ASPLOS [2025] |
prefill/decode 分别偏计算/带宽受限,串行执行使资源分阶段利用不足 | 不同请求提供同时可执行的 prefill/decode,其资源需求互补 | SM-aware CTA 调度,控制配比、tile 和独立同步,减轻共驻留与 CTA 拖尾 |
| GoPTX[9] DAC [2025] |
原生并发下,任务内部的指令依赖仍造成停顿和气泡 | 独立任务的可执行指令可以交织,填补另一指令流的等待 | 合并控制流,按依赖与延迟交织 PTX 指令 |
VDCores[6] arXiv [2026]  |
任务级等待与队头阻塞限制 ready 微操作推进 | 计算/搬运微操作可按真实依赖独立推进,其他流的 ready 工作可绕过停顿 | 全图 tiling/映射、计算/搬运微操作与虚拟流执行 |
| HyperParallel-MoE[1] arXiv [2026] |
已有粗粒度通信/计算 overlap,FFN 的 GMM(Grouped GEMM,分组矩阵乘)、SwiGLU 等仍按完整 kernel 先后使用 AIC/AIV,形成 Cube/Vector bubble | 不同 tile 的矩阵、向量与通信阶段可在各自输入就绪后交错推进 | 拆分 tile,以队列、就绪事件和统一执行窗口组织异构任务 |
| Dato[10] arXiv [2025] |
外部内存往返与隐含通信限制片上数据流 | 独立投影可映射到不同子阵列,有依赖的阶段可通过片上数据流形成流水 | 显式 stream/layout、空间映射与多任务流水 |
| Hexagon-MLIR[11] arXiv [2026] |
数据搬运、片上局部性与执行粒度影响性能 | 中间数据可留在 TCM/寄存器,下一块数据搬运可与当前计算重叠 | megakernel、HVX 多线程、DMA 双缓冲;独立 HMX/HVX 配对仍需验证 |
| Rammer[12] OSDI [2020] |
把算子视为黑盒会分割算子间和算子内调度空间,阻碍独立工作共存 | 细粒度任务可以联合分配执行单元份额,让独立算子共同推进 | 用 rTask 统一表达细粒度工作,生成静态时空调度 |
| PipeThreader[4] OSDI [2025] |
已融合计算内部,tile 与专用单元调度仍可能低效,矩阵与通用计算资源交替空闲 | 保留同一 tile 的依赖,将不同 tile 的矩阵与通用计算阶段重叠 | sTask 图、分层硬件抽象,联合搜索 tile 和流水 |
| MPK[5] OSDI [2026] |
kernel 边界切断跨 task 流水,留下启动与排空气泡 | 后续 task 的合法预取和计算阶段可提前推进,延续搬运/矩阵/通用计算流水 | SM 级任务图 + persistent megakernel + 分散调度 |
| Orion[13] EuroSys [2024] |
并发收益受干扰和执行粒度影响 | 细粒度任务提供共享 GPU 的调度空间,收益取决于干扰控制 | 干扰感知的细粒度 GPU 共享调度 |
与独立矩阵+其他计算任务配对最直接的机制参照是 Tacker/Aker 与 GoPTX;HFuse 提供横向融合、配额与同步经验,POD-Attention 提供真实任务供给。HyperParallel-MoE、PipeThreader、MPK、VDCores 帮助分析跨 tile/task 的异构执行机会。NPU 上的贡献应说明执行控制、存储约束处理方式,以及相对现有最佳并发路径增加了哪些能力。
2.1.1 HyperParallel-MoE:从通信/计算 overlap 到 Cube/Vector bubble
已有通信与计算重叠,是这篇论文的问题背景。 作者在 §2.3(PDF 第 4 页)指出,已有训练栈可以做到粗粒度通信/计算 overlap,但仍按完整设备 kernel 发起 MoE 算子[1]:
“can overlap coarse computation and communication work, but still launch MoE operators as full-device kernels.”(§2.3[1])
这里的原文明确区分了两个层级:已有路径能重叠通信和计算;MoE-FFN 内部的矩阵与向量计算,仍受逐 kernel 执行边界限制。因而,论文还要进一步分析片内 AIC/AIV 是否同时得到利用。
Figure 2 先说明 FFN 的算子分工,Figure 4 再把这一分工展开到执行时间上。 §2.2 的前向图是 Dispatch → GMM gate/up → SwiGLU → GMM down → Combine。两次 GMM 主要使用 AIC;SwiGLU、Dispatch、Combine 等主要使用 AIV[1]。这说明各算子的主要资源不同;“主要使用”并不表示一个 kernel 完全不需要其他资源。
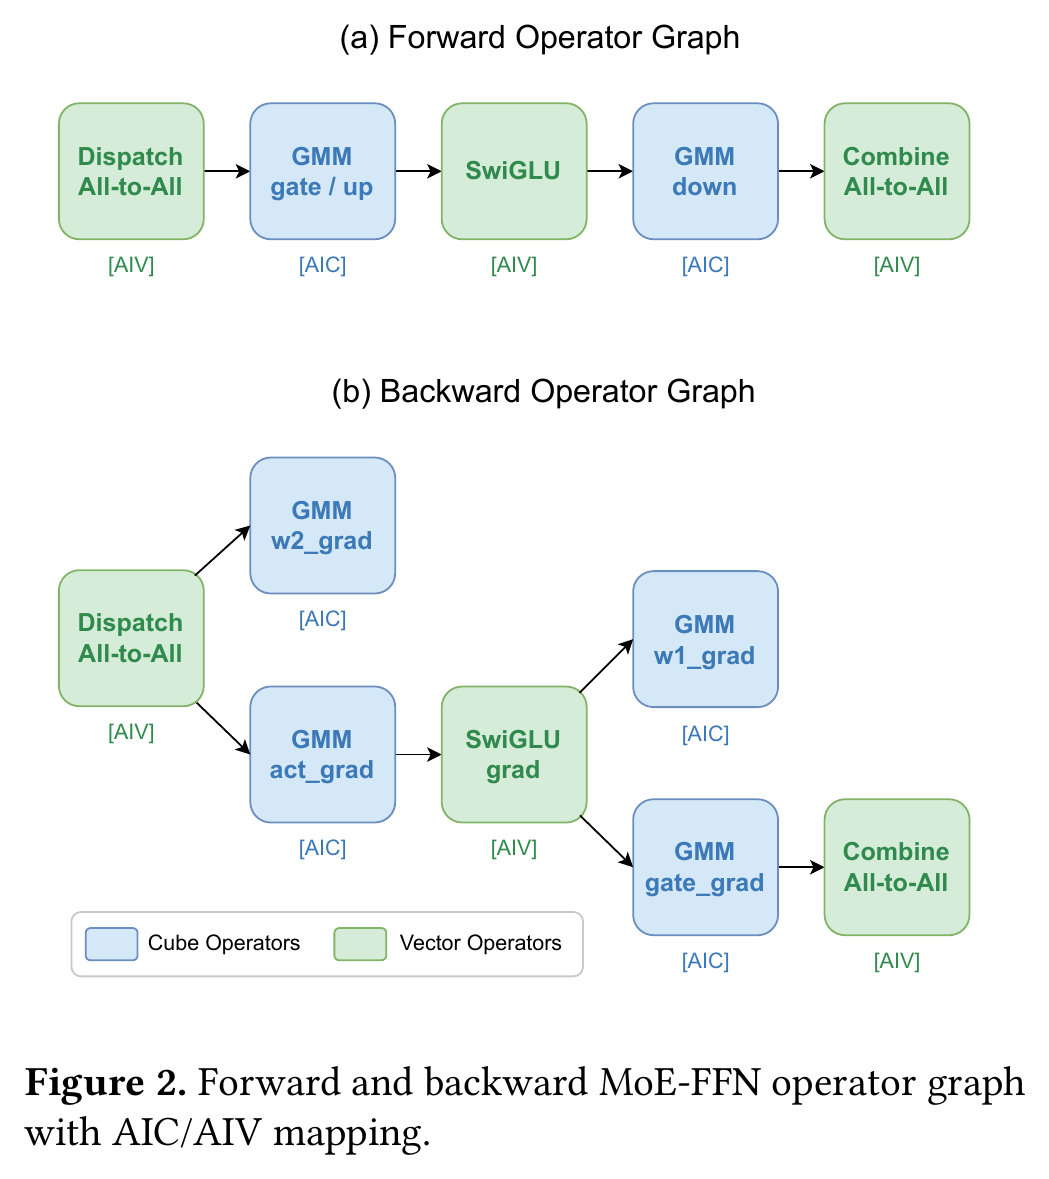
图 1|MoE-FFN 算子与 AIC/AIV 的对应关系(取自 HyperParallel-MoE v2 Figure 2[1])。蓝色 GMM 使用 Cube,绿色 SwiGLU、Dispatch、Combine 等使用 Vector。上为前向依赖链,下为反向依赖图;箭头表示数据依赖,这张图本身不描述时间重叠。
逐 kernel 串行推进,把这种资源分工变成了 Cube/Vector 之间的 bubble。 Figure 4(a) 中,GMM 运行时 Vector 等待,SwiGLU 等阶段运行时 Cube 等待。作者在 §2.3 把观察限定在其 profiling 的 Ascend 执行路径,并写道:
“an AIC-dominant kernel must finish before an AIV-dominant kernel can run, and vice versa”(§2.3[1])
也就是说,限制位于完整 kernel 的完成边界:后续算子即使只需要已经产生的部分结果,也没有被暴露为可独立调度的 tile。资源分工加上这种粗粒度推进方式,才形成图中的交替闲置;不能只凭 AIC/AIV 硬件分工,就判断它们一定无法重叠。
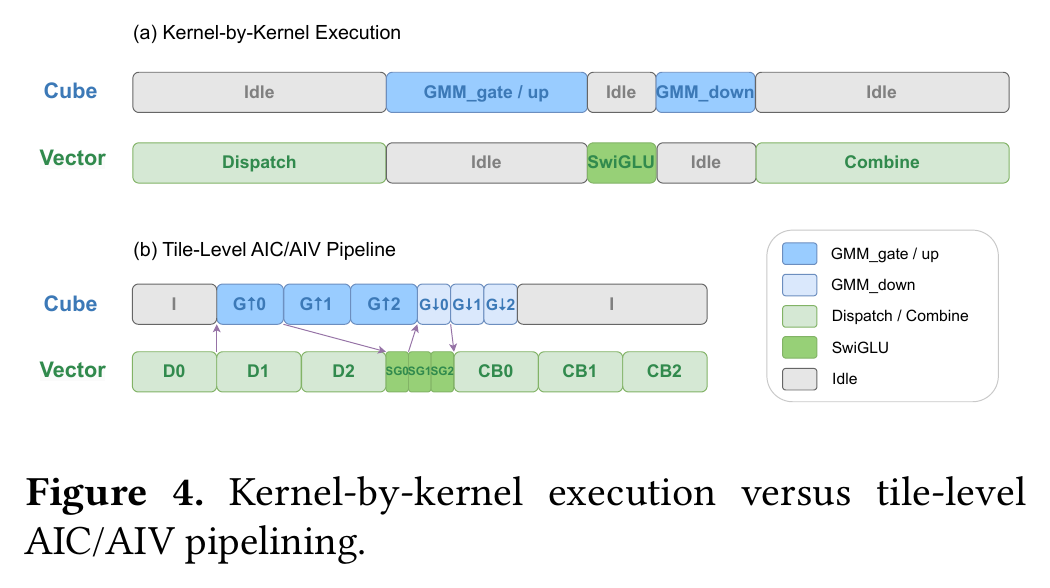
图 2|算子分工在执行时间上形成 Cube/Vector bubble(取自 HyperParallel-MoE v2 Figure 4[1])。上:Figure 2 的前向算子按完整 kernel 先后运行,两类资源交替闲置。下:把算子拆成 tile 后,满足依赖的矩阵、向量与通信任务交错推进。这是执行方式示意图,块长不能直接用来读取实测时延。
解决方式是缩小推进与等待粒度,暴露异构资源的并行。 Figure 4(b) 展示 tile 交错:例如某个 tile 的 GMM 输入已就绪即可开始,其他 tile 继续 Dispatch;某个输出 tile 就绪后即可进入 SwiGLU,同时 Cube 推进其他矩阵 tile。§4.3–4.4 进一步将其实现为 CTQ/VTQ 两类队列、跨队列事件和统一执行窗口。作者对队列关系的表述是:
“CTQ and VTQ can progress independently”(§4.3,PDF 第 10 页[1])
Host 的提交单位仍是 kernel,tile 是这个 kernel 内部的软件任务单位。 Figure 5 右侧明确先经过 Kernel Launch,再分出 AIC Worker 与 AIV Worker;§4.4(PDF 第 10–11 页)说明整个前向或反向 taskflow 在 “within a single unified kernel launch” 中执行[1]。
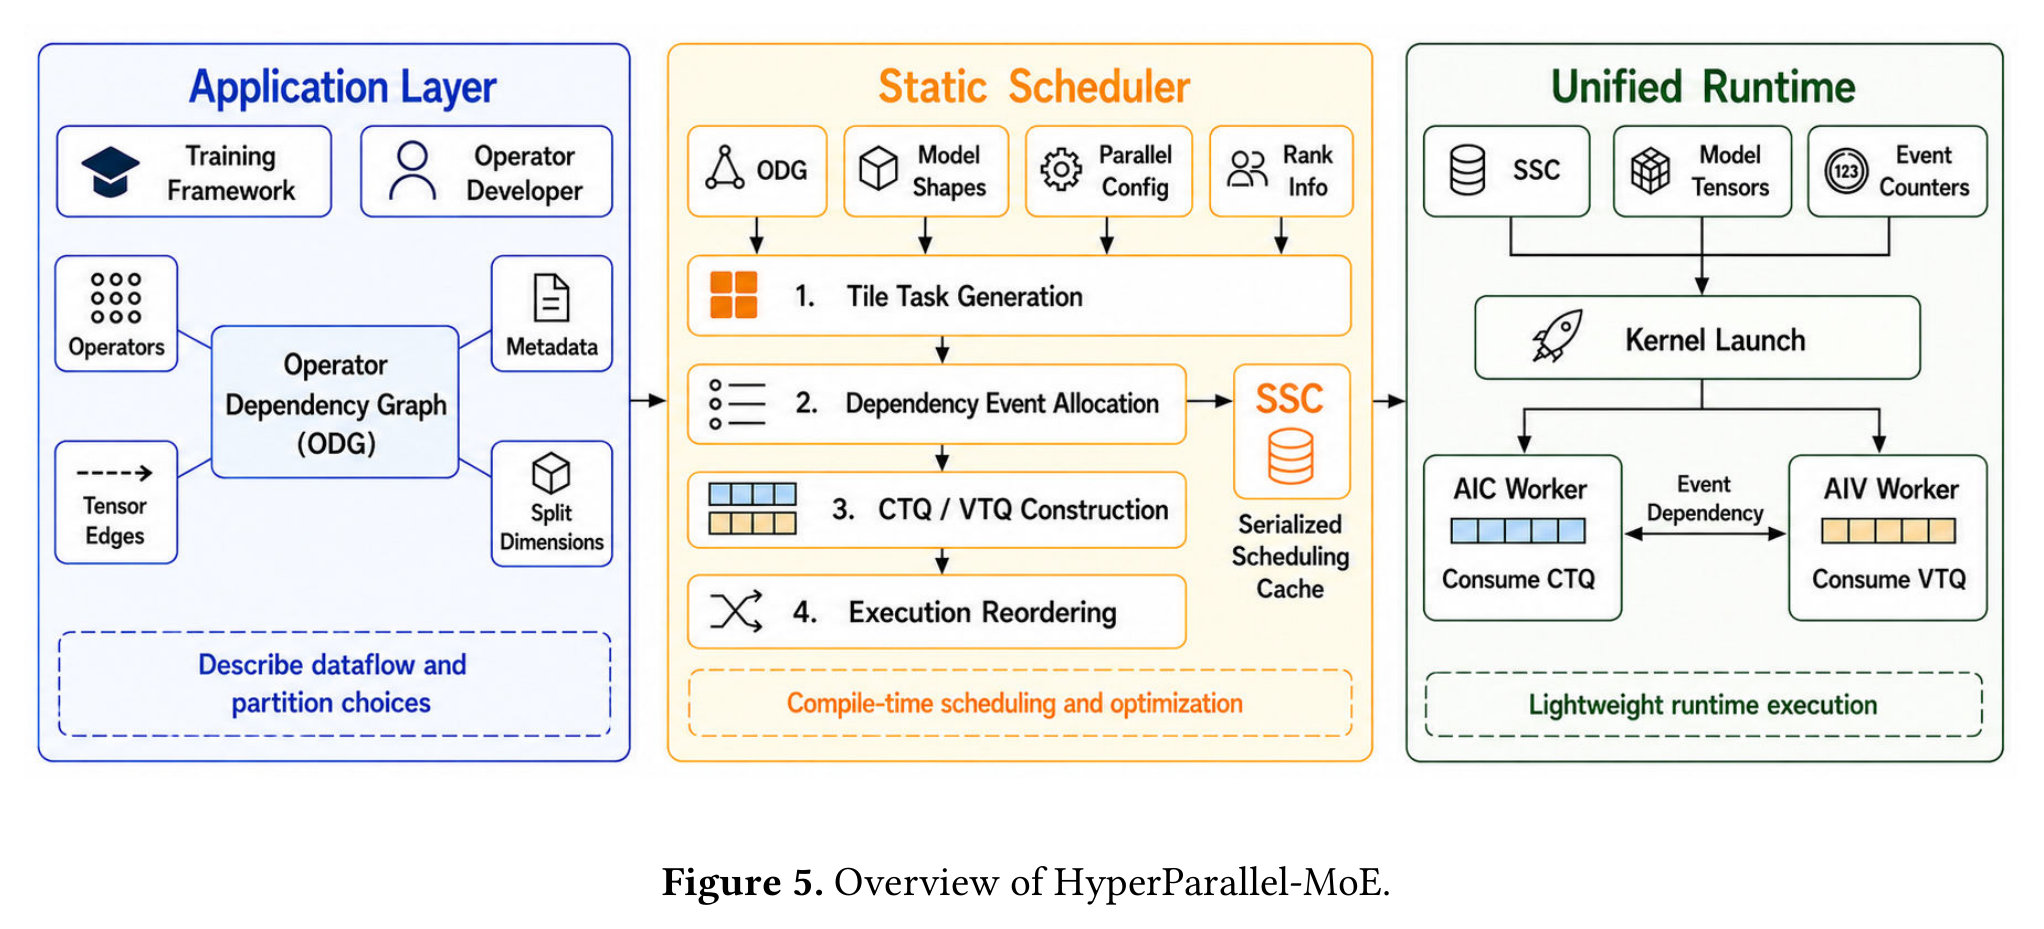
图 3|一次 kernel launch 内部执行多项 tile task(取自 HyperParallel-MoE v2 Figure 5[1])。中间:静态调度器生成任务、依赖事件和 CTQ/VTQ 顺序,将计划序列化为 SSC。右:runtime 发起统一 kernel,AIC/AIV worker 在其生命周期内消费各自任务,通过事件协调。
表 3|HyperParallel-MoE 的执行层级与调用粒度[1]
| 层级 | 实际执行的动作 | 对调用粒度的含义 |
|---|---|---|
| 编译/计划生成 | 按合法切分规则生成任务描述,记录输入输出区域、tiling 参数、资源类型与事件依赖,形成静态计划 | tile 是带数据范围的工作描述;不一定等于一条矩阵指令的最小块 |
| Host → 设备 | 提交统一 kernel,并传入计划、张量和事件计数器 | 仍以 kernel 为 launch 单位 |
| kernel 内的 worker | 读取分配给自己的下一项任务,等待依赖计数达到阈值,再调用相应处理程序 | task dispatch 是设备内控制流;没有为每个 tile 再发起一次 Host kernel launch |
| 设备计算处理程序 | 按任务描述的输入输出偏移、数据范围和 tiling 执行 GMM、SwiGLU 或通信逻辑,发布完成事件 | 复用并适配算子计算核心,在统一 kernel 内完成多项工作 |
当前公开实现也可核对这一层级hyperparallel-source:
- 混合 kernel 类型配置选择 AIC/AIV mixed kernel;统一入口取得当前执行实例的编号,进入 worker。
- 设备侧工作循环分别遍历分配给 AIC/AIV 的任务;依赖等待、计算与完成发布发生在同一个 kernel 内。
- 任务类型分派选择计算处理程序;GMM 调用传入当前数据区域的地址和 tiling。
- GMM 入口适配将上游可 launch 的入口改成设备侧 inline 函数。这里复用的是算子源码与计算逻辑;不能据此把任意现成黑盒 kernel binary 直接嵌入。
因此,这里的 tile 调度是统一 kernel 内的任务分派与函数调用。AIC/AIV 在各自分工下持续执行,真实依赖由事件连接。静态 worker 遇到当前任务依赖未满足时仍会等待,也不等同于动态选择任意 ready task 的调度器。
因此,静态队列和事件阈值应放在实现方法的位置;“不同 expert/token tile 的阶段”应放在拆分后如何释放并行的位置。这篇工作的动机链是:已有粗粒度通信/计算 overlap → FFN 算子主要使用不同核心 → 完整 kernel 顺序推进形成 Cube/Vector bubble → tile 级异构交错减少可避免等待。
设计思路:把算子级串行改造成静态调度的 tile 级异构任务流(§3–4)。 不再把 GMM、SwiGLU、通信、同步当作彼此间有全局 barrier 的独立 kernel,而是把整个 MoE-FFN 前向/反向编译成一张 tile 级任务图:离线确定资源、顺序与依赖,运行时只做“取任务 → 等依赖 → 执行 → 触发事件”。四个关键机制:
- AIV 驱动的单边通信(§4.1):把 AllToAll 从主机侧集合通信搬进设备侧 AIV 执行路径。基于 Ascend 的 SHMEM 式远程内存访问,封装
put_mem_signal——发方 AIV 直接把数据块写入目的 rank 的缓冲区,数据在目的侧可见后更新事件计数。于是 Dispatch/Combine 被拆成一堆细粒度远程写任务,每个 tile 独立更新完成计数器,下游 GMM 只需等对应 tile 就绪,而不必等整个 AllToAll 阶段收尾。 - 依赖保持的 tile 任务生成(§4.2):tile 边界不能随意切。论文用算子依赖图(ODG)+ SplitSpec描述合法切分(继承哪个输入分区、沿哪个维度把分区传播到输出、在给定形状与并行配置下生成几个任务),再用 split propagation(Algorithm 1)沿拓扑序把分区标签传播到整张图,最后由各算子的 FillConfig 落成统一的任务描述符(TD)。约束是:GMM 只沿 token/expert-block 维暴露并行、保留 reduction 维 ,以免破坏专家分组、访存重排与 L2 局部性;AIV 侧算子(Dispatch、SwiGLU、Combine)的 tile 必须与 GMM 的行分区对齐;不合法的切分退回非分区执行以保证正确性。
- 静态调度与事件驱动同步(§4.3):按 TD 的资源类型分两条队列——矩阵密集任务(GMM)进 CTQ 由 AIC 执行,向量/通信任务(Dispatch、Combine、SwiGLU)进 VTQ 由 AIV 执行。队列顺序只管同类任务的先后,跨队列依赖一律用事件计数器显式表达:每个任务带
dependent_event(执行前须达到阈值)与trigger_event(完成后递增),阈值离线生成。该机制天然表达多对多依赖(一个 GMM 可等若干 Dispatch tile;一个输出 tile 可同时放行向量与通信任务)。选择静态而非动态的理由:稳定训练阶段算子结构、并行配置与主导形状固定,把调度放进编译期后,运行时只承担取任务、等依赖、触发事件。 - 统一 AIC/AIV 执行(§4.4):整个前向/反向 taskflow 在一次 kernel launch 内执行。AIC worker 消费 CTQ、AIV worker 消费 VTQ,各自“取 TD → 等依赖 → 按
task_type分派到对应 handler → 触发后继”,handler 封装现有优化算子(不改算子计算核心)。收益有两层:① 某专家的 GMM 只要输入 tile 到达即可开始,同时 AIV 继续推进其他专家的 Dispatch/SwiGLU/Combine,使 Cube 计算、Vector 计算与通信在同一窗口内重叠;② AIC/AIV 共享 L2,把生产者与消费者在时间上排近,即可让下游直接从 L2 复用中间结果,无需改动算子内部。
执行顺序上的两处调整(§4.5)。 静态调度先保证正确性,但合法拓扑序中仍有大量可优化空间;论文只重排互不依赖的任务,不改 ODG 边、输入输出区域或事件语义:
- Rank-Aware Task Reordering(RATR):朴素顺序让所有 rank 以相同的目标 rank 序列发起通信,使某些目标 rank/链路在特定时间窗被打爆(hotspot)。RATR 按源 rank ID 轮转通信任务顺序(不同源 rank 从不同目标开始、环形遍历),把流量在时间上摊开,改善 EP 组内负载均衡、减少拖后 rank 造成的等待。
- Cache-Guided GMM Interleaving:反向中,activation-gradient GMM 与 down-projection weight-gradient GMM 共享输入激活且彼此无依赖;若先把一个分支整体跑完再跑另一个,共享激活可能已被逐出 L2。该优化按专家局部性交错这些独立 GMM 任务,缩短共享激活的复用间隔,提升 L2 命中。
这与我们关注的片内多引擎利用率直接相关,但同一 tile 的 GMM→SwiGLU 仍有真实依赖。我们第一阶段的独立任务配对,是对这种资源利用问题的一种受控验证;它与论文的依赖流水需要分别表述。通信与搬运也有 AIV 参与,不能自动当作独立的第三种 I/O 引擎,负载不均衡和真实依赖造成的空闲仍需保留在收益边界中。
2.1.2 Tacker/Aker:独立应用混部中的资源交替活跃
Aker 是 Tacker 的期刊延伸版。 Tacker 发表于 HPCA 2022[2],Aker 发表于 IEEE Transactions on Computers(IEEE TC,2025, 74(2): 386–400)[3],由同一课题组(一作均为 Han Zhao)在 Tacker 基础上扩展而成。
按 QoS(服务质量)需求,数据中心应用可分为两类:延迟敏感型(latency-critical, LC)应用/服务与尽力而为型(best-effort, BE)应用。前者的延迟约束严格——例如要从实时视频流中流畅地识别感兴趣的目标,目标检测算法必须在 50ms 内完成[2];后者没有约束或约束很松——例如在图上从某个节点开始做广度优先搜索(BFS),并不设截止期限。这一分类是我们讨论 GPU 共置(co-location)的前提:现代 GPU 算力充裕,单应用往往用不满整卡,因此在保证 LC 应用 QoS 不被破坏的前提下,把 LC 用剩的资源拿去跑 BE 应用,才更省成本[2]。
Motivation:只按 CUDA Core 设计的共置方案,无法利用 Tensor Core 与 CUDA Core 的并行。 现有 GPU 共置方案(如 Baymax[14]、Laius[15])主要围绕传统 CUDA Core 的资源调度来设计;当 GPU 同时集成 Tensor Core 与 CUDA Core 时,这类方案往往只能得到次优结果,因为它们没有把两类单元识别为彼此独立的执行资源[2]。
Figure 1 的实验设置:用 Baymax 把 LC 服务与 BE 应用混布到同一块 Nvidia 2080Ti。 其中 LC 服务为 ResNet50 推理,BE 应用为 Parboil 中的 sgemm;图 1 给出该配置下 SM 上两类单元的活跃时间线[2]。
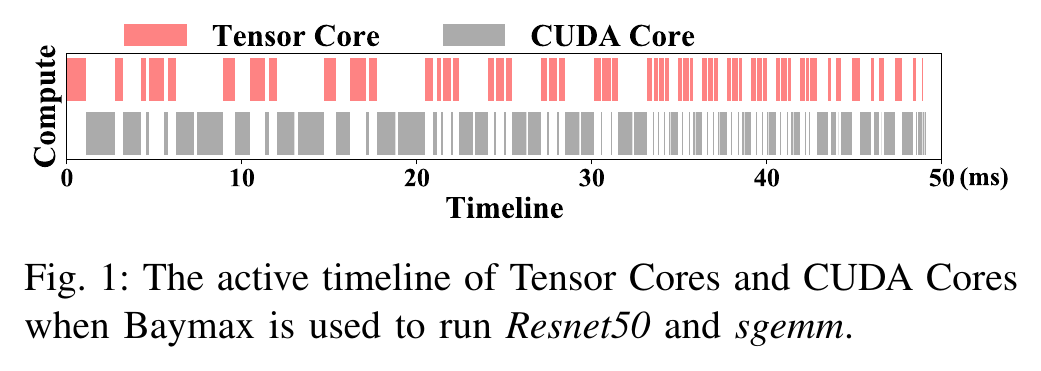
图 4|GPU 整体忙碌时,矩阵与通用计算资源仍可能轮流工作(取自 Tacker Figure 1[2];Aker Figure 1[3] 也沿用这一动机时间线)。在 Nvidia 2080Ti 上用 Baymax 混布 ResNet50(LC)与 sgemm(BE)时,红色为 Tensor Core 活跃区间,灰色为 CUDA Core 活跃区间。
观察:GPU 被判定为 computation-busy,但任一时刻总有 Tensor Core 或 CUDA Core 处于空闲。 也就是说,该混布下 ResNet50 与 sgemm 无法让 CUDA Core 与 Tensor Core 同时工作,两类单元只呈现交替活跃;作者把这种“外部看很忙、内部却有一半资源闲置”的现象称为 false high utilization[2][3]。这正是被忽视的可利用空间:把互补任务配到一起,就可以让空闲的另一类单元同时干活。该图展示的是资源活跃时间,而非“利用率已经达到峰值”。
Tensor Core/CUDA Core 与 Ascend AIC/AIV 的异同:
| 维度 | NVIDIA:Tensor Core / CUDA Core | Ascend:AIC / AIV |
|---|---|---|
| 单元定位 | Tensor Core 做矩阵乘(MMA),CUDA Core 做通用标量/向量 | AIC 做矩阵乘,AIV 做向量计算 |
| 物理组织 | 二者位于同一 SM 内 | 相互独立的两类核,可各自被调度 |
| 共享资源 | 共享同一 SM 的 warp 调度器、寄存器文件、片上存储与 L2/显存带宽 | 各自拥有片上缓冲区与搬运路径 |
| 调度粒度 | 指令/warp 级(MMA 指令 + warp 调度器统一派发) | 算子/队列级(矩阵/向量 kernel 类型不同,由运行时或队列推进) |
直接融合 / 为什么没有提升? Figure 3 给出了人工融合(artificial fusion)的实测时长[2]:
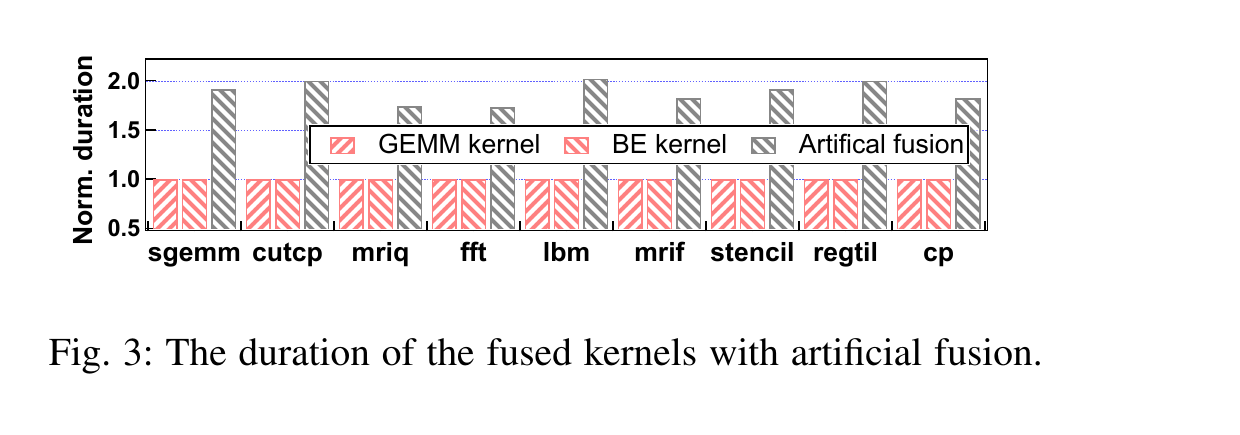
图 5|直接融合 Tensor Core kernel 与 CUDA Core kernel 的时长(取自 Tacker Figure 3[2])。每个 BE kernel 独立执行时的耗时归一化为 1(GEMM kernel、BE kernel 各为 1);灰色 “Artificial fusion” 柱是直接融合后的耗时。横轴为 Parboil 的 BE kernel(sgemm、cutcp、mriq、fft、lbm、mrif、stencil、regtil、cp)。
现象:大多数融合 kernel 的归一化时长约为 2,即“融了等于没融”。 理想情况下 Tensor Core kernel(记作 ,简称 TC kernel)与 CUDA Core kernel(记作 ,简称 CD kernel)应在两类单元上并行,融合后时长应接近 1;但实测大多落在 2 附近,说明两类核心几乎没有真正并行,并行利用率很低。
原因:融合后两个 kernel 争用 SM 资源。
- 显式资源争用:一个 SM 的 thread slot(最大线程数 )、shared memory 等容量固定,因此单个 block 越大(线程数、共享内存越多),每 SM 能同时驻留的 block 数 越少,两者大致成反比()cuda-occupancy。两个 kernel 各自大量占用这些资源时,融合后的 block 需求叠加,SM 上能放的 block 变少,两侧都被拖慢;
- 隐式资源争用:即使显式资源不冲突,L1/L2 cache 等隐含资源仍会互相干扰;
- 返回时间变长:融合 kernel 通常比原 LC kernel 更慢,不合适地融合还会拖长返回时间,威胁 LC 的 QoS。
正因如此,直接融合会撞上三个挑战——不解决它们,融合就拿不到性能收益[2]:
表 5|Tacker 的设计挑战与对应组件[2]
| # | 挑战 | 难点 | 对应组件 |
|---|---|---|---|
| 1 | 融合要适应动态输入 | 在线融合开销高;静态融合需在运行时适配动态输入,并在有限资源下挖出两个 kernel 的最大并行度 | kernel fuser(离线融合 + Persistent Thread Block) |
| 2 | 要快速、精确地预测融合 kernel 的性能 | 融合 kernel 比原 LC kernel 慢,盲融会破坏 QoS;且融合后同一 block 内不同 warp 跑不同代码,常规线性回归失效 | duration predictor(two-stage LR) |
| 3 | 需要 QoS-aware 的在线 kernel 管理 | 同时有多个 LC/BE kernel 时,要选出既保 LC QoS、又最大化吞吐的融合决策 | runtime QoS-aware kernel manager |
Tacker 的设计总览:离线融合 + 在线决策。 图 6 给出 Tacker runtime system 的三个组件及其数据/控制流[2]:
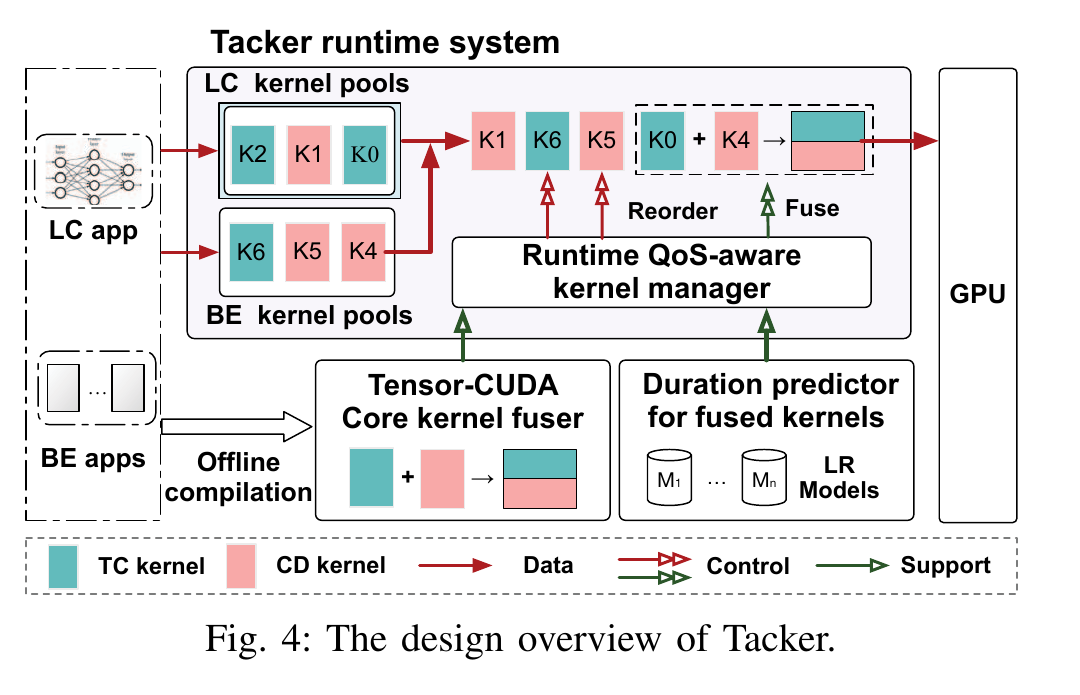
图 6|Tacker 设计总览(取自 Tacker Figure 4[2])。三个组件——Tensor-CUDA Core kernel fuser、duration predictor、runtime QoS-aware kernel manager——构成 Tacker runtime system;红色实线为数据流,红色空心箭头为控制流(Reorder/Fuse),绿色箭头为组件间的支撑关系。
数据/控制流。 分两个阶段:
- 离线:kernel fuser 从 LC、BE 的 kernel 池中取出可互补的 Tensor Core kernel(青色)与 CUDA Core kernel(粉色),静态融合成 fused kernel;duration predictor 用一组 LR 模型(M₁…Mₙ)为这些 fused kernel 建立时长预测。
- 在线:LC app 与 BE apps 的 kernel 分别进入各自的 kernel pool;runtime QoS-aware kernel manager 依据“当前可用的 kernel 集合 + 预测时长”,决定 Reorder(按 QoS 余量重排原 kernel,即 Baymax 的做法)还是 Fuse(把一对 TC/CD kernel 替换为融合 kernel)。最终交给 GPU 执行的,仍是“原 kernel 或融合 kernel”。
三个组件如何解决这三个挑战。 三个组件与三个挑战一一对应(总览见图 6):
① Tensor-CUDA Core kernel fuser —— 对应挑战 1(适配动态输入、挖掘最大并行度)。
核心思想:把一个 TC kernel()与一个 CD kernel()静态融合成一个 kernel,让同一 block 内不同 warp 分别执行两段代码,从而让两类单元同时工作。关键设计:
- 直接融合(direct fusion):合并两个 kernel 的 block;融合后每个 block 内前 个线程做 、其余做 ,用
threadIdx/blockIdx换算回原始线程 id。难点在于它需要提前知道两个 kernel 的 block 数,而 block 数由运行时输入决定;若改成运行时在线融合(等价 JIT),实测需 ~900ms,会严重破坏 LC 的 QoS。 - PTB(Persistent Thread Block):把每个已发射的 block 当作常驻 worker,用循环遍历"原来的 thread block"(
for (block_pos = blockIdx.x; …; block_pos += issued_block_num)),做完即退出。这样 block 数固定,融合可离线完成、运行时无需再改代码——静态融合却能适配动态输入。 - 灵活融合比例:SM 内 Tensor Core 强于 CUDA Core,因此先填满 TC block,再按剩余资源加入 CD block;对一对 kernel 生成所有融合版本,实测各自性能并与"不融合"比较取最优——串行更快就不融。
- 同步:不同分支的 warp 不能直接用
__syncthreads()(可能死锁、出错),改用 PTXbar.sync id, cnt;id用于避免死锁,cnt按 block 维度算出需到达该 barrier 的线程数。
② duration predictor for fused kernels —— 对应挑战 2(快速、精确预测融合 kernel 的性能)。
核心思想:融合 kernel 比原 LC kernel 慢,必须先知道"慢多少";而运行时拿不到性能计数器,所以改用模型预测。关键设计:
- 定义 load ratio (CD 段与 TC 段的原始耗时之比)。
- 实测显示融合时长是两阶段的:co-run(两段 warp 同时运行)+ solo-run(某一方单独收尾),即 。固定 TC 时长时, 对 load ratio 呈两阶段线性(存在拐点);固定 load ratio 时, 对 TC 原始时长线性。
- 为什么 LR 仍适用:PTB 下 warp 执行呈重复模式,即使融合后受访存争用影响,指令循环仍使执行规律可分两阶段回归。
- 预测三步:① 用 LR 预测 、;② 计算 load ratio;③ 用两阶段 LR 预测 。
- 建模:每个原始 kernel 一个 LR(输入 block 数);对每个 TC-CD 对在 4 个 load ratio(10%、20%、180%、190%)上采集融合时长建立初始模型,之后用在线数据更新,预测误差 >10% 即重建。
③ runtime QoS-aware kernel manager —— 对应挑战 3(QoS-aware 的在线 kernel 管理)。
核心思想:把 LC 查询的端到端时延拆开,用 QoS 余量(headroom) 决定"融/并/不融"。关键设计:
- 端到端时延 。
- 算余量:,即留给 BE kernel 的空闲 GPU 时间。
- 融合判定:当 的当前 kernel()与一个就绪 BE kernel()可融时,若 (融合确实有收益)且 (不破坏 QoS)→ 才真正融合,并把 减去 。
- 否则退化为 reorder:若没有可融的 BE kernel 且 ,直接发射该 BE kernel(等价 Baymax 的重排);若有多个 BE 应用,选择吞吐增益最大的一对()。
- 多 LC 查询并发时,优先完成先到的查询,只对最后到达的查询做 reorder/fusion。
2.2 POD-Attention:同一算子也可能具有互补资源需求
POD-Attention 的 motivation 是不同请求的 prefill attention 与 decode attention 分别偏计算和带宽受限,独立优化后串行运行,会使计算与带宽资源分阶段利用不足[8]。Figure 1 给出的利用率曲线,比单看“两个任务都叫 attention”更能说明互补性。
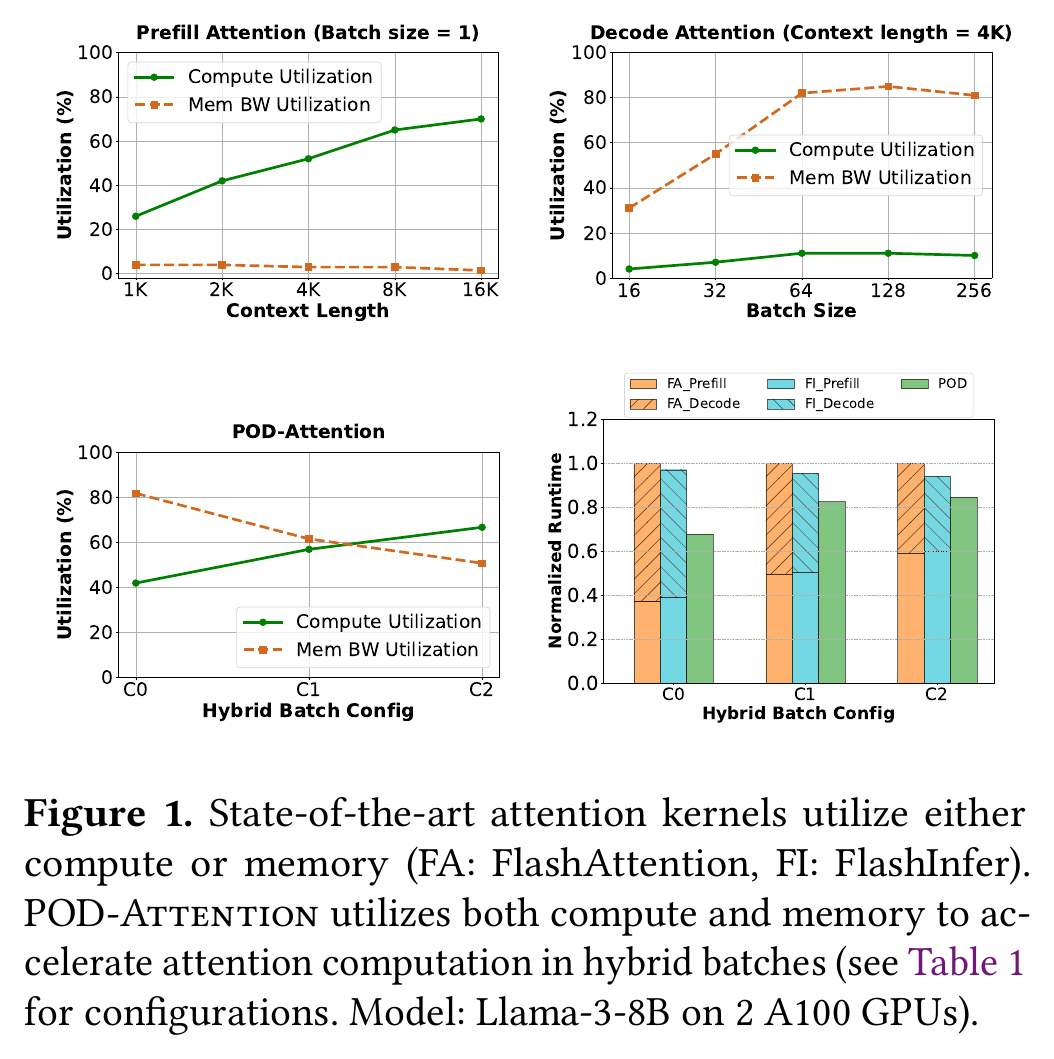
图 7|Prefill 与 decode 的计算/带宽互补(取自 POD-Attention Figure 1[8])。上:分别执行时,prefill 和 decode 具有不同的资源需求。下:POD 在混合批次中共同利用计算与带宽,并比较 attention 运行时间。图中的配置与数值对应论文所测的 Llama-3-8B/A100 场景。
它与我们的目标共享“已有就绪独立任务,且资源需求互补”的前提,最重要的补充是真实任务供给来自不同请求。图中观察的是计算和内存带宽,不是两个独立物理计算核的活跃时间线。对 NPU,应分别测量矩阵任务的向量预处理、搬运与片上存储需求,才能判断是否与另一项工作互补。
POD 的 §3–4 还明确区分了共同 CTA 生命周期与独立 CTA 调度[8]:warp-parallel 融合中,一侧先做完并不意味着整个 CTA 可以退场或被下一项工作替换;POD 通过 SM-aware 的 CTA 级组织减轻这类拖尾。它也讨论 persistent 领取任务的替代实现,但仍需要合适的放置与任务选择。可用的 prefill/decode 总需求若严重不均衡,调度仍无法凭空补足较短的一侧。
2.3 PipeThreader、MPK、VDCores:有依赖任务的流水与执行解耦
三者处理的执行约束不同:PipeThreader 显式建模专用单元,联合优化 tile 划分与流水时间表;MPK 自动生成跨算子的 SM 级依赖图,并用设备侧 persistent runtime 推进任务;VDCores 将计算与搬运拆成独立微操作,按细粒度依赖与资源就绪状态执行[4][5][6]。它们不能只按“融合了多少算子”排列,下面分别说明新增能力,以及旧表示在什么条件下不足。
共同主线:任务内部已有异构流水,但 task/kernel 边界以及封装在 task 内的执行顺序,仍可能挡住已就绪的后续工作,留下资源 bubble。 PipeThreader 让编译器排好 tile 级专用单元流水;MPK 将流水衔接扩展到整份程序的 task 之间;VDCores 进一步将计算与搬运变成独立的执行和组合单位,使某个阶段的等待不再绑定其他资源上的无关工作。这是问题与机制的对照,不代表三者直接沿用彼此实现[4][5][6]。
2.3.1 PipeThreader:软件定义的 tile 级流水
论文设计、kernel 表达、NVIDIA/Ascend 专用单元映射,以及 profiling、搜索和自动流水的区别,详见PipeThreader 与 TileLangpipethreader-detail。
核心特点:sTask/sEU 异构执行抽象,以及 tile 划分与流水调度的联合搜索。 PipeThreader 是通用 DNN 编译器,FlashAttention 是其应用之一。它将 Tensor Core、CUDA Core、TMA 等专用资源直接纳入编译器的任务放置与时间安排,使流水优化不必只依赖某个算子的手工模板[4]。
Motivation:以同质 SM 为主的任务表示,没有显式组织 SM 内的异构流水。 现代 GPU 的每个 SM 内含异构单元——Tensor Core(矩阵)、CUDA Core(通用计算)、TMA(搬运),它们各司其职。论文讨论的传统 data-parallel 抽象主要把 threadblock 映射到 SM,任务图未显式表达 SM 内不同专用单元的执行关系,因而在部分计算模式中,一些单元工作时另一些闲置。Figure 1 给出 H100 上不同实现的 per-unit 利用率[4]:
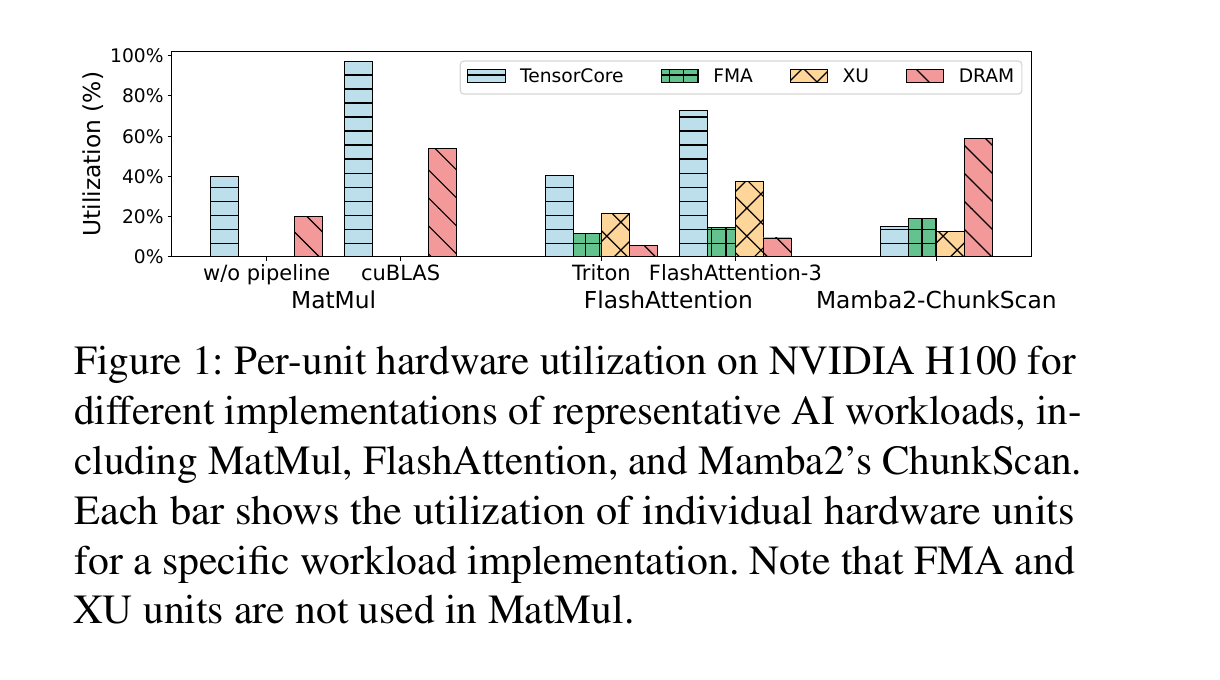
图 8|H100 上各硬件单元的利用率(取自 PipeThreader Figure 1[4])。横轴是 MatMul、FlashAttention、Mamba2-ChunkScan 的不同实现,纵轴是各单元利用率。MatMul 无流水时 Tensor Core 仅约 40%(受内存搬运瓶颈),手工调优的 cuBLAS 达 97%;FlashAttention-3 把 Tensor Core 利用率从 40% 提到 72%(对比 Triton 版 FlashAttention-2);Mamba2-ChunkScan 仅约 15%。注意 MatMul 不使用 FMA/XU 单元。
Tile 从哪里来:对同一算子/融合子图的张量索引与计算循环做分块。 一个 tile 对应输入、输出张量的一部分,以及计算这部分数据所需的循环范围。论文 §3.1 的 Figure 5 给出 MatMul-Sum 的具体例子:复用一个 的矩阵 ,将包含两个矩阵切片的 分为 (各为 );分别计算 ,再对每个 按行求和,得到 的 ,其中 。于是,同一融合计算中产生了两条分块依赖链: 与 [4]。
Opportunity:让不同 tile 的专用单元阶段交错流水。 在上述例子中, 跑在 Tensor Core, 跑在 CUDA Core。Figure 2(a) 的调度依次执行 MatMul0→Sum0→MatMul1→Sum1;Figure 2(b) 则在 就绪后启动 Sum0,同时计算只需 的 MatMul1。能够并行的是 MatMul1 与 Sum0;每条链上的 MatMul→Sum 依赖仍然保留。 分块提供了可以交错推进的工作,流水调度让这些工作在同一 SM 的不同专用单元上重叠,减少可避免的空闲[4]。
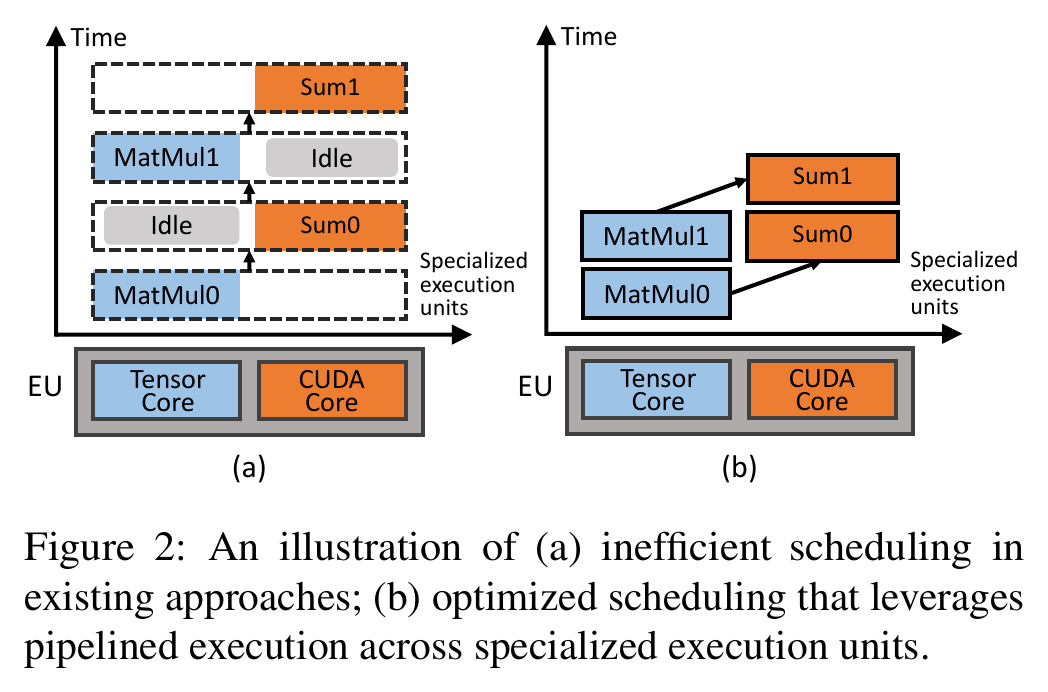
图 9|矩阵与通用计算的跨 tile 流水机会(取自 PipeThreader Figure 2[4])。左:MatMul 与 Sum 顺序推进,另一类专用单元空闲。右:满足各自依赖的 tile 交错执行。图中的时间轴向上,箭头保留了每个 Sum 对对应 MatMul 结果的依赖。
PipeThreader 把这种能力做成编译器抽象:sTask(专用任务)+ sEU(专用执行单元)。编译器选择输出 tile 的形状,沿数据依赖反推所需输入区域,并探索空间维度与归约维度的分块。各分块中的搬运、矩阵计算、通用计算被表示为映射到具体 sEU 的 sTask,保留原数据流图依赖形成 sTask-graph,再组织成 sTask-program。§3–§4 将切分、放置、执行顺序和依赖等待纳入搜索;增加重叠所需的缓冲区又与大 tile 争用片上空间,因此 tile 大小与流水深度必须联合选择[4]。
在 FlashAttention 中,tile 来自 Q/K/V 的分块及 KV 序列遍历。 论文 §3.3、Figure 7 的例子固定一块 ,逐块处理配对的 :搬运输入、计算 、执行在线 Softmax 与输出重缩放,再做 和输出累加。PipeThreader 将搬运映射到 TMA,两次矩阵计算映射到 Tensor Core,Softmax 与重缩放映射到 CUDA Core,并搜索满足依赖的跨 tile 重叠;跨 KV 块的 Softmax 统计量和输出累加依赖也需要保留。因此,这个例子包含三个动作:fusion 将相关算子放进同一 kernel 并复用中间数据;tiling 产生分块子任务;pipelining 安排不同分块的阶段重叠。 FlashAttention 已经融合,内部仍有进一步优化分块与流水的空间[4]。
旧方案为什么不足:空间并行与局部性优化没有自动给出专用单元之间的时间安排。 Rammer 的 rTask/vEU 已经支持细粒度任务与 persistent thread block[12],但主要抽象是执行单元之间的任务分配;PipeThreader §8 强调的新增维度,是一个执行单元内部不同 sEU 的流水[4]。把 MatMul→Sum 融合后,若表示仍只有一份整体任务,就没有显式暴露矩阵阶段与通用计算阶段的独立放置和跨 tile 重叠。单纯减少中间张量落地,也不会自动生成这一时间表。
手工优化的 kernel 可以利用这些硬件能力;Figure 1 的 cuBLAS、FlashAttention-3 就是例子。PipeThreader 解决的是将专用单元感知的流水表达、联合搜索与迁移做成通用编译能力。所以它不只是“再消除一个 kernel 边界”,也不能被简单归为固定模板内的手工融合。
2.3.2 MPK:把流水扩展到跨 task
核心特点:自动生成 SM 级 task/event 依赖图,再由设备侧 persistent megakernel 统一调度计算与通信。 MPK(Mirage Persistent Kernel)把整个 tensor program 的执行关系降低到 SM 级任务;其新增能力覆盖 跨算子依赖推导、代码生成和分散式 runtime 调度[5]。
先区分 kernel 与 task。 kernel 是由主机启动的 GPU 程序,一次启动通常包含许多 thread block,协作完成一个算子或一组融合算子。MPK 的 task 是编译器拆出的 SM 级工作片段,由设备侧 worker 执行;一个算子通常被分成多个 task,一个 task 也可以包含融合计算。MPK 将这些 task 的实现与调度器放进 persistent megakernel,worker 在一次持续的 kernel 执行中不断接手 task。因此,一个 task 不对应一次独立 kernel launch,两个 task 的边界也不等于两个主机启动的 kernel 边界[5](§4–§5)。
task 干什么、内部重叠什么?以矩阵乘法 task 为例。 它负责一个输出分块,沿归约维度处理多块输入:将矩阵输入搬到 shared memory,执行矩阵乘加并累加结果,最后写出输出。内部流水可以在 Tensor Core 计算第 块输入时,用 TMA 搬运第 块输入;计算第 块仍须等待这块输入搬运完成,但下一块搬运可以与当前块计算重叠。融合 task 还可能包含 CUDA Core 上的处理。task 内流水跨的是输入分块/计算阶段,MPK 的跨 task 流水则进一步衔接当前 task 的计算与下一 task 的预加载[5](§2、§4.2、§5.3)。
这里的 task 特指 MPK 的 SM 级工作片段。PipeThreader 的 sTask 是映射到特定 sEU 的专用单元任务,已可分别表达搬运与计算阶段;不能因两者都叫“任务”,就认定具有相同粒度或封装方式[4][5]。
MPK Figure 2 把同一问题扩展到搬运、矩阵和通用计算三个阶段。 一个 task 内已经有流水,但 Kernel A/B 的边界仍使后续任务不能提前预取,导致流水启动与排空之间留下气泡;统一执行范围允许跨 task 流水[5]。
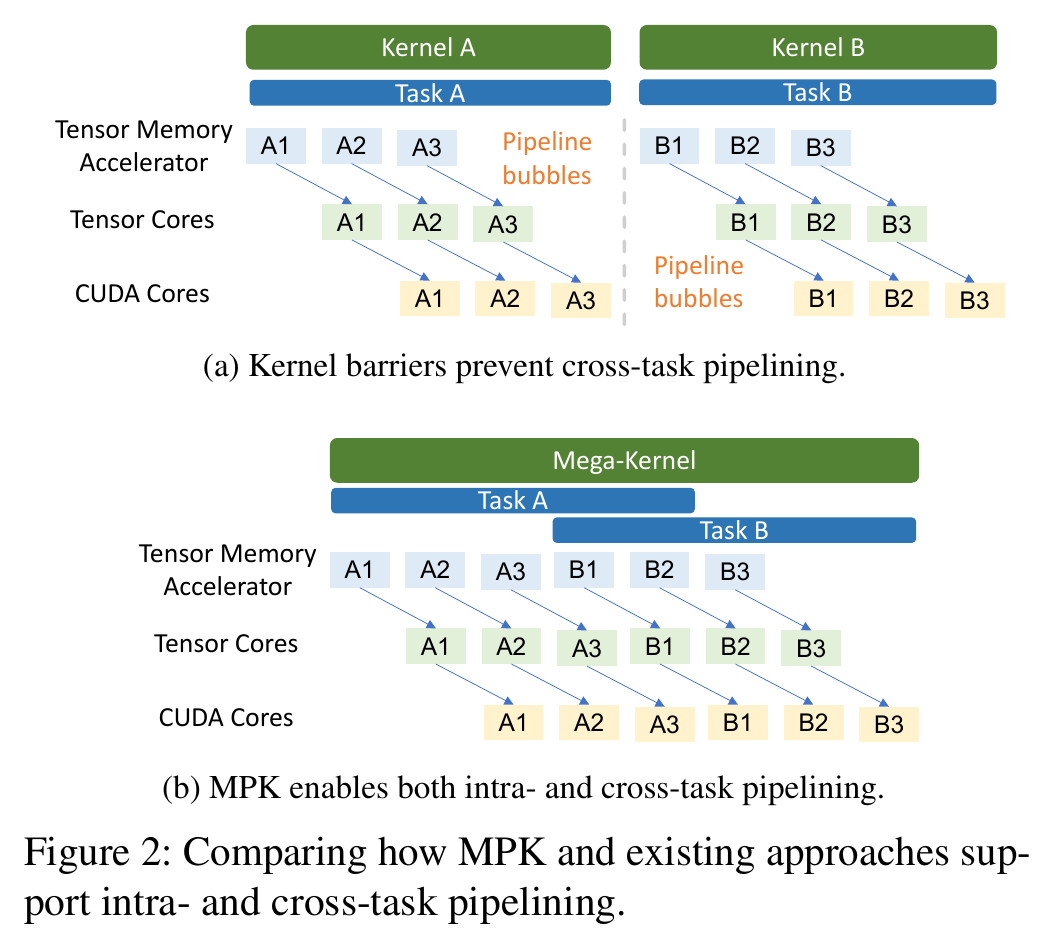
图 10|三类资源的流水被 kernel 边界切断(取自 MPK arXiv v2 Figure 2[5]mpk-figure-source)。上:任务内可以重叠搬运和计算,任务边界仍留下气泡。下:后续 task 的可执行阶段提前推进,TMA、Tensor Core 与 CUDA Core 形成连续流水。该图说明跨 task 的机会,不保证完整算子之间没有数据依赖。
MPK 已经在同一 worker 上复用不同 task 的搬运与计算资源。 §5.3 将 task 分成预加载和计算两阶段:当当前 task 已发出自身全部数据搬运指令,且有足够 shared-memory 页可用时,重叠当前 task 的计算与下一 task 的预加载。其分页 shared-memory 管理允许当前 task 逐步释放不再需要的页,立即将这些页分配给后续 task。因此,不能把 MPK 描述成“必须等整个 task 结束,下一 task 才能使用任何资源”[5]。
旧方案为什么不足:优化好一个 kernel,并不等于表示出了完整程序的细粒度跨算子依赖。 MPK §3 的 MatMul→AllReduce 例子中,某个通信片段只需要对应的矩阵输出片段;若图仍以完整 kernel 为节点,后续通信就需要等待整次 MatMul 结束。SM 级任务与子 kernel event允许在所需输入就绪后启动该通信任务,同时继续推进其他矩阵任务[5]。
CUDA Graphs 可以降低 launch 开销、组织合法并发,但在 依赖仍是完整 kernel 级的表示下,不能自动得到上述片段级重叠。MPK 引言也承认 PDL 能开放部分跨 kernel 并行;问题在于仍需修改 kernel 结构与控制流。其编译器将输入/输出区域之间的依赖自动转成任务图,runtime 再通过设备侧事件驱动执行[5]。
MPK §8 将 PipeThreader 等编程/编译抽象视为互补工具:PipeThreader 可以帮助构造一个任务的高效内部流水,MPK 负责整份程序中任务之间的依赖与执行协调。PipeThreader 也可以扩展到通信单元,因此差别不应被写成“前者只能做单 kernel、后者才能做多 GPU”[4][5]。
对任务时长不均衡,MPK 已有 JIT/AOT 混合调度。 §5.2 对易产生运行时失衡的任务采用依赖满足后分配 worker 的 JIT 模式;较稳定的任务可 AOT 预入队,以降低 dispatch 成本。它处理的是 SM 之间的工作分配与任务就绪时刻,不能据此认为固定请求的矩阵/向量总服务需求也会自动均衡[5]。
2.3.3 VDCores:按操作依赖独立推进计算与搬运
前节 MPK Figure 2 展示了跨 task 流水:一个 task 包含输入搬运、分块计算和输出搬运,内部可以重叠当前块计算与下一块搬运;MPK 再衔接当前 task 的计算与下一 task 的预加载。下面 VDCores 的原图用普通 kernel 展示资源气泡的来源:搬运与计算属于同一份工作,但它们的依赖与完成时刻并不相同,整体执行边界可能让已空闲的资源继续等待[5][6]。
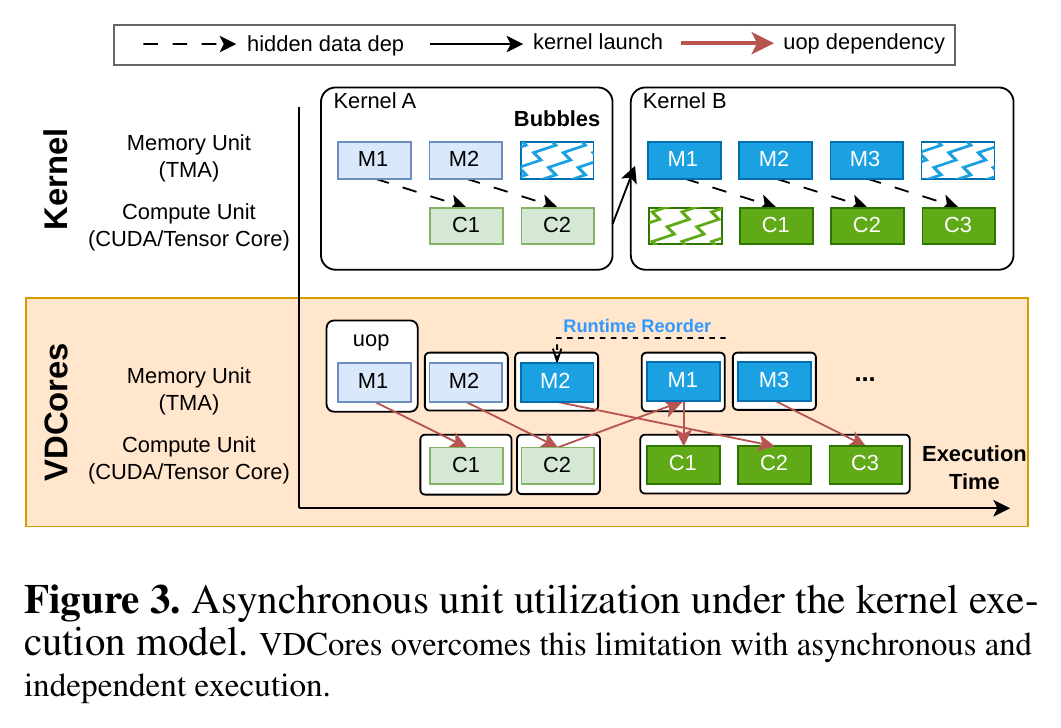
图 11|计算与搬运按真实依赖独立推进(取自论文 Figure 3[6])。上:M 表示搬运,C 表示计算;虚线表示数据依赖,整体 kernel 边界使后续工作不能及时填补搬运或计算资源的空隙。下:将工作拆成依赖相连的微操作,runtime 提前推进已就绪的搬运与计算,减少 bubble。
Motivation:已有流水的重叠方式仍由 task 的内部实现与阶段衔接规则决定,一个操作的等待可能阻挡其他无依赖的 ready 工作。 MPK 已开放跨 task 预加载,但要求当前 task 发出自身全部搬运指令,并有足够 shared-memory 页可用[5](§5.3)。VDCores Figure 4 观察到其所测 MPK 基线在 task 边界处仍有带宽下降,因而进一步探索按操作自身的依赖和资源状态推进,而不只按 task 阶段衔接[6](§2.1)。
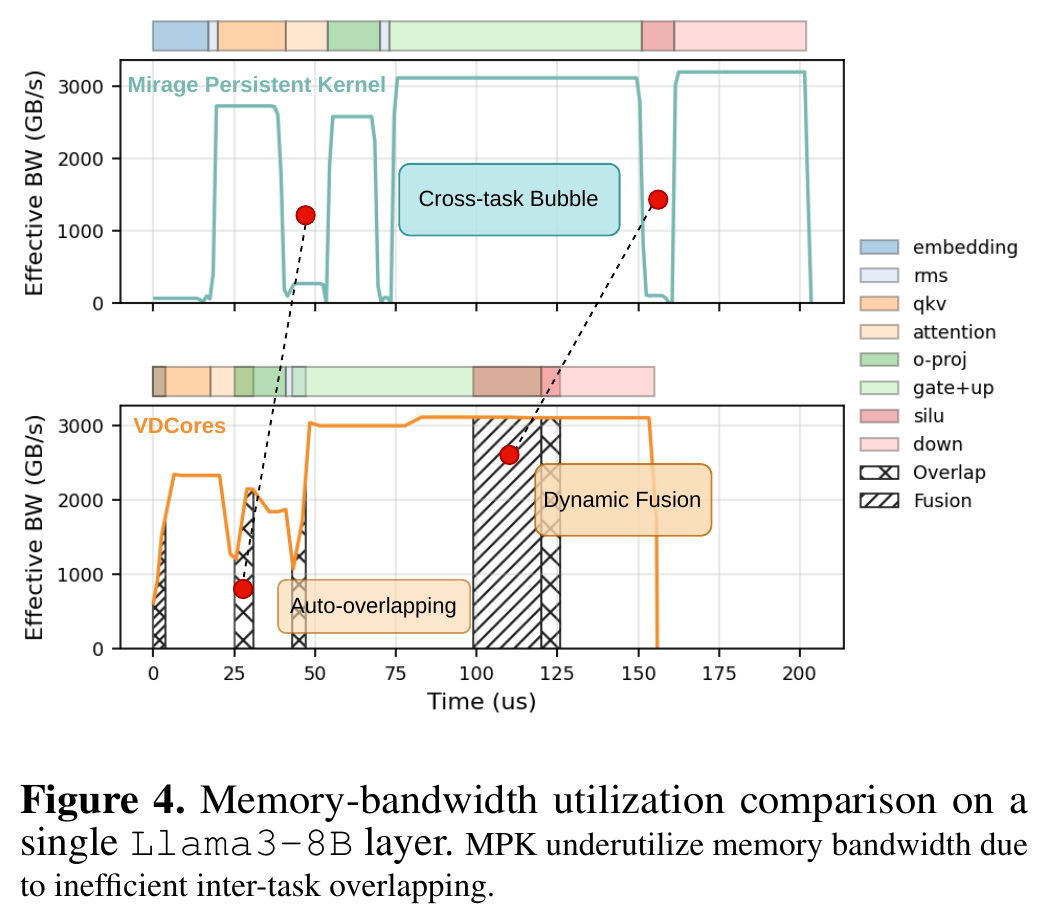
图 12|跨 task 边界处的带宽空隙(取自论文 Figure 4[6])。对比单个 Llama3-8B layer 的执行,横轴为时间,纵轴为有效内存带宽。上:MPK 在部分 task 边界处出现带宽低谷。下:VDCores 通过自动重叠与动态融合缩短空隙、改变中间数据路径;图中分别标出 overlap 与 fusion 区域。
VDCores 的做法是拆开 task 中的搬运与计算,分别交给 virtual memory core 与 virtual compute core。 两类微操作各自保留数据与缓冲依赖,由 runtime 独立推进;不同依赖链用 virtual flow 分开,流内保序,流间在资源允许时重排或重叠。这样,一个操作停顿时,另一条依赖链上的 ready 工作仍可填补空闲资源[6](§4.1–§4.2)。
例如 Figure 6 中,矩阵向量乘法需要向量与矩阵两类输入:向量加载尚在等待前驱,矩阵加载却没有这项依赖。计算必须等待两类输入,但矩阵搬运可以先执行。拆分让等待只约束真正依赖该数据的操作,避免既定顺序把等待传播给无关工作[6](§3)。
独立微操作还提供了可复用的组合单位:改变 tiling、流水或相邻算子的融合方式时,可以重组已有计算与搬运,并将满足条件的中间数据路径从 global memory 改为 shared memory,减少专门编写整体融合实现的成本[6](§2.2、§4.2.3)。Figure 11 分别验证跨 task overlap 与 virtual flow 的作用,Figure 12 验证数据路径重写带来的融合收益[6](§6.2)。
2.4 Rammer、HFuse、GoPTX:资源份额和指令等待的另一类机会
Rammer Figure 3 的观察是:一个算子可以占据很多执行单元,但每个单元内的有效工作并不充分;另一个独立算子却因资源分配而等待。降低第一个算子的并行份额,让两项工作共存,可能改善整体完成时间[12]。
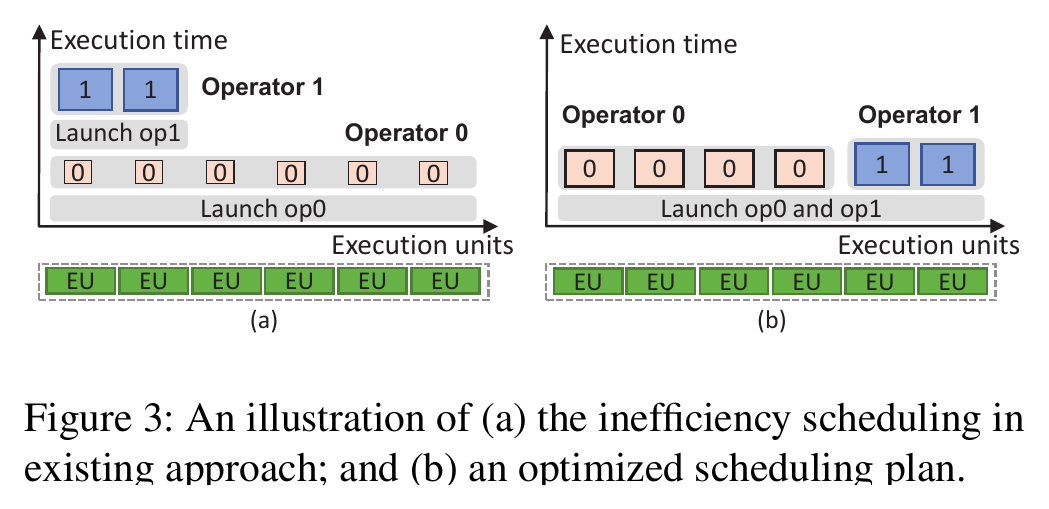
图 13|算子资源份额决定独立工作能否共存(取自 Rammer Figure 3[12])。左:算子间与算子内调度分离,两个独立算子分开占用执行单元。右:联合分配工作份额,使它们共同推进。该图讨论执行单元的空间份额,不区分矩阵核与向量核。
HFuse 的 motivation 着重于独立 kernel 指令流的线程级并行与延迟隐藏[7]:一个线程集合等待时,另一集合可以发射可执行指令,并通过线程配额与局部同步减少干扰。其资源互补实验不能直接当作 HMX+HVX 双引擎的实测证据。
局部 barrier 不等于独立任务进度。 HFuse 隔离了参与同步的线程集合,但两份工作仍处于同一 CTA 的生命周期中;较快一侧完成后,是否能继续领取其他工作,取决于具体实现。POD 对这种 warp-parallel 融合的分析明确指出了 straggler 问题[8]。因此不能把“横向融合”直接归类为“每个引擎均可持续独立领取任务”。
GoPTX 进一步观察到,原生并发下仍有大量指令等待。Figure 5 展示不同测试任务的 eligible warps per cycle(EWPC)和停顿原因,数据依赖等待构成重要限制;它因此尝试交织独立任务的指令,扩大可调度的指令空间[9]。
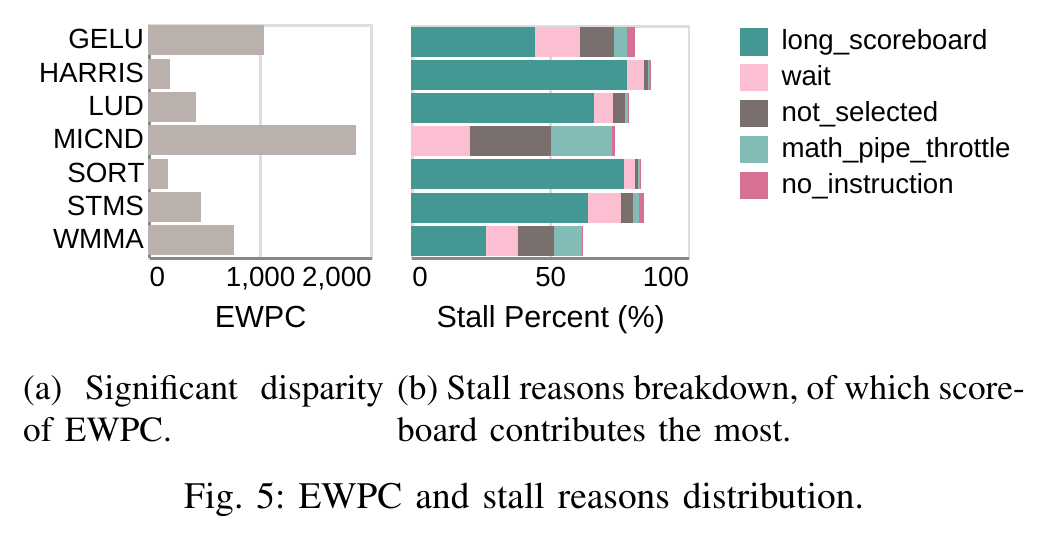
图 14|指令流中的等待也是可利用的空闲机会(取自 GoPTX Figure 5[9])。左:不同任务的 EWPC。右:停顿原因的分布。这里的证据位于 warp/指令层,而非两类计算引擎交替工作的时间线。
这组工作说明,任务独立并不保证加速,执行份额与等待结构还需要优化。Rammer 支持联合配额的动机;HFuse/GoPTX 支持内部组织与延迟隐藏。Orion 则适合作为考虑并发干扰的调度参照[13]。
3. Hexagon 上的 Megakernel:异构流水与 Bubble 消除
Hexagon 上已经有多算子融合和核内 HVX/HMX/DMA 重叠的直接先例。 EStream 将 MoE expert 子图放入一次 NPU invocation,并在不同 tile 之间组织异构流水[16];MUSE 的 NPU 执行路径重叠搬运、格式转换和 GEMM,且提供关闭转换重叠的消融[17];Hexagon-MLIR 则自动生成融合区域,结合片上 tiling、多线程和异步 DMA[11]。Scaling LLM Test-Time Compute 的论文与作者实现还展示了向量数据准备的瓶颈,以及一个量化 GEMM 内的四阶段流水[18]。
这里讨论的 bubble 消除,目标是缩小执行边界、减少可以避免的等待,以降低同一请求的完成时间。固定工作量下的总服务需求不均衡、同一份数据的真实依赖,以及流水填充/排空仍然存在。已有两类资源重叠的代码,并不能单独证明已经具备跨任意算子的 ready task 调度能力。
3.1 文献地图:Motivation、Opportunity、流水编排与设备适配
本节沿用第 2 节的逻辑:先说明现有执行为何低效,再指出哪些工作与资源可以重叠,最后比较设计如何利用机会。流水编排方式区分专用实现中预设的阶段/同步、编译器自动生成,以及 runtime 的动态任务选择;设备适配分别说明 CPU/GPU/NPU 之间的任务分配和不同芯片上的验证。所用公开版本截至 2026 年 10 月 15 日核对,EStream 为 arXiv v1,MUSE 为 v2。
表 6|Hexagon 相关工作的核心动机、执行机会与设计
| 工作与版本 | Motivation:为什么需要优化 | Opportunity:哪些工作可以提前或重叠 | 设计与流水编排方式 | 设备适配与验证范围 |
|---|---|---|---|---|
| EStream[16],2026 预印本 v1 | MoE 路由动态变化,固定图/逐 expert 调用增加开销;算子分开发起使中间数据反复落地并切断片内流水 | 相同 expert 拓扑可复用;不同 tile 的权重搬运、解码、投影和后处理可交错,expert 加载也可与 NPU 计算重叠 | 专用融合算子,流水阶段由实现预设。一次 invocation 内组织 DMA/HVX/HMX;runtime 绑定路由与权重,按 VTCM 容量选 tile,并调度 expert 参数加载 | 实测 Snapdragon 8 Elite Gen 5/Hexagon v81。作者讨论向具备可编程向量、矩阵与异步搬运接口的其他 NPU 迁移,尚未给出跨厂商验证 |
| MUSE[17],ACM MM 2026 接收稿/arXiv v2 | 检索的数据布局与 NPU 输入不匹配,搬运/转换串行使 HMX 等待;大小任务统一 offload 也无法摊销调用成本 | 批量评分与索引维护形成 GEMM;不同 micro-tile 的搬运、转换和计算可重叠,不同规模任务可分给更合适的处理器 | 专用 NPU tile 流水 + 动态 workload 调度。实现中组织 DMA/HVX/HMX worker 与 ping-pong 缓冲;系统层按任务类型路由,并让启用的设备 worker 从窗口中动态领取任务 | 支持同一 SoC 内 CPU/GPU/NPU 协作;在 Snapdragon 8 Elite 与 8 Elite Gen 5 上评测 |
| Hexagon-MLIR[11],2026 预印本 v1 | 库式算子边界增加中间张量物化,片上复用、向量执行和搬运效率不足 | 合法融合区域中的数据可留在 TCM/寄存器;计算当前 tile 时可预取下一 tile,独立 tile 可分给多个 HVX context | 编译器自动生成融合与流水。通过融合、tiling、向量化、多线程和 DMA 双缓冲降低子图;流水结构由编译变换建立 | 面向 Qualcomm Hexagon 的编译后端,支持 Triton/PyTorch 输入;论文未报告 CPU/GPU/NPU 联合放置或跨芯片适配对照 |
| Scaling LLM Test-Time Compute[18],EuroSys 2026/arXiv v1 | 反量化、布局准备与 Softmax 的向量成本限制 HMX 吞吐,调用开销影响 LLM 执行 | 减少 HVX 阶段工作,并将不同 chunk 的权重搬运、反量化、矩阵计算和输出处理重叠 | 手工优化算子与专用四阶段流水。论文优化量化布局、合并量化组和 LUT;§3.5 核对的作者实现用 DMA/HVX/HMX worker 与多份缓冲组织 GEMM 流水,按形状选择路径 | CPU host 与 NPU 后端协作,未实现的算子回到 CPU;论文覆盖 Hexagon v73/v75/v79,跨厂商迁移未验证 |
| llada.cpp[19],2026 预印本 v1 | diffusion LLM 的有效 token 与执行形状动态变化,host 映射/staging 和有限 NPU 地址空间成为关键路径开销 | 当前 NPU 算子执行期间可准备下一算子的映射与数据;依据生成状态调整计算和数据驻留 | 专用 host–NPU 调度与数据准备重叠。通过 profiling 规划驻留/临时映射,提前 staging,并按有效 token 组织算子执行;重叠主要发生在 host 与 NPU 之间 | 在 Snapdragon 8 Gen 3、8 Elite、8 Elite Gen 5 上验证;Gen 5 因 runtime 支持限制使用 CPU FlashAttention 路径 |
| DSP-MLIR[20],LCTES 2025 | 低层代码丢失滤波、窗口等领域语义,使跨操作简化与融合机会难以利用 | 利用 DSP 运算的数学性质消除冗余计算,融合相邻操作以减少中间访存 | 编译器自动进行领域重写与融合。保留高层 DSP 语义并降低到目标代码,主要优化计算与局部性,未设计 HMX/HVX 异构流水 | Hexagon v68 模拟器评测;未提供多款 NPU 实机或多设备联合调度结果 |
设计上的主要区别是机会由谁组织。 EStream、MUSE 的 NPU 内部执行和作者的量化 GEMM 实现,主要把选定阶段、worker 与缓冲写进专用流水;Hexagon-MLIR 将融合与流水构造交给编译器;MUSE 的设备任务分配及 llada.cpp 的数据准备还引入运行时决策。动态路由、tile 选择或在多款芯片上运行,与自动重组任意算子间的异构流水,是不同能力。
收益证据在下文按机制展开:MUSE 有关闭转换重叠的消融,EStream 的系统消融尚未单独隔离 HVX/HMX overlap;量化 GEMM 的四阶段组织来自固定源码,llada.cpp 的直接重叠证据位于 host–NPU 边界[16][17][18][19]。
3.2 EStream:一次 Invocation 内的 MoE 子图流水
Motivation:动态 MoE 执行与固定图接口不匹配,独立算子边界又切断片内流水。 一个请求在路由后才确定 expert、token 行和权重地址;逐 expert 图切换带来额外调用与状态管理。即使 expert 已可执行,将 gather、gate/up 投影、SwiGLU、down 投影和 weighted scatter-add 分开发起,也会反复落地中间数据,阻碍不同执行资源之间的重叠[16]。
实现:复用图拓扑,并将整个 expert 执行模式替换为一个融合算子。 §3.2 和 Algorithm 1 说明,运行时绑定路由与权重地址,再按 VTCM 容量选择 token 行和投影列的 tile。片上区域按数据生命周期划分:保留 gather 后的激活、等待 down projection 的 SwiGLU 结果,以及搬运、解码和输出的多份缓冲区[16]。
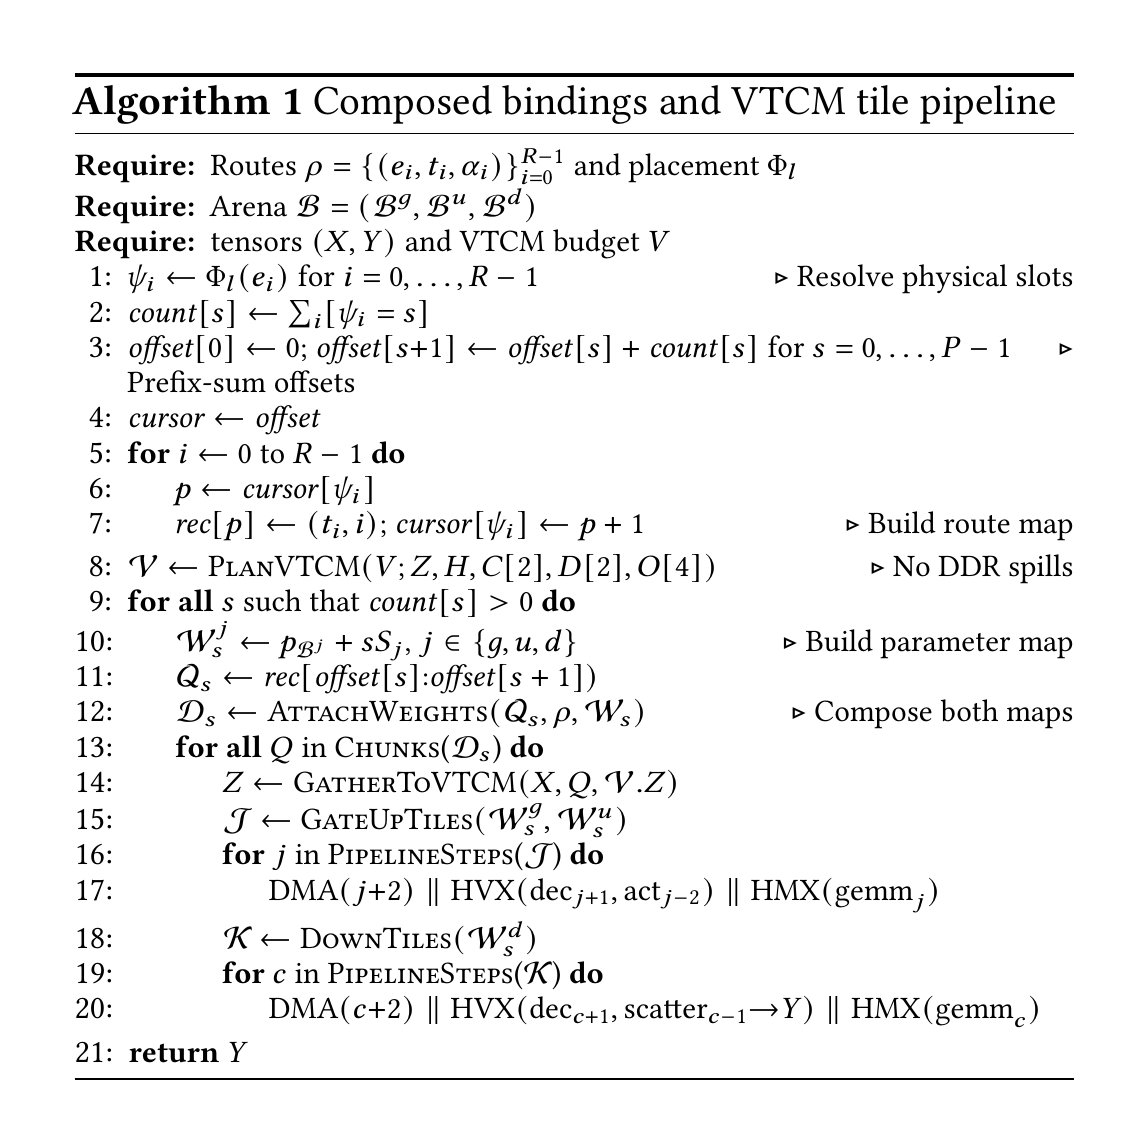
图 15|一次 Invocation 内的 DMA/HVX/HMX 流水(取自 EStream v1 Algorithm 1[16])。第 17 行组织 gate/up 阶段:DMA 预取后续权重,HVX 解码与处理其他 tile,HMX 计算当前 tile。第 20 行组织 down 阶段,并与已有输出的 weighted scatter-add 重叠。并行发生在不同 tile 上,同一 tile 的数据依赖仍然保留。
具体供给来自同一请求的 expert 计算中不同 tile 的就绪阶段:HMX 产生下一对 gate/up 输出时,HVX 对上一对做 SwiGLU;HMX 推进 down projection 时,向量阶段累加已完成的输出。论文明确将参数准备、投影和后处理放在一次 NPU invocation 内,从而同时减少 dispatch 边界和共享 DRAM 中间结果[16]。
证据边界:§5.6 主要区分常驻/流式 expert、图共享和加载流水配置,未给出单独关闭内部 HVX/HMX overlap 的对照。 因而其端到端加速包含多种机制,不能全部记为 vec/mac 重叠收益。§7 还明确指出,更低位宽或混合精度可能延长 HVX 解码阶段,破坏 DMA–HVX–HMX 的平衡;autoregressive decode 每个 expert 获得的 token 少,也未必有足够矩阵工作隐藏等待[16]。
对本课题,EStream 提供的是特定 MoE 子图的直接先例。进一步的问题是:当 token 分布、量化方案或 tile 时长改变时,如何联合选择切分、并发和缓冲区,减少暴露在请求关键路径上的 bubble?
3.3.1 Workload 与 Motivation:向量检索形成大矩阵计算
MUSE 面向图片、视频和音频的语义向量检索。媒体与查询先被编码为 embedding,检索阶段对查询向量与候选向量评分;IVF 路由、聚类分配及批量索引维护也包含密集距离/相似度计算。设查询矩阵 ,候选矩阵 ,内积评分可写为:
当 embedding 已归一化时,内积可用于 cosine similarity;欧氏距离也可由内积和向量范数组合得到。适合 HMX 的计算核心是批量评分形成的 GEMM。 视频帧、音频片段等持续入库,以及后台索引构建/维护,能提供比一次小查询更大的矩阵[17]。
Motivation:手机同时承担低延迟查询和高吞吐后台处理,直接 offload 又没有充分利用 NPU。 §3 和 §4.2 指出,host 的 FP32 row-major embedding 与 HMX 所需的 FP16 tile-major 输入不同。朴素路径串行完成搬运、转换、GEMM 和结果重建,矩阵引擎会等待数据准备;额外 host 拷贝与频繁调用还消耗带宽和启动时间。因此,问题既包括数据布局和算子内部执行,也包括哪些任务值得交给 NPU[17]。
3.3.2 实现:异构流水、索引布局与 Workload 调度
MUSE 将多个 micro-tile 合入一次设备调用,用共享内存减少 host 侧复制,并在 TCM 中组织分区 ping-pong 缓冲区。Figure 5 展示了两个关键重叠:DMA 搬运下一 tile 时,HVX 转换与打包已到达的数据;HMX 计算当前 tile 时,另一 HVX worker 对上一 tile 的输出解包并转回 FP32。 线程间通过 worker token 同步[17]。
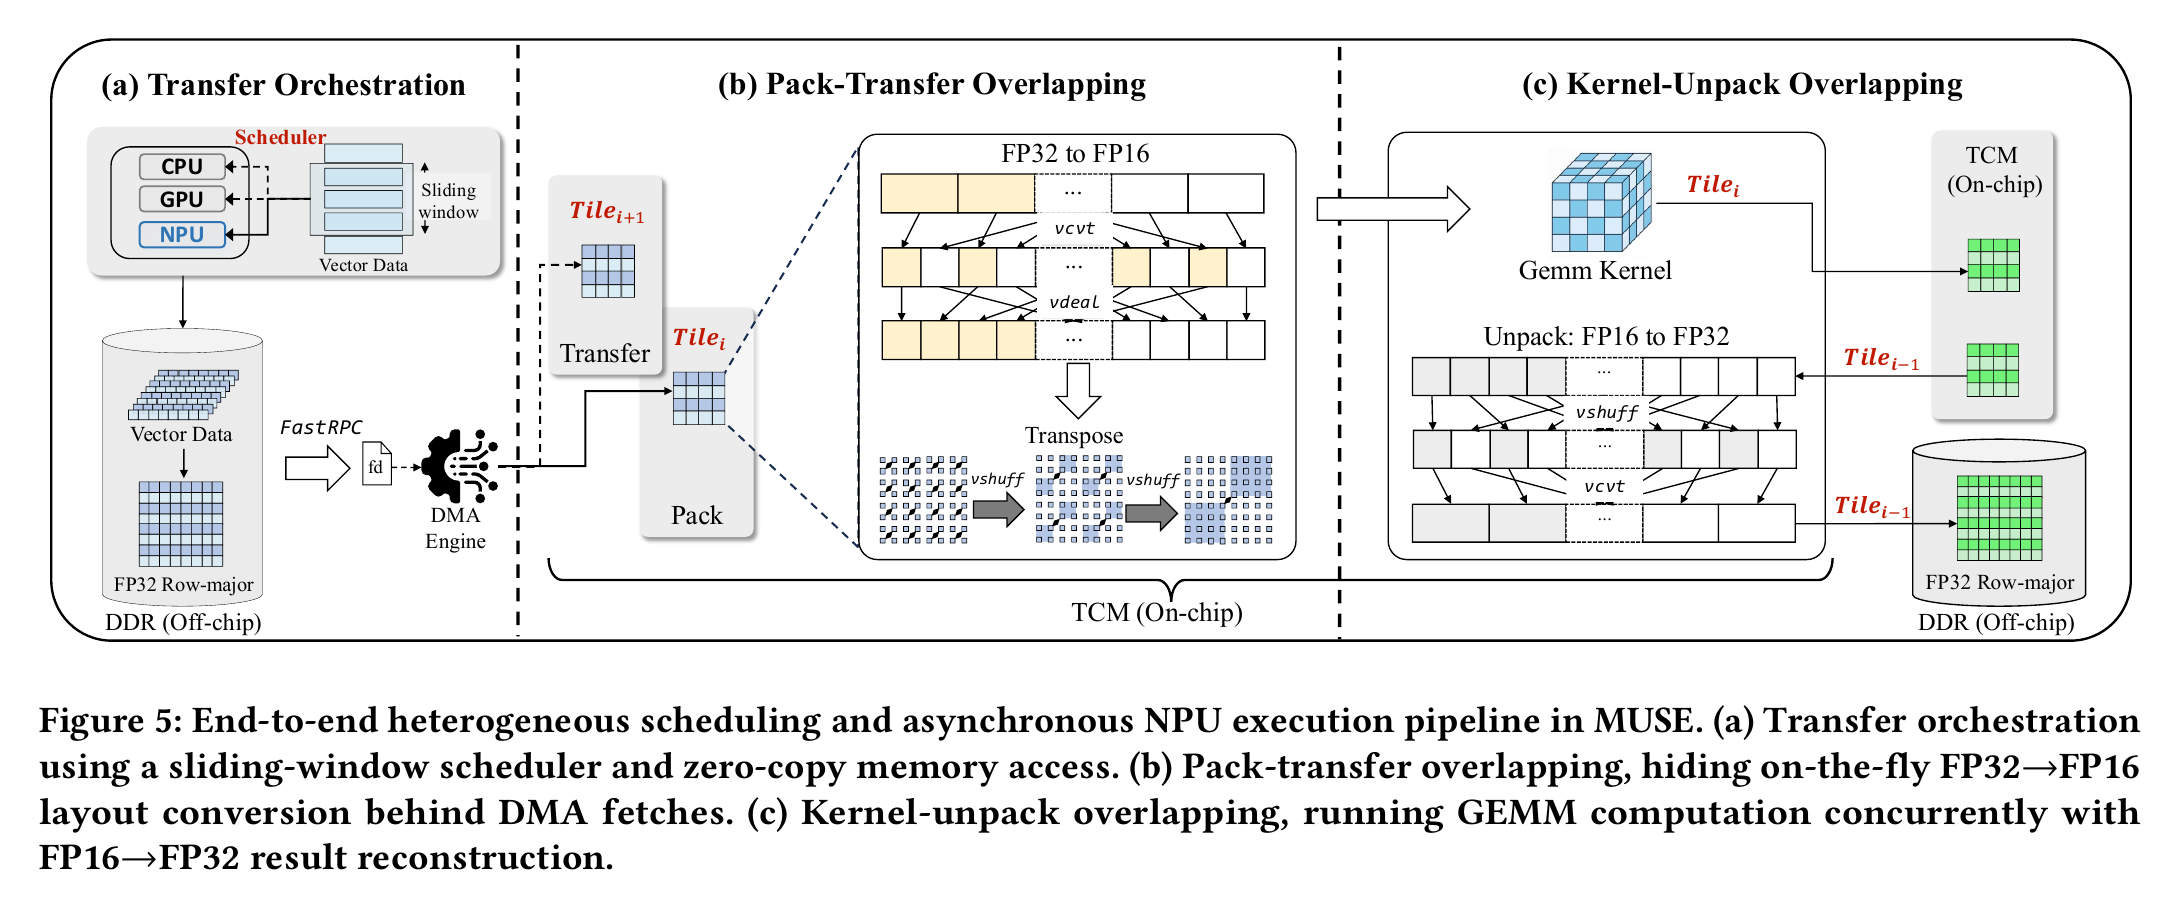
图 16|MUSE 的搬运、格式转换与 GEMM 流水(取自 MUSE v2 Figure 5[17])。左:任务放置与传输组织。中:下一份数据的 DMA 搬运与当前数据的 FP32→FP16/布局转换重叠。右:当前 HMX GEMM 与上一份输出的 FP16→FP32 重建重叠。共享 host 缓冲区减少复制,DMA 仍需将数据送入片上 TCM。
系统还采用更适合矩阵执行的 IVF 索引,按 HMX tile 几何对齐聚类配置,并依据 workload 在 CPU、GPU、NPU 之间分配任务。小型交互任务由 CPU/GPU 承担,较大的索引构建和维护任务使用 NPU 流水,避免将固定映射、启动和填充成本强加给每次小查询[17]。
3.3.3 证据:关闭转换重叠的消融与形状边界
§5.5 的消融包含 w/o Conversion Overlap,将异步 HVX 输出转换重新串行化;还分别考察片上 staging、DMA、SMT 和 I/O overlap。Figure 8 以不同矩阵形状的吞吐热图显示这些机制的影响,这比只报告融合前后的总延迟更有助于隔离核内重叠[17]。
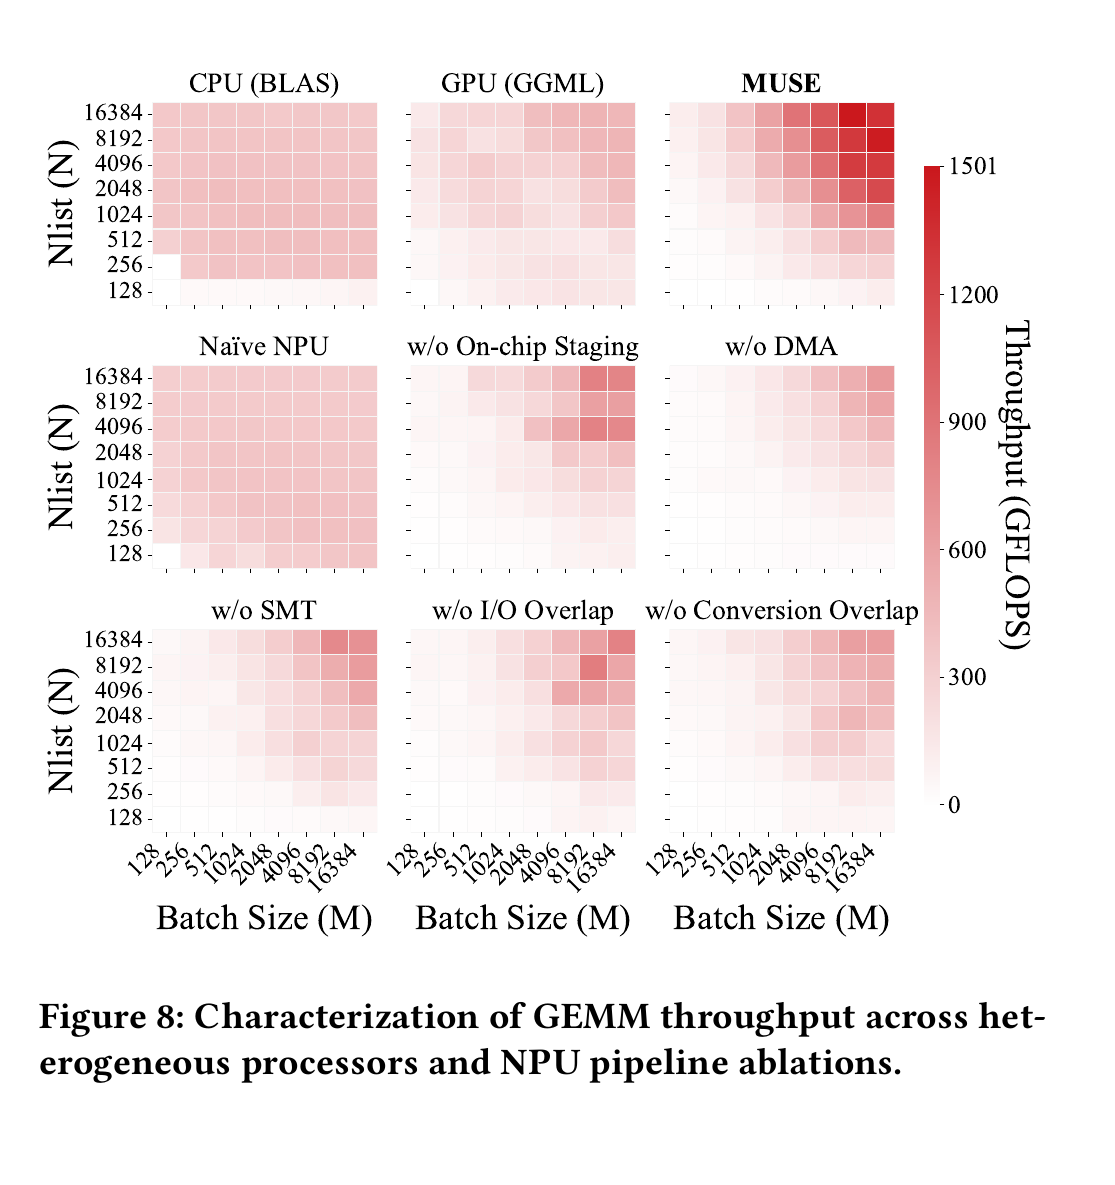
图 17|MUSE 的形状扫描与重叠消融(取自 MUSE v2 Figure 8[17])。上:CPU、GPU 与 MUSE。中、下:朴素 NPU 以及逐项关闭机制的结果;右下关闭 HVX 转换重叠。颜色表示吞吐,不能从该图推出适用于所有形状的统一加速倍率。
§5.6 明确指出,小型单查询可在 CPU 上更高效,较大矩阵才能摊销深流水与调用的固定成本。对我们的启发是采用机制消融和实际形状扫描;其大批量检索/建索引结果,不构成 batch=1 LLM decode 的直接证据。 MUSE 的 CPU/GPU/NPU workload 放置,也需要与其 NPU 内部的 tile 流水分别评价。
3.4 Hexagon-MLIR:自动生成融合区域的编译基础
Motivation 是局部性与执行效率:减少中间张量物化,并让片上数据得到充分复用。 论文明确提出生成 mega-kernels,把 Triton kernel 或 PyTorch 子图降低为较大的融合区域。§4.3–4.6 结合算子融合、TCM tiling、HVX 向量化/多线程和异步 DMA;典型流水是计算当前 tile、预取下一 tile[11]。
论文 §5 的 GELU、RMSNorm、SiLU 等实验主要分析向量化、多线程、double buffering 及其相互作用。Table 1 的向量化收益不能当作独立 vec/mac 横向融合的收益;Figure 4 的 perfect overlap 曲线也只是理想模型。§5.4 进一步说明:当计算或搬运完全主导时,双缓冲不能凭空补足另一侧服务需求[11]。
公开实现提供了进一步细化调度的 IR 基础:将矩阵乘展开为权重加载、HMX 累加、结果读取与格式转换的微操作,见 DecomposeHexKLMatmulPass.cpp 的分解过程;将初始化、HMX 锁和矩阵乘保留为可优化的 dialect 操作,见 HexKLOps.td 的宏操作定义与设计说明。
这些证据支持“能够表达更细的计算与资源操作”,尚不能单独证明已经存在自动匹配任意 ready vec/mac 任务的调度器。研究机会在于进一步联合依赖分析、异构放置、VTCM 生命周期与等待位置,而不只扩大融合区域。
3.5 Scaling LLM Test-Time Compute 与作者的四阶段实现
论文的核心瓶颈是向量数据准备能力与矩阵吞吐不匹配。 §3.3–§5 分析细粒度量化布局、反量化和 Softmax 的成本,并通过 tile-group quantization、离线权重排列、量化组合并及 LUT 降低向量阶段开销。其 Table 3 覆盖 Hexagon v73、v75、v79;这些工作能改变某一阶段的服务时间,应与纯调度重叠分开计量[18]。
§6 的常驻 DSP 控制线程轮询共享内存以接收 CPU 请求,降低通信成本;这说明调用通道的优化,不等于整个模型已融合为一个 kernel。§8 仍将进一步算子融合与矩阵 tiling/pipelining 列为改进方向。并行 test-time scaling 会增加生成候选,其工作量口径也不同于“固定请求工作量,仅改变调度”[18]。
作者代码已经有一个 GEMM 内的四阶段流水。 核对作者仓库的 mat_mul.c,可见以下组织:
表 7|作者实现的量化 GEMM 四阶段流水
| 阶段 | 主要资源与工作 | 主循环中的可重叠部分 | 固定版本源码 |
|---|---|---|---|
| A | DMA 加载压缩权重 | 提前加载后续 chunk 的权重 | 预取位置 |
| B | HVX 反量化与准备矩阵输入 | 在 HMX 推进另一 chunk 时处理后续输入 | 反量化位置 |
| C | HMX 矩阵计算 | 通过独立 worker 提交下一 chunk | 矩阵任务提交 |
| D | HVX 输出转换与存储 | 下一项 HMX 任务提交后处理已完成输出 | 输出处理位置 |
缓冲规划为 A→B 的一份量化权重缓冲区、B→C 的两份解码权重缓冲区,以及 C→D 的两份输出缓冲区,见缓冲说明。主循环在等待当前 HMX 结果后,先提交下一项 HMX 工作,再执行输出处理和后续反量化,使这些阶段跨 chunk 重叠。
它并未假设 vec/mac 等时长。源码注释明确写道:
“stage B and D (dequantize and store) are expected to be on the critical path”
对所核对的分支,矩阵形状为 乘 ;use_pipeline 的选择条件为 且 。此前还会对部分大 的形状选择另一种输出驻留实现,见入口分支。这是对流水适用形状的显式选择;代码本身没有给出跨任意算子的通用调度或流水收益消融。
这个例子还说明,逻辑阶段数不等于独立资源数。 在 B、D 无法互相并行、各阶段服务时间按实际分配容量计的简化模型中,若 分别为四阶段的每 chunk 服务时间,则稳态启动间隔的乐观下界为:
在上述 B、D 串行的条件下,只取四个阶段时长的最大值会低估向量侧的服务需求。共享带宽、同步与有限缓冲还会增加实际间隔;总延迟也包含激活准备、填充和排空。增加缓冲区可以解除容量造成的等待,却不会自动减少 。若要进一步改善,需要减少向量工作、改变切分/份额,或利用同一请求中其他合法工作填补剩余窗口。
本节实现核查固定于 htp-ops-lib 的 85eb88edcafd35afff1a43606a4c47eec9a0ca0b 与 Hexagon-MLIR 的 178e173c329322f79e88cd17847d9fad4e77b3e5;它们是公开代码快照,不能代替论文的性能消融hexagon-source。
3.6 llada.cpp 与 DSP-MLIR:相邻机制的参考价值
llada.cpp 说明单请求的资源需求会随生成阶段变化。 diffusion LLM 的有效 token 数、KV 更新和受限的 NPU 可见地址空间,共同影响设备利用率。§3.4 根据计算图组织 buffer mapping,并在当前 NPU 算子运行时,提前准备下一算子的映射与 staging 数据;§4 仍按 operator dispatch 使用设备库[19]。这是 host 数据准备与 NPU 计算重叠的证据,不能单独当作通用核内 HVX/HMX 融合的证明。其推测生成与 token 管理还可能改变实际执行工作量,评估时需要独立记录。
DSP-MLIR 的贡献是跨操作的领域优化。 它保留滤波、窗口、归一化等操作的高层语义,利用数学性质和融合减少计算或中间访存;§4 的 Hexagon 评测使用 v68 模拟器[20]。它适合帮助设计 IR 与合法融合规则,未提供独立 HMX/HVX 任务并行的实测证据。
3.7 研究定位:在失衡和有限缓冲下减少可避免 Bubble
现有证据已经回答了“Hexagon 能否实现融合和异构重叠”。本课题可以进一步收紧为:
研究问题:在单请求的既有计算图中,面对 vec/mac 服务需求不匹配、有限 VTCM 和真实数据依赖,如何自动选择融合任务、切分粒度与执行顺序,以缩短请求完成时间?
通用 megakernel 可以提供统一的依赖、任务和缓冲管理,但它需要从实际可用的并行供给出发。单请求 prefill 中的多个 token、head、expert,与单 token decode 提供的工作数量不同;不能通过额外请求或新增候选来补足一侧后,仍把收益报告为固定工作量下的调度改善。
表 8|两类可并行供给与主要调度约束
| 路线 | 合法工作从哪里来 | 调度需要解决的问题 |
|---|---|---|
| 无依赖任务的横向融合 | 原图中已经 ready、读写无冲突的不同任务 | 寻找资源互补、限制共享资源竞争,优先推进请求关键路径 |
| 有依赖子图的跨 tile 流水 | 不同 tile 上已满足生产者依赖的阶段 | 联合选择 tile 和缓冲生命周期,处理反压、填充与尾部 |
融合决策至少应依次检查:输入与缓冲区是否允许同时执行;关键路径上是否存在可利用的空闲;所选任务能否填入窗口;重叠后的共享资源竞争与调度成本是否抵消收益。调度器应处理 ready 工作的选择和局部等待,而不是承诺任意 vec/mac 总需求都能被均衡。
表 9|区分调用收益、异构重叠与失衡调度收益的对照
| 对照 | 尽量保持相同的部分 | 需要回答的问题 |
|---|---|---|
| 分离执行 → 统一调用但内部串行 | 算法、算子实现、数据布局与总工作量 | 消除调用/dispatch 边界节省多少时间? |
| 内部串行 → 开启异构重叠 | 布局、缓冲预算、计算实现与任务集合 | HVX/HMX/DMA 重叠本身贡献多少? |
| 固定流水 → 所提出的调度 | 相同任务与资源预算,保留真实依赖 | 阶段耗时变化、配对绑定或反压下,还能减少多少可避免等待? |
形状扫描应覆盖 vec/mac 工作量比例、tile 数量、阶段时长波动和 VTCM 预算。除了引擎活跃时间,还应记录 ready-but-waiting、等待原因、共享资源竞争、流水尾部,以及包含调度与数据准备的请求总延迟。EStream 可作为子图融合参照,MUSE 提供机制消融模板,作者四阶段实现与 Hexagon-MLIR 提供实现入口;最终收益仍需在目标请求图和形状上证明。
4. 一期范围
一期先完成静态独立矩阵+向量任务对,再扩展到独立 DMA。采用“现有串行、现有最佳并发、单入口内部串行、单入口内部并发”四组对照;内部串行与并发尽量共用实现,通过屏障开关隔离重叠收益。同时扫描工作量比例、tile 时长变化、缓冲深度与同步粒度,区分有效重叠、竞争成本和尾部移动。
若实验限定单请求,就固定该请求的工作量与依赖,记录其内部 ready 工作和最终完成时间;多请求/多 micro-batch 是另一项任务供给设置。可配对机会覆盖率与局部任务对的加速需要分别报告。下一阶段再加入更多任务、动态 ready task 集合和依赖图。
第三节的公开实现应纳入基线:在受控任务对确认硬件并发之后,选择一个实际单请求子图,比较现有固定流水与所提出的任务/缓冲调度。采用类似 MUSE 的重叠开关消融,分别报告调用减少、异构重叠,以及失衡条件下额外调度的贡献。
qnn-scheduling. Qualcomm QNN HTP 文档,Scheduling and Allocation:部分后台算子可拆成 launch/wait,最终调度增加并行;VTCM 地址复用可能限制重排。https://docs.qualcomm.com/doc/80-63442-10/topic/scheduling_and_allocation.html (访问日期:2026-10-11)。 ↩
mpk-figure-source. MPK 本节所用图的版本为 arXiv:2512.22219v2。https://arxiv.org/abs/2512.22219v2 (访问日期:2026-10-11)。 ↩
hyperparallel-source. 源码核查固定于 mindspore-ai/hyper-parallel 的提交 f96a3f0897304f2f6090bd88533e199c6ec5945d(2026-10-12 公开实现快照),链接均精确到代码行。该快照用于核对 launch、worker 与算子入口适配的机制,不作为论文当时实验版本的证明;论文图及章节依据 arXiv v2。 ↩
cuda-occupancy. NVIDIA. CUDA C Programming Guide,Compute Capabilities / Occupancy:每个 SM 可驻留的 block 数由最大线程数(thread slot)、shared memory、寄存器等与 block 大小的比值决定,因此 block 越大、可同时驻留的 block 越少。https://docs.nvidia.com/cuda/pdf/CUDA_C_Programming_Guide.pdf (访问日期:2026-10-12)。 ↩
hexagon-source. 核查日期:2026-10-12。htp-ops-lib 快照及四阶段说明:85eb88e 对应源码;Hexagon-MLIR 快照及微操作分解:178e173 对应源码。这些代码位置均按固定 commit 原始文件核对。 ↩
pipethreader-detail. PipeThreader 与 TileLang:kernel 表达、专用单元映射与流水搜索。 ↩
参考文献
[1] JIN Z, AI C, ZHANG G, et al. HyperParallel-MoE: multi-core interleaved scheduling for fast MoE training on Ascend NPUs[J/OL]. arXiv preprint arXiv:2605.23764, 2026. https://arxiv.org/abs/2605.23764v2
[2] ZHAO H, CUI W, CHEN Q, et al. Tacker: tensor-CUDA core kernel fusion for improving the GPU utilization while ensuring QoS[C]//Proceedings of the 2022 IEEE International Symposium on High-Performance Computer Architecture (HPCA). 2022: 800–813. https://doi.org/10.1109/HPCA53966.2022.00064
[3] ZHAO H, DENG J, CUI W, et al. Adaptive kernel fusion for improving the GPU utilization while ensuring QoS[J]. IEEE Transactions on Computers, 2025, 74(2): 386–400. https://doi.org/10.1109/TC.2024.3477995
[4] CHENG Y, WANG L, SHI Y, et al. PipeThreader: software-defined pipelining for efficient DNN execution[C]//19th USENIX Symposium on Operating Systems Design and Implementation (OSDI 25). 2025: 767–783. https://www.usenix.org/conference/osdi25/presentation/cheng
[5] CHENG X, ZHANG Z, ZHOU Y, et al. MPK: a compiler and runtime for mega-kernelizing tensor programs[C]//20th USENIX Symposium on Operating Systems Design and Implementation (OSDI 26). 2026: 1909–1926. https://www.usenix.org/conference/osdi26/presentation/cheng
[6] HE Z, SAMPSON A, ZHANG Y, et al. VDCores: resource decoupled programming and execution for asynchronous GPU[J/OL]. arXiv preprint arXiv:2605.03190, 2026. https://arxiv.org/abs/2605.03190
[7] LI A, ZHENG B, PEKHIMENKO G, et al. Automatic horizontal fusion for GPU kernels[C]//Proceedings of the 2022 IEEE/ACM International Symposium on Code Generation and Optimization (CGO). 2022: 14–27. https://doi.org/10.1109/CGO53902.2022.9741270
[8] KAMATH A K, PRABHU R, MOHAN J, et al. POD-Attention: unlocking full prefill-decode overlap for faster LLM inference[C]//Proceedings of the 30th ACM International Conference on Architectural Support for Programming Languages and Operating Systems (ASPLOS). 2025. https://arxiv.org/abs/2410.18038
[9] WU K, LIN Z, XI M, et al. GoPTX: fine-grained GPU kernel fusion by PTX-level instruction flow weaving[C]//Proceedings of the 62nd Annual ACM/IEEE Design Automation Conference (DAC). 2025: 1–7. https://doi.org/10.1109/DAC63849.2025.11132627
[10] FANG S, CHEN H, ZHANG N, et al. Dato: a task-based programming model for dataflow accelerators[J/OL]. arXiv preprint arXiv:2509.06794, 2025. https://arxiv.org/abs/2509.06794v1
[11] ABSAR M J, BASKARAN M, SHARMA A, et al. Hexagon-MLIR: an AI compilation stack for Qualcomm's neural processing units (NPUs)[J/OL]. arXiv preprint arXiv:2602.19762, 2026. https://arxiv.org/abs/2602.19762v1
[12] MA L, XIE Z, YANG Z, et al. Rammer: enabling holistic deep learning compiler optimizations with rTasks[C]//14th USENIX Symposium on Operating Systems Design and Implementation (OSDI 20). 2020: 881–897. https://www.usenix.org/conference/osdi20/presentation/ma
[13] STRATI F, MA X, KLIMOVIC A. Orion: interference-aware, fine-grained GPU sharing for ML applications[C]//Proceedings of the Nineteenth European Conference on Computer Systems (EuroSys). 2024: 1075–1092. https://doi.org/10.1145/3627703.3629578
[14] CHEN Q, YANG H, MARS J, et al. Baymax: QoS awareness and increased utilization for non-preemptive accelerators in warehouse scale computers[C]//Proceedings of the 21st International Conference on Architectural Support for Programming Languages and Operating Systems (ASPLOS). 2016: 681–696. https://doi.org/10.1145/2954679.2872368
[15] ZHANG W, CUI W, FU K, et al. Laius: towards latency awareness and improved utilization of spatial multitasking accelerators in datacenters[C]//Proceedings of the ACM International Conference on Supercomputing (ICS). 2019: 58–68. https://doi.org/10.1145/3330345.3330351
[16] ZHANG J, ZHENG Z, WU F, et al. EStream: fast and memory-efficient MoE prefill through expert virtualization on mobile NPUs[J/OL]. arXiv preprint arXiv:2609.06551, 2026. https://arxiv.org/abs/2609.06551v1
[17] ZHAO X, MA Q, ZHANG Y, et al. MUSE: a heterogeneity-aware multimedia search engine for mobile SoCs[C/OL]//Proceedings of the 34th ACM International Conference on Multimedia (MM '26). 2026. https://doi.org/10.1145/3767308.3835897. 接收稿:https://arxiv.org/abs/2511.19192v2
[18] HAO Z, WEI J, WANG T, et al. Scaling LLM test-time compute with mobile NPU on smartphones[C]//Proceedings of the European Conference on Computer Systems (EuroSys '26). 2026. https://doi.org/10.1145/3767295.3769382. 本节核对版本:https://arxiv.org/abs/2509.23324v1
[19] WANG T, SUN Y, REN J. Efficient on-device diffusion LLM inference with mobile NPU[J/OL]. arXiv preprint arXiv:2606.13740, 2026. https://arxiv.org/abs/2606.13740v1
[20] KUMAR A, KHEDKAR A, SO H, et al. DSP-MLIR: a domain-specific language and MLIR dialect for digital signal processing[C]//Proceedings of the 26th ACM SIGPLAN/SIGBED International Conference on Languages, Compilers, and Tools for Embedded Systems (LCTES '25). 2025: 146–157. https://doi.org/10.1145/3735452.3735527
© 2026 Yang Huan · yanghuan9812@qq.com