One Megakernel is Not Enough:megakernel 融合边界该在哪里切、如何预测
这篇 NVIDIA 的论文[1]回答的是与我们的 kernel-fusion 工作最直接相关的一个调度问题:融合做完之后,persistent megakernel 的边界应该放在哪里? 它的答案以 benchmark 为证——最优解既不是"整模型一个 monolith megakernel",也不是"只有 decode 用 megakernel、其余走传统 graph",而是从 0 个到 4 个 megakernel 的组合,且随模型与 batch size 变化。论文同时给出一个不端到端试跑候选组合的边界规划器(planner),用传统 graph profile 与单算子 benchmark 就能选出实测最快的设计。
按用户要求组织为三部分:研究内容总结 → 观察发现与主要观点 → 他们提出了什么。所有数字均在 H100 NVL GPU(132 SM、HBM3 94 GB、3.9 TB/s)上测得,论文用 CUDA 13.2 与驱动 595.84[1]。
首次出现的概念
- megakernel / persistent kernel:把一段连续的多个算子融进单个"常驻"kernel——一次 launch、线程块启动后不退出、在设备端接续完成多份工作,从而免去逐算子的 host launch 与 kernel 边界 barrier[1]。
- CTA(Cooperative Thread Array,协作线程组):CUDA 的线程块,是 GPU 上占用与调度的基本单位;硬件把 CTA 铺到 streaming multiprocessor(SM,流式多处理器)上执行,H100 NVL 共 132 个 SM,可同时驻留的 CTA 总量有限。
- persistent launch 与 CTA 配额:megakernel 的 launch 只发出不高于可驻留量的 CTA,这批 CTA 全程占住声明的配额、直到本次 launch 内所有任务完成才释放;期间其他 kernel 无法征用这些 CTA。
- conventional (graph) execution 与 kernel 边界:传统推理引擎(TensorRT、vLLM、PyTorch)把模型跑成一串 kernel,通常每算子(或小融合组)一个;kernel 边界是 barrier,前一个不完成、后一个不启动。CUDA graphs 把一串 launch 录制后一次回放,只消除 host 侧 launch 开销,不改变设备侧的边界语义。
- monolith megakernel:把整个模型编成一个 megakernel 的极端设计;另一极端是完全不融合的 conventional graph。
- prefill / decode:LLM 每请求的两阶段——prefill 处理整段输入上下文、只跑一次;decode 自回归逐 token 生成、反复执行。已有 megakernel 设计通常只融合 decode 阶段,prefill 仍留给传统执行[1]。
- batch size(下文记作 Bn):一次推理中同时服务的请求数,B32 即 batch 32。batch 越小、kernel 越短,launch 与等待占比越高,越有利于 megakernel 化。
- 边界规划器(planner):论文提出的组合选择框架,用传统 graph profile 与单算子 benchmark 给候选组合打分排序,不端到端试跑(详见本文 §3)。其中 profile 指对模型的现有传统实现做一次真实运行、采集到的 kernel 时长与访存流量等实测数据;benchmark 指对单个算子(或单步)单独计时。
1. 论文研究了什么
Megakernel 的收益来自在同一次常驻执行中完成多个算子:免去逐算子 launch 与 kernel 边界 barrier(术语详见上方导读块的"首次出现的概念")。已有的 megakernel 工作(MPK[2]、TileRT[3]、手工 Llama-1B megakernel[4]等)通常只针对给定模型区域构建快速 megakernel,并假设其余部分照旧——要么整个 decode 一个 megakernel、要么模型整体一个。这些工作回答"如何把给定区域做成快速 megakernel",这篇论文回答的是"哪些区域才值得做成 megakernel"。
研究对象是 streaming 推理模型:多阶段结构使得融合边界成为性能选择。以 autoregressive TTS 为例:prefill 每请求跑一次、acoustic-token 生成器每步跑一次、local transformer 每步跑 N 次、neural codec 每帧块跑一次——各阶段频率、张量形状、线程块形状都不同。论文把生成器与 codec 相对 acoustic-code 缓冲区的调度角色分别写作 producer 与 consumer,producer 组每步推进、consumer 组按帧块推进;下文"producer megakernel / codec megakernel"即指承载这两类角色的 megakernel。每一个 cut(切界)决定哪些阶段共享一次 launch 配置、线程块被持有多久、各阶段如何共享 GPU。评价指标面向实时流式服务:TTFA/TTFT(首次发布时延)、ITL/ICL、RTFx/RTF(吞吐)[1]。
这类服务的第一目标是"首个输出早日发布"。TTFA/TTFT(Time to First Audio / Time to First Token)指从请求开始到第一个音频帧块或首个 token 可发布(first publication,即首个输出可供下发的时刻)的时延;ITL/ICL(Inter-Token / Inter-Chunk Latency)是相邻 token、相邻帧块之间的间隔;RTFx/RTF 是实时倍率,RTFx > 1 表示生成快于实时播放。只要 RTFx > 1,整体响应时延就主要由 TTFA/TTFT 决定,这也是下文排序候选组合的目标分数[1]。文中引用的 p95 表示第 95 百分位时延,避免平均值被少数长尾样本拉偏。
评测走的是 benchmark 路线:三个模型 × 三种框架 × 多个 batch[1]:
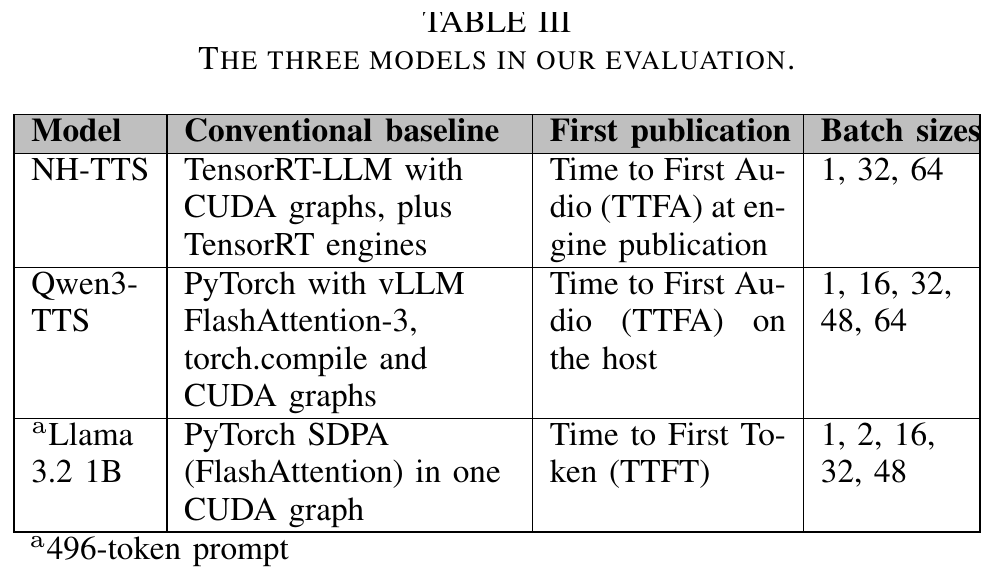
表 1|评测覆盖的三个模型(取自论文 Table III[1])。NH-TTS 用 TensorRT-LLM、Qwen3-TTS 用 vLLM、Llama-3.2 1B 用 PyTorch;首发布指标分别是引擎级 TTFA、host 级 TTFA 与 TTFT。
结论先行:跨 NH-TTS、Qwen3-TTS、Llama-1B 的 13 组 model×batch 组合中,实测最优设计用的 megakernel 数从 0 到 4 不等,没有一个 case 是"单个 megakernel";Qwen3-TTS 在 B48/B64 更是完全回到传统 graph 执行。猜错边界代价不小:NH-TTS 与 Qwen3-TTS 的次优布局比最优慢 3–29%[1]。
2. 他们的观察发现与主要观点
2.1 基准结果:三个 megakernel 赢过一个 monolith
NH-TTS 在 batch 32 下,从 81 个候选组合中实测出的六种代表布局[1]:
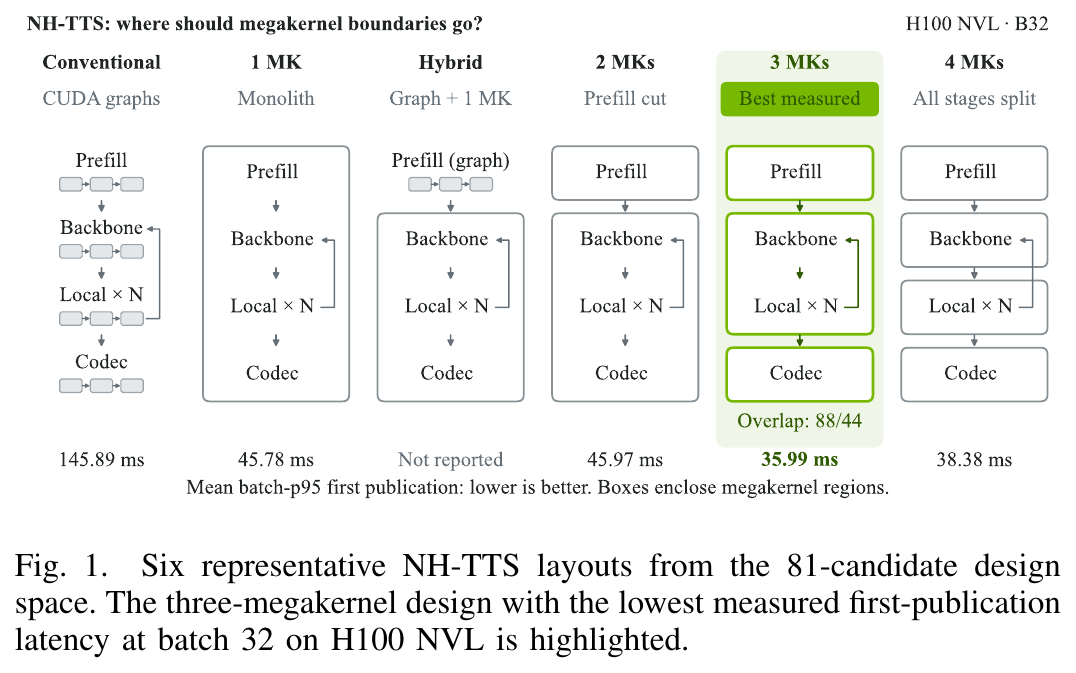
图 1|NH-TTS 的六种代表布局与首发布时延(取自论文 Figure 1[1])。框内是 megakernel 区域;3 MK(Prefill / Backbone+Local 融合 / Codec,动态 88/44 CTA 切分)以 35.99 ms 的 mean batch-p95 首发布时延最优;monolith 45.78 ms、两个 megakernel(B+L 同体,只在 prefill 处切)45.97 ms、四个全切 38.38 ms、传统 CUDA graphs 145.89 ms。
具体数字[1]:3 MK 设计的首音频发布比传统 TensorRT 流水线早 4.05×,比 monolith 提前 21.4%(TTFA 35.99 ms vs 45.78 ms),吞吐 RTFx 提 28.0%(269.430 vs 210.533):
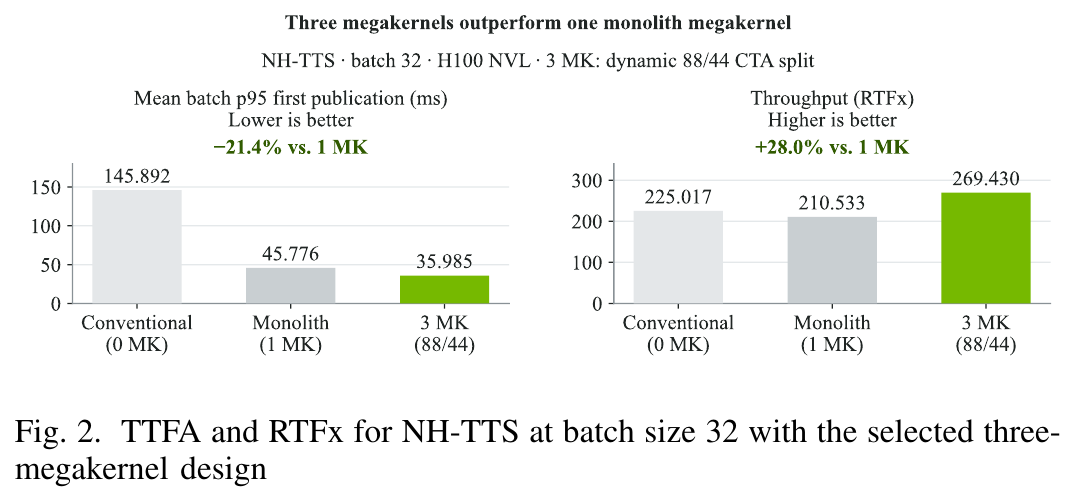
图 2|batch 32 下三种设计的 TTFA 与 RTFx(取自论文 Figure 2[1])。注意"多保留两个 kernel 边界"的 3 MK 同时改善了时延与吞吐。
这个排序在其他 batch 上也成立:B64 时 3 MK 47.4 ms、1 MK 61.0 ms、传统 221.5 ms;B1 时分别为 27.5 / 32.7 / 73.0 ms[1]。最优的 3 MK 组合结构见论文 Figure 3[1]:
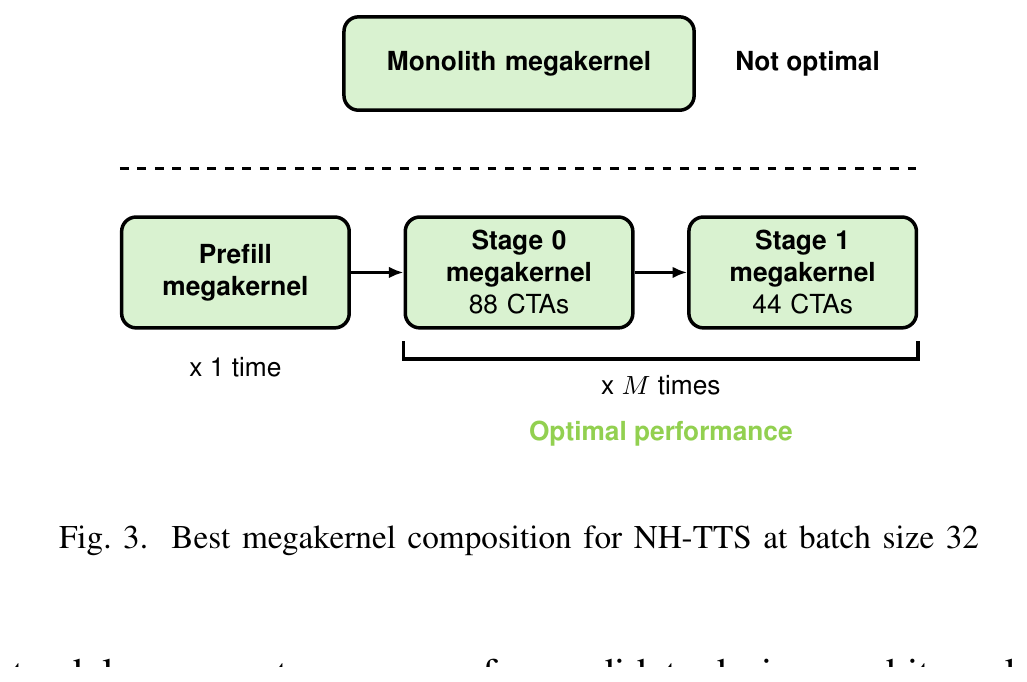
图 3|NH-TTS batch 32 的最优组合(取自论文 Figure 3[1])。prefill 一个 megakernel(每请求一次),Stage 0(Backbone+Local transformer 融合,88 CTAs)与 Stage 1(Codec,44 CTAs)各为 megakernel、每生成步都跑并动态共置。
2.2 四条观察(来自论文 §V 的 tile/event 图解释,并用实验验证)
- 更快的 kernel 可能让整条流水线更慢。megakernel 的 persistent launch 一旦发出就占住声明的 CTA 配额不放,而 GPU 上同时驻留的 CTA 总量固定,共置(co-location,即两个 launch 同时驻留同一 GPU、分摊这池 CTA)就是围绕这个配额展开的。实验把 producer megakernel 的配额从 80 个 CTA 加到 88 个:它单独跑快 2.2%,代价全由共置对象承担——旁边是 conventional codec(codec 阶段不走 megakernel、仍按传统图逐算子发 kernel)时,两边合计慢 30.3%,因为 codec 拿到的 CTA 少了 8 个;旁边是 codec megakernel(其实现契约按 44 个 CTA 的固定配额构建任务分解)时,两边反而合计快 2.0%[1]。判断"producer 加速值不值得 codec 受损",就是论文 §V 的四条观察和本文 §3 的 planner 模拟要自动化的问题。
共置代价取决于对端实现(Table II):同一资源分配下,conventional codec 在 producer megakernel 旁慢 7.57×,而 codec megakernel 只慢 1.23×[1]。机制差别在于两个实现处理"被压缩的 CTA 配额"的方式:conventional 实现的每个 kernel 按独占整卡编排 grid,被压到小配额后需要更多轮 CTA wave(即一轮 GPU 能同时驻留执行的 CTA 批次)才能完成;codec megakernel 的实现契约本来就声明在小预算下运行。论文的 service table 正是用这种 CTA-wave 近似显式建模预算压缩——grid 占 个 CTA 的算子在 个可用 CTA 下的时间按 缩放(Table I)[1]:
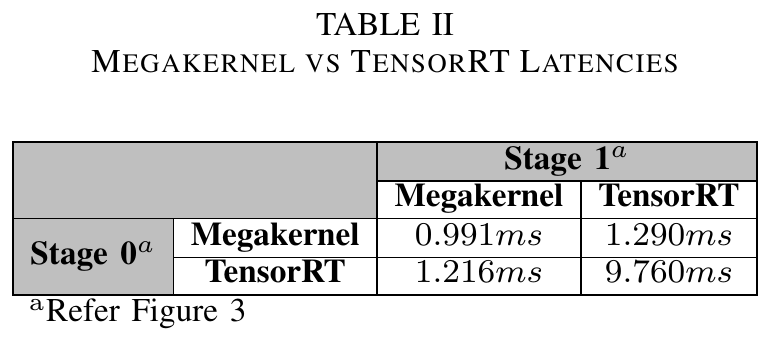
表 2|Stage 0 与 Stage 1 用不同后端的配对时延(取自论文 Table II[1])。同为 megakernel 对 megakernel(0.991 ms)远好于 TensorRT 对 TensorRT 的 9.760 ms,说明干扰程度由对端实现决定,不由"谁更快"决定。
实现与资源契约不变时,串行 cut 是中性的:monolith 与两 megakernel 设计只差一个 prefill cut,在所有 batch 下实测相差 ≤0.5%,与模型预测一致;monolith 之所以比 3 MK 慢,是它全阶段统一 512 线程块,而 3 MK 用 256 线程块跑 Stage 0——差距来自专业化程度,不是边界本身[1]。
- megakernel 的固定成本决定传统执行何时反超。launch、host 协议、内部同步等固定成本不因 batch 增大而摊薄(约 0.7–1.1 ms),而 megakernel 节省的开销随 batch 被摊薄:Qwen3-TTS 四 megakernel 的领先从 B16 的 15.9 ms 收窄到 B64 的 0.65 ms,B48/B64 传统 graph 反超;NH-TTS 的领先随 batch 继续扩大,传统执行在所有测试 batch 上从未获胜[1]。
2.3 主要观点
"融合是一个在哪里切的问题,不是一个要不要融合的问题"(§IX[1])。论文给出的判据是:让某个 region 做 persistent 每步要付固定成本 ;相对被替换的传统 kernel,该 region 在 batch 下省下 。当 时该 region 值得 megakernel 化—— 固定而 可随 batch 升、降或变号,所以最优融合范围随 batch size 移动,且不同模型朝不同方向移动。一个单独看收益不大的 region,共置时也可能获益(Nemotron 实验[1])。值得保留的边界,是那些"跨越代价高于它所保护的专门化与发布控制"的边界。
据此论文提出 四个模型类别[1](其中两类已被观测、两类为预测):
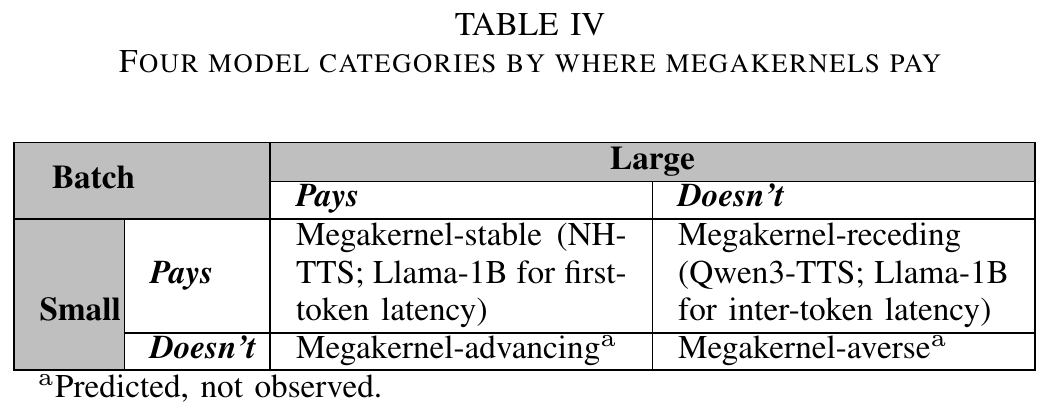
表 3|按"megakernel 在哪里划算"划分的四类模型(取自论文 Table IV[1])。megakernel-stable:小大 batch 都划算(NH-TTS;Llama-1B 的首 token 时延);megakernel-receding:小 batch 划算、大 batch 反超(Qwen3-TTS 的 TTFA、Llama-1B 的 per-token 时延);advancing / averse 是预测类别,尚未观测到。
- megakernel-stable:稳定 kernel 构成连续 region 且在各 batch 下节省都超过固定成本,并占目标时延路径的大头;
- megakernel-receding:batch 增大后节省被摊薄,传统执行反超;
- megakernel-advancing / averse:预测类别,分别对应"传统成本被与工作量成比例的访存主导"与"region 本已 compute-bound"。
3. 他们提出了什么
一个 first-publication 感知的边界选择框架:只吃三类输入——传统 graph 的 profile、单算子(或单步)benchmark、源码声明的实现契约(几何、存储、编译入口成员关系、同步);不端到端跑任何候选设计,就能给候选组合排序[1]。
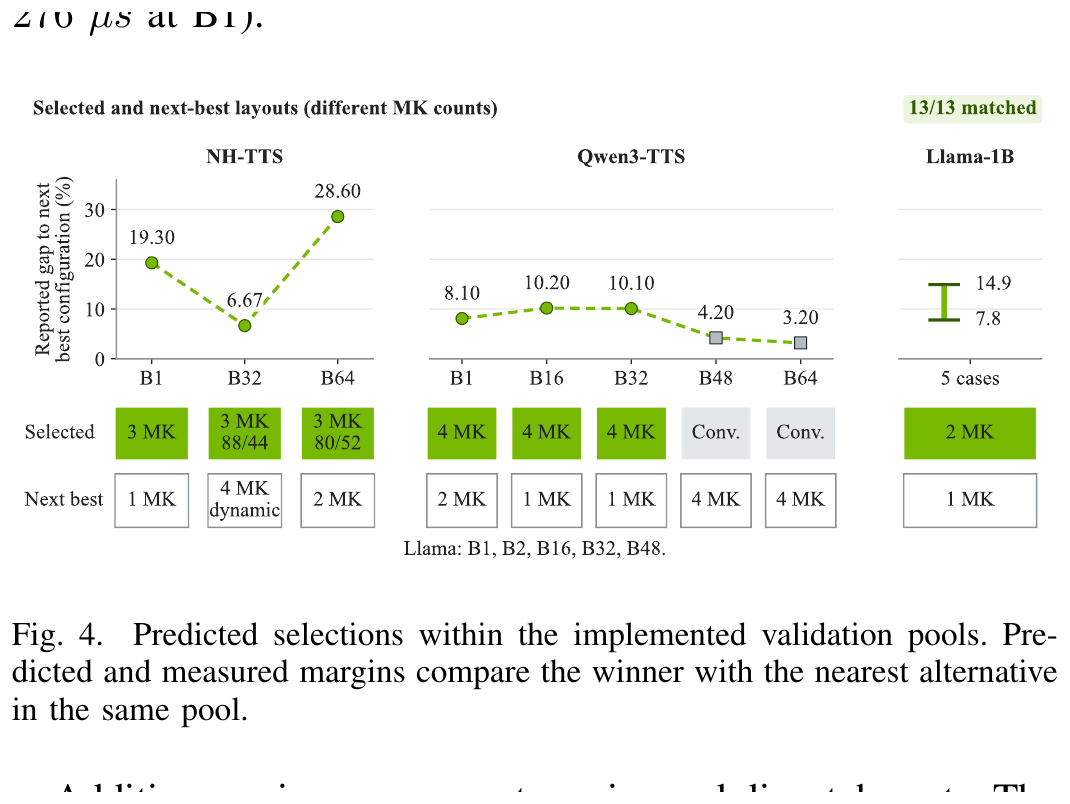
图 4|planner 在实现验证池中的预测选择(取自论文 Figure 4[1])。绿色为选中的布局、白框为次优;NH-TTS 全部 batch 选 3 MK,Qwen3-TTS B1–B32 选 4 MK、B48/B64 转 Conv.,Llama-1B 选 2 MK。
3.1 方法管线(§IV)
- region graph(rGraph):跑一遍传统 graph 实现,按执行频率把 kernel 归为 admission(每请求一次)/ producer(每生成步)/ consumer(每输出帧块)三类组,边上记录数据、状态与发布依赖。n 个组可生成 个连续覆盖(cover),每种 cover 配一种执行策略(serial / fixed split / dynamic split),并只保留实现支持的组合——NH-TTS 四组共 81 个候选[1]。
- tile graph(tGraph)+ service table:把每组算子逐步 tiling,事件驱动 list scheduler 在有限的 CTA 预算上排程,建模丢 barrier 边、权重预取、片上转发、带宽竞争、register 压力、CTA-wave 近似等机制(Table I),得出"每个组×每个后端×每个 CTA 预算"的服务时间;同一组在不同实现上下文中成本不同[1]。
- event graph(evGraph)+ 模拟:把候选 lowering 成事件图,megakernel launch 保持 CTA 持有直到所有任务完成;发布时刻 ,即取"第一个 consumer 帧块完成"与"producer 推进到满足 lookahead(多看一步确认流继续)的第 h 个生成步"两者中较晚的时刻[1];穷举评分,取分最低的候选(打平则全保留)。
- 输入成本只需分钟级——kernel benchmark 用时 NH-TTS 4.6 GPU-min、Qwen3-TTS 15.9 GPU-min[1]。
3.2 验证结果
- 选择准确率 13/13:冻结的 planner 在 13 个 held-out(开发/调参集之外的)model×batch 案例中唯一选中实测最快的设计;且预测可正确排序资源策略(88/44 vs 80/52 差 1.0%、overlap vs serial 差 4.2%)。排序对即是目标,绝对时间不可校准:3 MK 设计过预测 6–22%、Llama-1B 过预测至多 11%[1]。
- 消融定位了模拟的价值:完整 planner 13/13;"additive 评分"与"去除 overlap"各 11/13(max regret 4.50%),两个失误都发生在要求考虑 overlap 与 CTA 占用的 NH-TTS B32/B64——事件模拟的贡献集中在 overlap 敏感决策[1]。
- NH-TTS 的最佳设计(3 MK)给出 4.05× TTFA 加速(vs conventional)与 +21.4%/+28%(vs monolith 的 TTFA/RTFx)[1]。
3.3 对我们的工作的启示(对应 kernel-fusion README 的研究目标)
- 我们关注的是同一芯片内独立任务的资源互补;论文的 Observation 1 与 Observation 2 提供了一组量化警示:共置的另一端接过(或让出)CTA 时,单独测得的最快内核可能变成全局次优,因此任务配对的收益必须在"两份工作 + 各自的 launch 契约"下联合评估。
- Observation 4 的 法则说明"是否常驻/是否覆盖到某范围"应表达为随 batch 与目标指标变化的区域级决策,并按模型类别(stable / receding / advancing / averse)讨论边界——这正好为 README 中"长驻与覆盖范围是否为独立问题"提供了可量化的判定方式参考[1]。
- 方法层面,论文"用传统 profile + 单算子 benchmark + 源码契约排候选"的 first-order 建模思路,可作为我们在 NPU 上做融合边界收益预测的低成本借鉴;但其评分围绕 first-publication(首次发布)语义构建,推广到其他目标(如吞吐)需重新定义分数[1]。
参考文献
[1] CHATTERJEE A, M A J X, CHAUHAN S S. One Megakernel is Not Enough: Predicting Where to Cut for Streaming Inference[A/OL]. arXiv, 2026[2026-11-01]. http://arxiv.org/abs/2610.35336. DOI:10.48550/arXiv.2610.35336.
[2] CHENG X, et al. MPK: A Compiler and Runtime for Mega-kernelizing Tensor Programs[C]//Proc. USENIX Symposium on Operating Systems Design and Implementation (OSDI). 2026.
[3] TILE-AI. TileRT: Tile-based runtime for ultra-low-latency LLM inference[EB-OL]. GitHub repository, 2026. https://github.com/tile-ai/TileRT.
[4] SPECTOR B, et al. Look ma, no bubbles! Designing a low-latency megakernel for Llama-1B[EB-OL]. Hazy Research blog, 2025. https://hazyresearch.stanford.edu.