XDNA 2 架构与编程模型:从 AIE C++ 看矩阵乘与数据流
XDNA 2 的计算主体是一组能执行 C++ kernel 的 AIE compute tile。以 Ryzen AI 9 HX 370 / Strix 为例,完整阵列有 8 列 × 4 行 = 32 个计算核心;每个核心都有 scalar unit、vector unit 和本地 SRAM[1]。本页沿 片上结构 → AIE C++ → 矩阵乘实现 → 多核数据流 解释它的编程模型,设备身份与手册原件见归档入口。
1. 从整片阵列到一个 compute tile
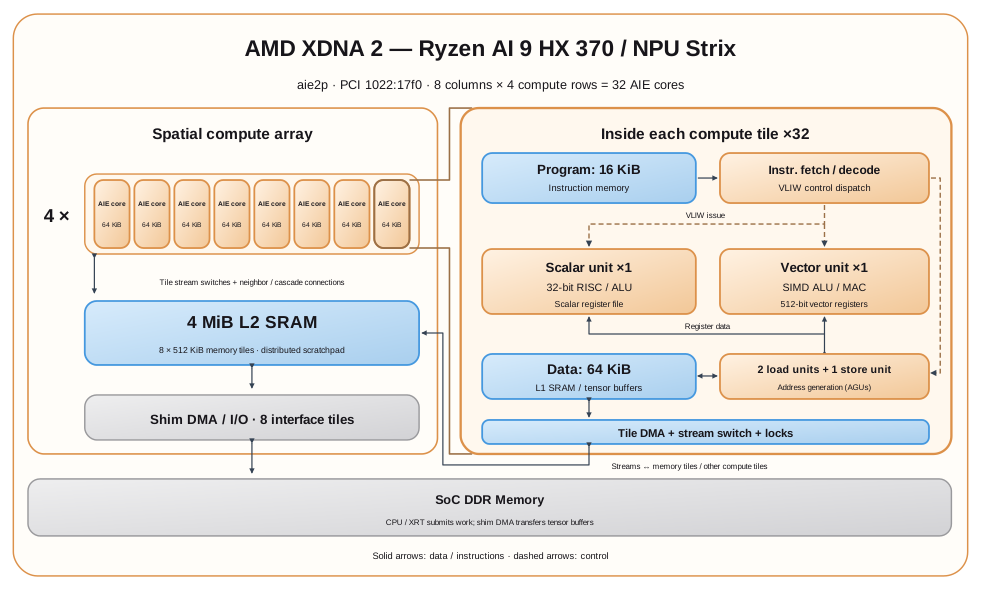
图 1|HX370 XDNA 2 阵列与单核资源(依据 AMD MLIR-AIE target model[1] 与 AIE 手册[2][3]绘制)。右侧上层是 instruction memory 与取指/译码;虚线表示 VLIW 控制分发,中层是 scalar/vector,下层实线表示 load/store、SRAM 与 DMA 的逻辑数据路径。此图说明资源关系,不代表完整的逐周期布线。
1.1 三类 tile,以及软件管理的存储
AMD 的 BaseNPU2TargetModel 将 row 0 定义为接口 tile,row 1 定义为 memory tile,row 2–5 定义为 compute tile;NPU2TargetModel 表示完整 8 列设备[1]。因此工具报告的 6×8 包含两行非计算资源,不能算成 48 个计算核心。
表 1|HX370 完整阵列的资源与编程角色
| 资源 | 数量与容量 | 编程时承担的角色 |
|---|---|---|
| Compute tile | 32 个;每个 64 KiB data SRAM、16 KiB program SRAM | 执行单核 kernel;保存局部 tensor、栈和指令 |
| Memory tile | 8 个;每个 512 KiB SRAM | 暂存、分发、重排和汇集数据,配合 DMA/stream 网络 |
| Shim / interface tile | 8 个 | 通过 DMA 在系统内存与阵列之间传输数据 |
| Compute-tile data SRAM 总量 | 2 MiB | 分布在 32 个 tile,不能当成一个统一可任意寻址的 buffer |
| Memory-tile SRAM 总量 | 4 MiB | 分布式共享暂存;连通与访问方式由数据流设计决定 |
容量分别来自 target model 的本地与程序存储定义及 memory-tile 容量定义[1]。工具链常把三层称为 L1、L2、L3:这里 L1/L2 是 scratchpad,L3 指系统 DDR/LPDDR。程序或编译器显式安排搬运、buffer 生命周期和同步;它们没有 CPU cache 自动替换与一致性的语义。
常见输入路径是 系统内存 → shim DMA → memory tile → compute-tile buffer → vector registers,输出沿配置的路径返回。邻近 tile 的内存访问和 cascade 是其他通信方式;并非每条合法数据路径都必须经过 memory tile。
1.2 单核内部:scalar、vector、访存与取指
一个 tile 内的 scalar 和 vector 属于同一个 VLIW 核心。scalar 处理整数控制、循环计数和分支,vector 处理批量算术、shuffle、乘法与累加;load/store 单元和 AGU 负责在本地内存与寄存器之间移动数据。指令取指/译码把可并行的操作分发到相应执行资源[2][3]。
这意味着 scalar 不是通过一个独立任务队列把整个 GEMM 交给 vector:编译器把 C++ kernel 调度为核心指令。VLIW 可以在资源与依赖允许时重叠访存和计算,但一次 C++ 调用并不等于一个周期,也不保证 scalar/vector 每个周期都同时工作。
还要把三个「宽度」分开:
- Vector 的元素数:512 bit 可容纳 64 个 INT8 或 32 个 BF16 元素。
- Load/store 数据通路宽度:本版本 NPU2 模型继承的单条访存数据总线宽度为 256 bit;512-bit vector 不代表一次物理 load 就取齐 512 bit。
- 对齐要求:NPU2 对全宽 vector 访问要求 512-bit,即 64-byte 对齐。对齐粒度与数据总线宽度是两件事[1]。
更大的 C++ vector 可能由多个物理寄存器和多条操作组成。寄存器位宽、输出 accumulator lane 数、一次矩阵乘包含的乘积数,以及每周期吞吐,也不能相互替代。
2. 为什么图上没有独立的 MAC unit?
MAC(multiply-accumulate)描述乘加操作:
要在矩阵乘中执行它,硬件需要操作数选择/排列、乘法器、乘积归约、accumulator 以及结果转换等路径。它们可以被画在一个独立矩阵块里,也可以是可编程 vector unit 内部的资源。
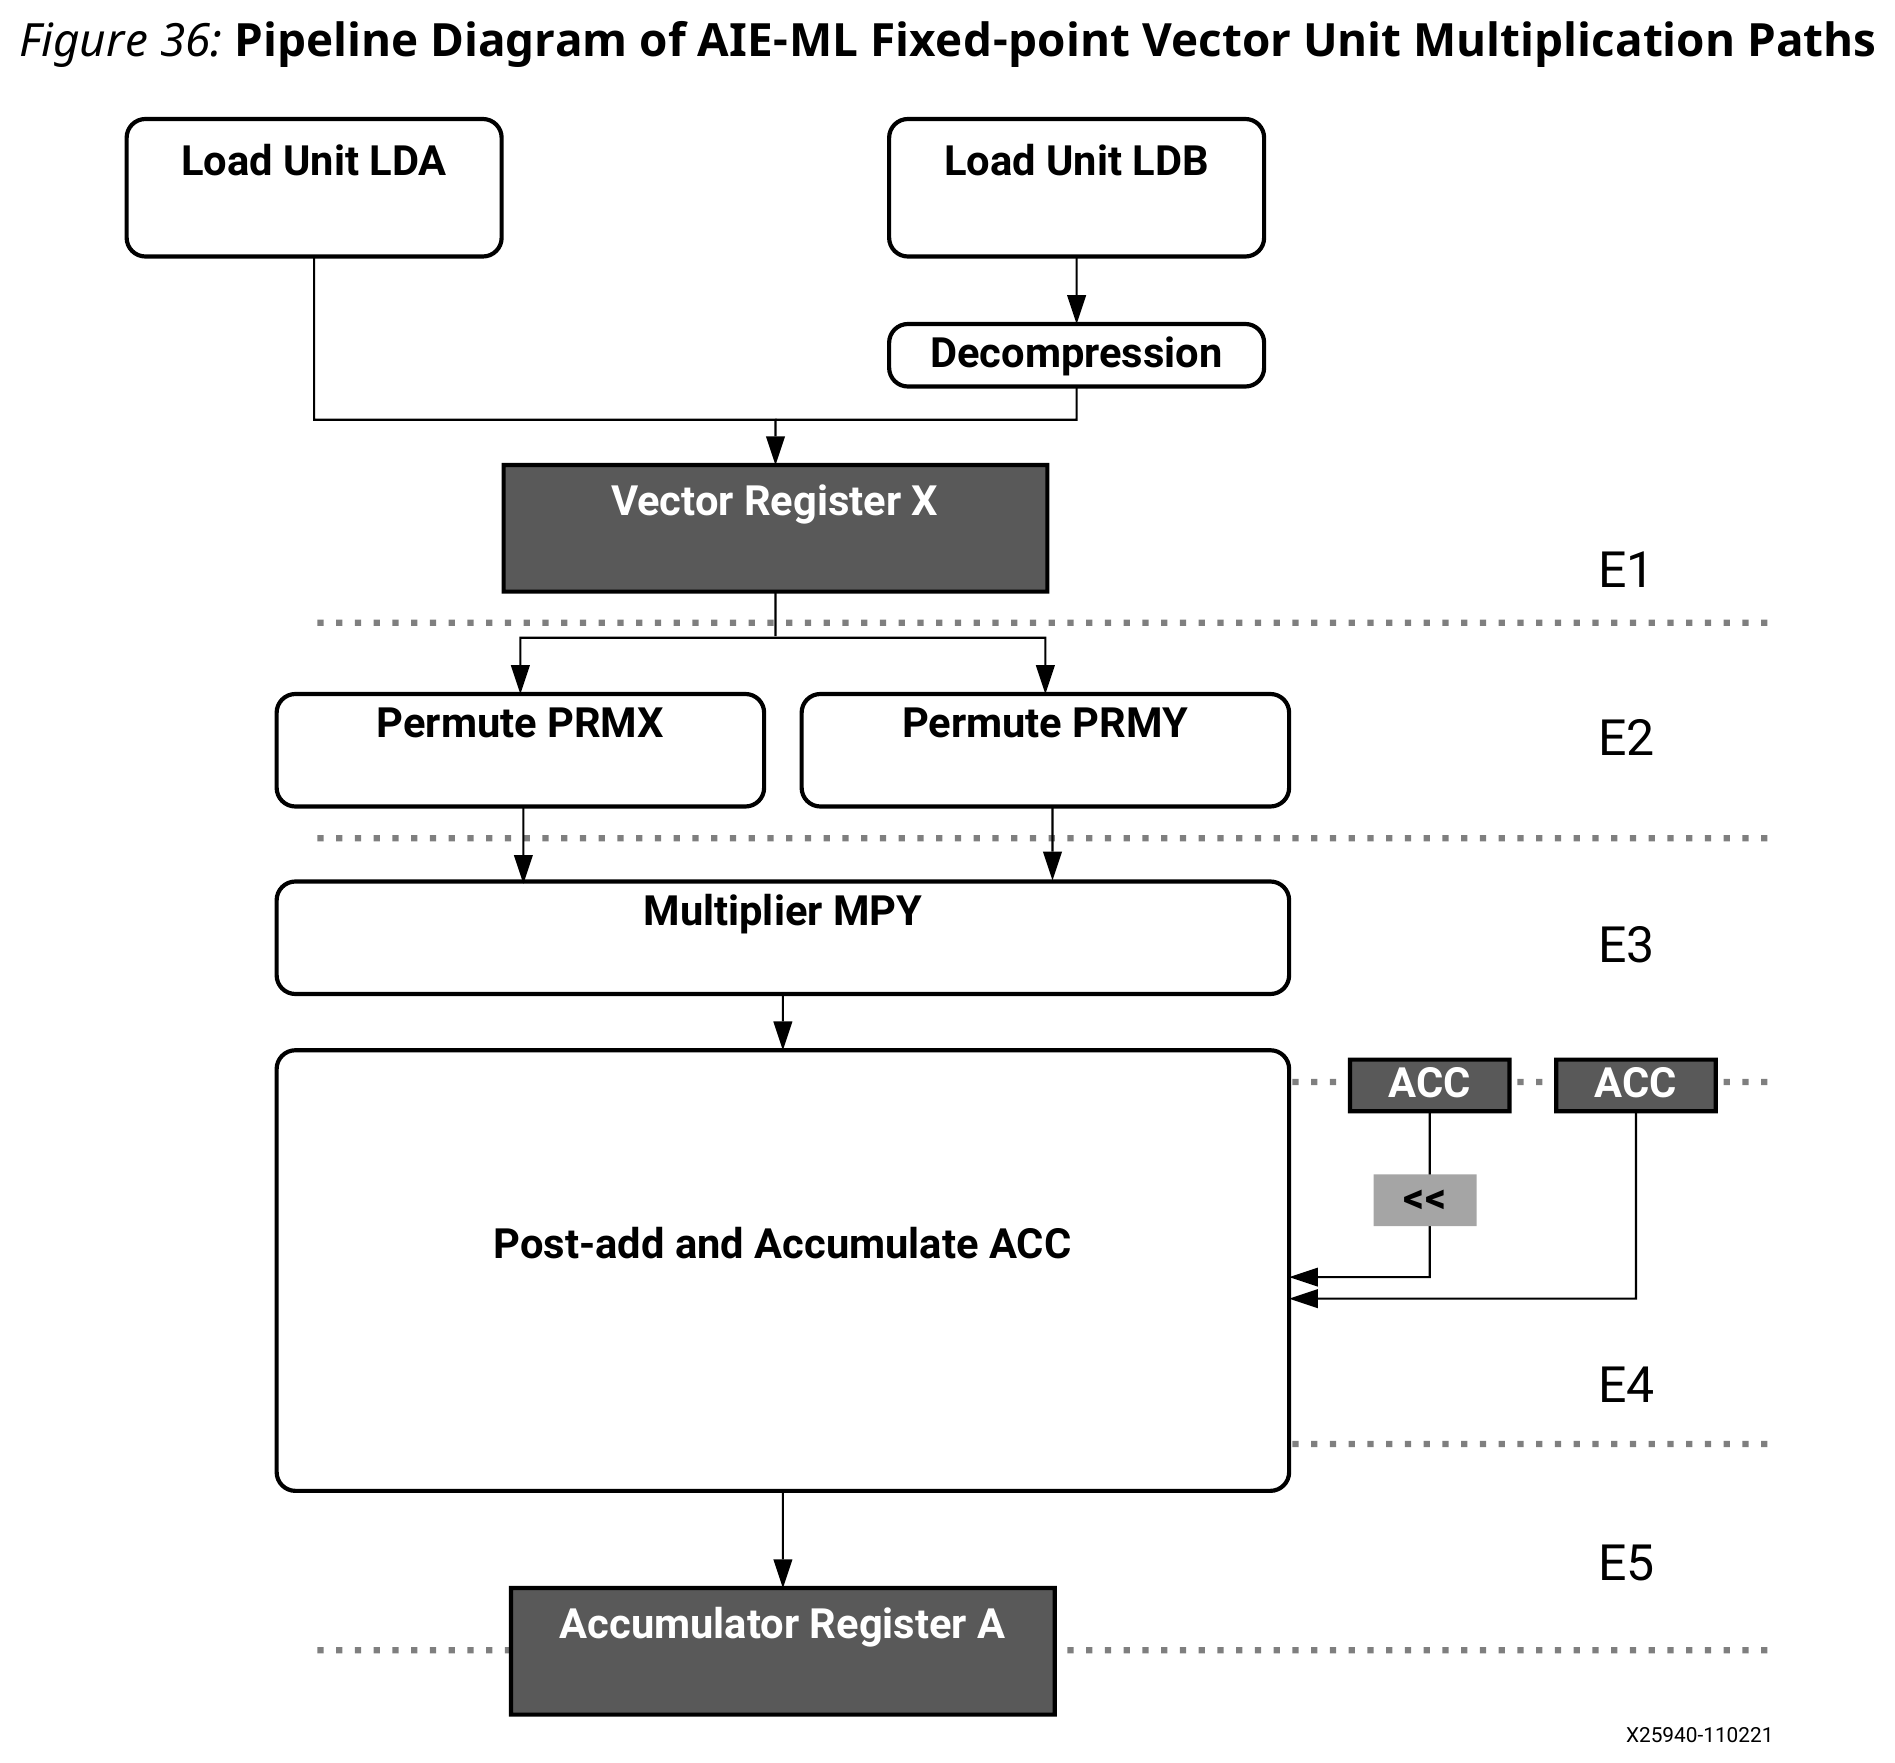
图 2|AIE vector unit 内部的乘法与累加路径(取自 AMD AM020 Figure 36[2],保留原图题)。图中有 operand permute、Multiplier MPY、Post-add and Accumulate ACC、Accumulator Register。这张图属于 AIE-ML,用于说明 MAC 在 vector unit 内部的组织方式;不能据此把其具体流水级数或吞吐直接套到 HX370 的 AIE2P。
AM027 的第 39 页总图同样把算术资源归入 vector unit,第 40 页进一步列出 vector multiplication 与 MAC 能力[3]。这能解释图的命名,但 AM027 的产品对象是 Versal AIE-ML v2,不是 HX370 的完整 ISA 规格;其 FP8、FP16、MX 格式和吞吐表不能直接当成 Strix 能力表。对 HX370 的编程路径,本页继续以明确选择 AIE2P 的源码为依据。
在源码里,NPU2 的目标架构返回 AIE2P;单核 kernel 的架构选择将编译器宏值 21 识别为 AIE2P,AIE API 再选择对应的矩阵乘实现[1][4]。因此下文分析的是 AIE2P 分支,而不是根据同族手册猜测实现。
对照其他端侧 NPU 时,结构差异更容易看清:Hexagon 常把 HVX 与 HMX 分别画成向量/矩阵资源;RKNPU 常把 CORE MAC/CACC 画成卷积流水线的一段,见 RKNPU 硬件架构。XDNA 2 则把可编程 scalar/vector 资源重复到许多 tile,矩阵计算发生在各个 tile 内。这并不意味着矩阵乘只用普通 scalar ALU,也不意味着整片只有一个乘加器。
3. AIE C++:向量操作数与 accumulator
3.1 一个矩阵 API 的三个尺寸
AIE API 的 aie::mmul<M, K, N, TypeA, TypeB, AccumTag> 表示一个固定形状的小矩阵乘:输入分别是 与 ,结果是 [4]。这里的尺寸是 micro-tile,并不是整层模型的 GEMM 尺寸,也不是芯片上的 tile 数。
该 API 的操作数元素数定义分别为 、、;输入微块在普通 vector 接口中按 row-major 布局解释。它的两种操作有不同语义:
mul 覆盖旧 accumulator,mac 保留并累加已有结果。结果首先驻留在 accumulator 表示中,之后用 to_vector 转为输出数据类型,再写入 SRAM。输入 BF16 不意味着累加器也只有 16 bit;默认 BF16 路径使用 FP32 accumulator,具体实现见微块 specialization与向量乘加 helper。
3.2 INT8 的 8×8×8:直接追到 MAC intrinsic
AIE2P 的 mmul_8_8<8, 8, 8, ..., 32> specialization 使用两个 64-element 输入 vector,以及 64 个 32-bit accumulator lane。其 mul 直接调用 mul_8x8_8x8,其 mac 直接调用 mac_8x8_8x8_conf[4]。
一次这样的微块乘法计算 64 个输出,每个输出沿 K 归约 8 个乘积,因此数学工作量为:
这里按乘法和加法各算一次 operation。512 是一个微块的数学乘加次数,不能直接当成已验证的 MAC/cycle。 吞吐还取决于 intrinsic 的指令 lowering、发射间隔、访存、依赖与 dtype;全片 TOPS 还要考虑时钟、实际运行的 tile 数,以及 dense/sparse 口径。
3.3 一个最小 INT8 kernel
下面是依据公开矩阵 API和AIE2P INT8 实现写的教学 kernel:在一个 compute tile 上,沿 K 方向累加若干对 8×8 微块,得到一个新的 8×8 INT32 输出。它展示寄存器计算路径;不包含 host、DMA 配置或多核分发。
#include <aie_api/aie.hpp>

// Preconditions:
//   chunks >= 1; A_packed, B_packed and C_block are 64-byte aligned.
//   Each input consists of chunks consecutive row-major 8x8 micro-tiles.
//   The accumulated result fits in int32.
extern "C" void mmul8x8_kchunks(
    const int8 *__restrict A_packed,
    const int8 *__restrict B_packed,
    int32 *__restrict C_block,
    unsigned chunks) {
  using Micro = aie::mmul<8, 8, 8, int8, int8, acc32>;
  Micro c;

  auto a = aie::load_v<Micro::size_A>(A_packed);
  auto b = aie::load_v<Micro::size_B>(B_packed);
  c.mul(a, b);

  for (unsigned q = 1; q < chunks; ++q) {
    a = aie::load_v<Micro::size_A>(A_packed + q * Micro::size_A);
    b = aie::load_v<Micro::size_B>(B_packed + q * Micro::size_B);
    c.mac(a, b);
  }

  aie::store_v(C_block, c.to_vector<int32>());
}
这段代码的关键是 load 输入 vector → 初始化 accumulator → 多次 MAC → 转换并 store。其中 load/store 的用法与 AMD 的实际矩阵 kernel、结果写回一致;它们操作的是 AIE 可访问的 buffer,不能把宿主机普通指针直接传给 NPU 后当成 DDR 的透明访问。
首轮使用 mul,避免读取尚未初始化的 accumulator。后续 mac 跨 K 微块累加;INT32 输出 vector 有 64 个元素、合计 2048 bit,因此一次 API store 也不能等同于一条 512-bit store。若输出收窄到 INT8/INT16,还要明确 shift、rounding、saturation 与量化规则,不能只修改模板输出类型就声称数值等价。
4. 同一个矩阵 API,INT8 与 BF16 的指令路径不同
4.1 默认 BF16:矩阵接口展开成向量 MAC
默认 BF16 的 mmul_bf16_bf16<4, 8, 8, ..., 32> 接收 32 个 A 元素与 64 个 B 元素,产生 32 个 FP32 结果。乍看它也只是一次矩阵乘调用,但向下追到 mac_4x8_8x8_bf16,实现会先 shuffle/broadcast,再沿 K=8 进行 8 次 32-lane 的 elementwise MAC intrinsic 调用[4]。
这相当于每次更新全部 32 个输出的一项乘积,8 次完成归约,总共 次数学 MAC。它仍然使用硬件 vector MAC;「矩阵 API 被软件展开」不等于「用 scalar 模拟乘加」,也不等于「没有 MAC 硬件」。
4.2 可选 BF16 → BFP16:改变实现,也改变数值路径
AIE2P 还可以开启 AIE_API_EMULATE_BFLOAT16_MMUL_WITH_BFP16。该分支会把 BF16 操作数转换为 BFP16,再调用 block-format 矩阵 intrinsic;8×8×8 的转换和乘加实现与默认 BF16 路径不同。AMD 的上层 kernel 也相应更换微块形状[1][4]。
表 2|本页固定源码版本中的典型矩阵乘路径
| 输入与路径 | Micro-tile M×K×N | A / B / C 元素数 | C++ 实现透露的信息 |
|---|---|---|---|
| INT8,直接矩阵 intrinsic | 8×8×8 | 64 / 64 / 64 | 一次微块 MAC 直接调用整数矩阵 intrinsic |
| BF16,默认路径 | 4×8×8 | 32 / 64 / 32 | shuffle/broadcast + 8 次向量 MAC |
| BF16,通过 BFP16 转换 | 8×8×8 | 64 / 64 / 64 | 类型转换 + block-format 矩阵 intrinsic |
表中列的是接口与源码路径,不是三种模式的周期数或实测性能排名。BFP16 带有块共享指数,转换与舍入可能改变结果;AMD 的矩阵 kernel 对该分支专门设置舍入方式。选择它时必须重新检查精度与性能,不能将其吞吐包装成默认 BF16 的等价吞吐。
5. 从一个 C++ kernel 到完整 NPU 程序
5.1 三个层级的 tile 不要混淆
编程中常同时出现三种分块:
- Hardware tile:芯片上的一个 compute tile,执行一个核心程序。
- Buffer tile:DMA/FIFO 传输的一块 tensor,例如 与 ,必须与 SRAM 容量匹配。
- Micro-tile:矩阵 intrinsic 的小形状,例如 INT8 的 8×8×8,是 buffer 内部的寄存器计算粒度。
AMD 的单核矩阵乘示例先确定 buffer 的 m/k/n,再读取对应 kernel 的微块形状并检查整除关系。一个核心可以循环计算很多 buffer tile,一个 buffer tile 又包含很多 micro-tile;写更多 C++ 循环不会自动启用更多核心。
5.2 单核内的 2×2 复用
AMD 的 matmul_vectorized_2x2_mmul 同时维护四个输出微块。每个 K 步骤加载两块 A、两块 B,然后交叉组合为四次矩阵乘加:
这样每块 A/B 都在寄存器中复用两次,并交错多个 accumulator 的依赖链。收益受寄存器容量限制:过度展开可能产生 spill;同一实现对展开 K 的寄存器压力有明确说明。最终调度效果应看编译器报告和反汇编,不能只按源码中「同时有四个对象」推断四个物理矩阵引擎。
这个上游 kernel 与前面的最小示例还有一处区别:它会从 C buffer 读取已有 partial sum,然后累加当前 buffer 的 K 分块,最后写回。Accumulator 在一次 kernel 内的寄存器生命周期与跨 kernel 调用在 SRAM 中保留的 partial sum是两层存储,不能认为整个模型的 K 归约一直不落 SRAM。
5.3 Layout 是计算合同的一部分
上游矩阵 kernel 的布局说明要求矩阵先按 micro-tile 打包:微块内部通常 row-major,微块之间也按规定顺序排列。这与一张大矩阵的普通连续 row-major buffer 不同。例如在 16×16 矩阵中,左上 8×8 子块的两行之间仍隔着其他列;它不是可直接连续 load 的 64 元素。
因此需要 host pack、DMA traversal 或专门的片上重排。AMD 的单核数据流示例把 kernel 的 stream layout 接到 FIFO 的转换描述上;输入/output tensor 的访问模式再决定从系统内存读取哪些区域。矩阵 kernel、FIFO 布局与 DMA 遍历必须一致,不能只核对 dtype 和矩阵尺寸。
5.4 C++ 管核心计算,数据流描述管阵列协作
一个完整的低层程序需要同时描述:
- 核心计算:C++ 中的 load、shuffle、MAC、accumulator 和输出转换。
- 空间映射与通信:哪些核心运行 kernel,哪些 SRAM buffer 保存输入/输出,DMA 和 stream 如何连接,以及 buffer 如何同步。
- Host 提交:准备设备 buffer,加载编译产物,启动任务并等待输出完成。
在本文使用的 MLIR-AIE/IRON 路线里,Worker 绑定核心程序,ObjectFifo 表达有界的 buffer 数据流,Runtime / Program 组织传输与设备程序。它们是与 C++ 配套的阵列描述;不是在 AIE 上运行 Python 解释器。
看 AMD 的单核消费循环,生命周期是:取得输出 buffer、清零,循环取得 A/B buffer、调用矩阵 kernel、释放输入,最后发布输出。acquire / release 在这里表达 buffer 可用性与所有权交接;其 lowering 负责生成相应的设备同步/通信操作。FIFO depth=2 能为 ping-pong 留出空间,但能否重叠搬运与计算仍取决于 DMA 调度、依赖和带宽。
编译时,单核 AIE 编译器生成核心程序,阵列编译流程生成 placement、buffer、DMA/stream 和控制配置;host 通过 runtime 加载并提交。AMD 的构建与 host 说明展示了 XCLBIN + 控制指令序列,以及把控制指令包装成 ELF 的路径。这里的 host 控制指令序列与compute tile 的 C++ 核心指令是不同层级。
5.5 多核 GEMM:显式分发,显式汇集
AMD 的全阵列矩阵乘示例创建 4 行 × 指定列数的 worker。其输入与输出数据流按 A 的行、B 的列、C 的行列组织:多个核心复用 A/B,分别生成输出块,再经 memory tile 汇集。这是空间分块,不是宿主机启动一段 C++ 后由硬件自动把 GEMM 切给 32 个核心。
若沿 K 分配给多个核心,还要设计 partial sum 的合并,可按目标支持的 cascade 或显式传输与归约实现。32 个物理核心只是容量上限;实际使用数取决于分区、placement 与运行时资源分配。
6. 对 kernel 优化与 fusion 的含义
首先检查 MAC 是否持续得到操作数:工作集能否放进 SRAM、输入是否已按微块排列、每次 load 后有多少复用,以及 accumulator 依赖链是否限制调度。其次检查 DMA、FIFO depth 和多核分发是否让核心等待,最后再看更多列是否真的带来吞吐增长。
例如一个 INT8 buffer GEMM 使用 ,输出 INT32:A、B 各 1 KiB,C 为 4 KiB。若三个 FIFO 各有两个独立 buffer,仅 tensor 存储就要 KiB,此外还有栈、对齐和其他局部数据。这个容量计算能筛掉明显不合理的分块,但不能证明无 bank conflict 或高吞吐。
GEMM 的 bias、activation、requantization 可以考虑放进同一 tile 的后处理,保留片上结果并减少往返系统内存;不过这些操作也会消耗 vector 执行资源、寄存器和 program SRAM。不能从「MAC 与 vector 都有名字」推出二者像两个独立引擎一样自由并行。 是否能够重叠,要由该 dtype 的真实指令路径、VLIW 调度和设备 trace 判断。
本页确认了 AIE2P 的计算路径与编程组织,没有给出 HX370 上的实测吞吐。后续验证应分别观察单核 INT8、默认 BF16 与 BFP16 转换路径,再记录多核 placement、核心执行时间和端到端 DMA 时间;这样才能把计算瓶颈、布局成本和通信等待分开。
参考文献
[1] ADVANCED MICRO DEVICES. MLIR-AIE: NPU2 target model, AIE kernels and programming examples[EB/OL]. 2026[2026-10-12]. https://github.com/Xilinx/mlir-aie/blob/766aca40deaf57b2a12b14e1e15985b878e7faae/include/aie/Dialect/AIE/IR/AIETargetModel.h#L1219-L1269.
[2] ADVANCED MICRO DEVICES. Versal Adaptive SoC AIE-ML Architecture Manual: AM020, v1.5[EB/OL]. 2026[2026-10-12]. https://docs.amd.com/r/en-US/am020-versal-aie-ml. 本地官方 PDF,第 55、63–66 页。
[3] ADVANCED MICRO DEVICES. Versal Adaptive SoC AIE-ML v2 Architecture Manual: AM027, v1.1[EB/OL]. 2025[2026-10-12]. https://docs.amd.com/r/en-US/am027-versal-aie-ml-v2. 本地官方 PDF,第 39–40 页。
[4] ADVANCED MICRO DEVICES. AIE API: AIE2P matrix multiplication implementations[EB/OL]. 2026[2026-10-12]. https://github.com/Xilinx/aie_api/blob/b0422227afd25e9b47930624c857f384b500b524/include/aie_api/detail/aie2p/mmul_8_8.hpp#L126-L145.
源码核对固定为 Xilinx/mlir-aie@766aca40deaf57b2a12b14e1e15985b878e7faae 与 Xilinx/aie_api@b0422227afd25e9b47930624c857f384b500b524。这是本文分析版本;不表示归档设备已经安装这些 commit 的工具链。