Hexagon-MLIR:高通 NPU 编译栈、tile 流水与融合边界
Hexagon-MLIR 的目标是把 Triton kernel 和 PyTorch 计算图自动编译成 Qualcomm Hexagon NPU 上可执行的代码,并通过融合、片上存储分块、HVX 向量化、多线程和 DMA 双缓冲减少执行成本。 论文的重点是将这些机制组织成一条可分析、可扩展的分层编译流程[1]。
先解释这条流程涉及的几个名词。IR(Intermediate Representation,中间表示)是编译器内部描述程序的形式:编译器先把输入程序变成 IR,在其上分析和改写,再逐步生成机器代码。不同层级的 IR 可以分别保留张量运算、循环、内存访问或机器指令等信息。
MLIR(Multi-Level Intermediate Representation,多层次中间表示)是一套构建编译器的基础设施,支持在这些不同层级之间表达和转换程序。它通过 dialect(方言)组织不同领域的操作、类型与规则;一种 dialect 可以理解为编译器内部的一套专门表达方式。Hexagon-MLIR 则是在这套基础设施上构建的、面向 Hexagon NPU 的具体编译栈。
Linalg(名字来自 Linear Algebra)是 MLIR 生态已有的一种 dialect,用来表示结构化张量计算,并非这篇论文新提出的概念。 它不只表示矩阵乘,也能表示逐元素计算、归约等操作。关键是同时保留“每个位置算什么”和“如何遍历、索引张量”:例如矩阵乘中,哪些维度对应不同输出、哪个维度负责累加。编译器利用这些信息判断计算能否融合、并行或分块[1](§3–4.2)。
因此,后文的“转成 Linalg”是指把前端计算转换成编译器便于分析和优化的张量计算表示;随后再生成更具体的循环、缓冲区、搬运和设备代码。这里的 tile 是张量或迭代空间中的一个计算块,kernel 是交给设备执行的计算程序;一个 kernel 可以处理多个 tile,也可以融合多个操作。
从 kernel fusion 的角度,它提供了两个关键基础:跨操作保留数据局部性,以及自动形成 tile 搬运与计算的流水线。但这两点并不等于已经实现任意 HMX/HVX 任务的联合调度,也不等于暴露了与 TileLang 相同的用户编程接口。
本文以 arXiv:2602.19762v1(2026-02-23,17 页) 为论文版本,正文页码均指 PDF 页码。原始 PDF 已归档。实现补充采用 2026-10-19 核对的固定源码快照[2];后者晚于论文,不能反推为论文当时已经实现或测量的能力。本次为资料与源码核查,未在设备上运行或复现性能。
1. 它解决什么问题?
1.1 单个算子很快,模型仍可能被算子边界拖慢
手工优化的算子库能很好地实现标准矩阵乘、卷积等计算,但新模型持续出现新的激活函数、归约和融合模式。若每一种组合都需要新写设备代码,支持成本会随组合数增长。另一个问题是库调用可能隐藏内部实现,使编译器难以把前后计算合起来优化;中间结果也可能在调用边界被写回 DDR,再由下一个算子读入[1](§1)。
例如,逐元素计算链先生成一个完整中间张量,再让后续操作读取它,会增加中间存储与访存。将链条编译为融合代码,就有机会直接消费刚产生的值。对更大的中间块,也可以尽量将它保留在片上存储,避免不必要的 DDR 往返。
论文希望通过自动生成专用代码覆盖持续变化的计算组合。 它也允许接入优化库;编译生成和库调用可以共存。论文没有证明生成代码在每个单算子上都优于手工汇编,也没有给出相对于高通商业工具链的全面性能比较。
1.2 面向的是哪些硬件资源?
理解后续优化,需要先区分存储、搬运和计算资源[1](§1、§4)。
表 1|Hexagon-MLIR 所利用的主要资源
| 资源 | 职责 | 对编译器意味着什么 |
|---|---|---|
| DDR | 容量较大的片外存储 | 数据量大时,需要控制往返次数与搬运开销 |
| TCM / VTCM | 容量受限、访问延迟较低的片上存储 | 工作集必须分块,并管理缓冲区生命周期 |
| DMA | 在不同存储空间之间搬运数据 | 可以与计算重叠,但必须处理完成等待和缓冲复用 |
| HVX | 向量计算资源 | 适合逐元素、归约及相关数学计算,需要向量化与线程分工 |
| HMX | 矩阵计算资源 | 需要符合硬件要求的数据布局,以及适当的矩阵分块与调用方式 |
论文主要使用 TCM 一词;现行实现中的相关接口常称 VTCM。本文讨论该编译栈的片上工作存储时沿用资料中的用词,不将这些术语推广为所有芯片上完全相同的物理配置。具体硬件背景见站内 Hexagon 编程架构笔记hexagon-background。
2. 整条编译流程在做什么?
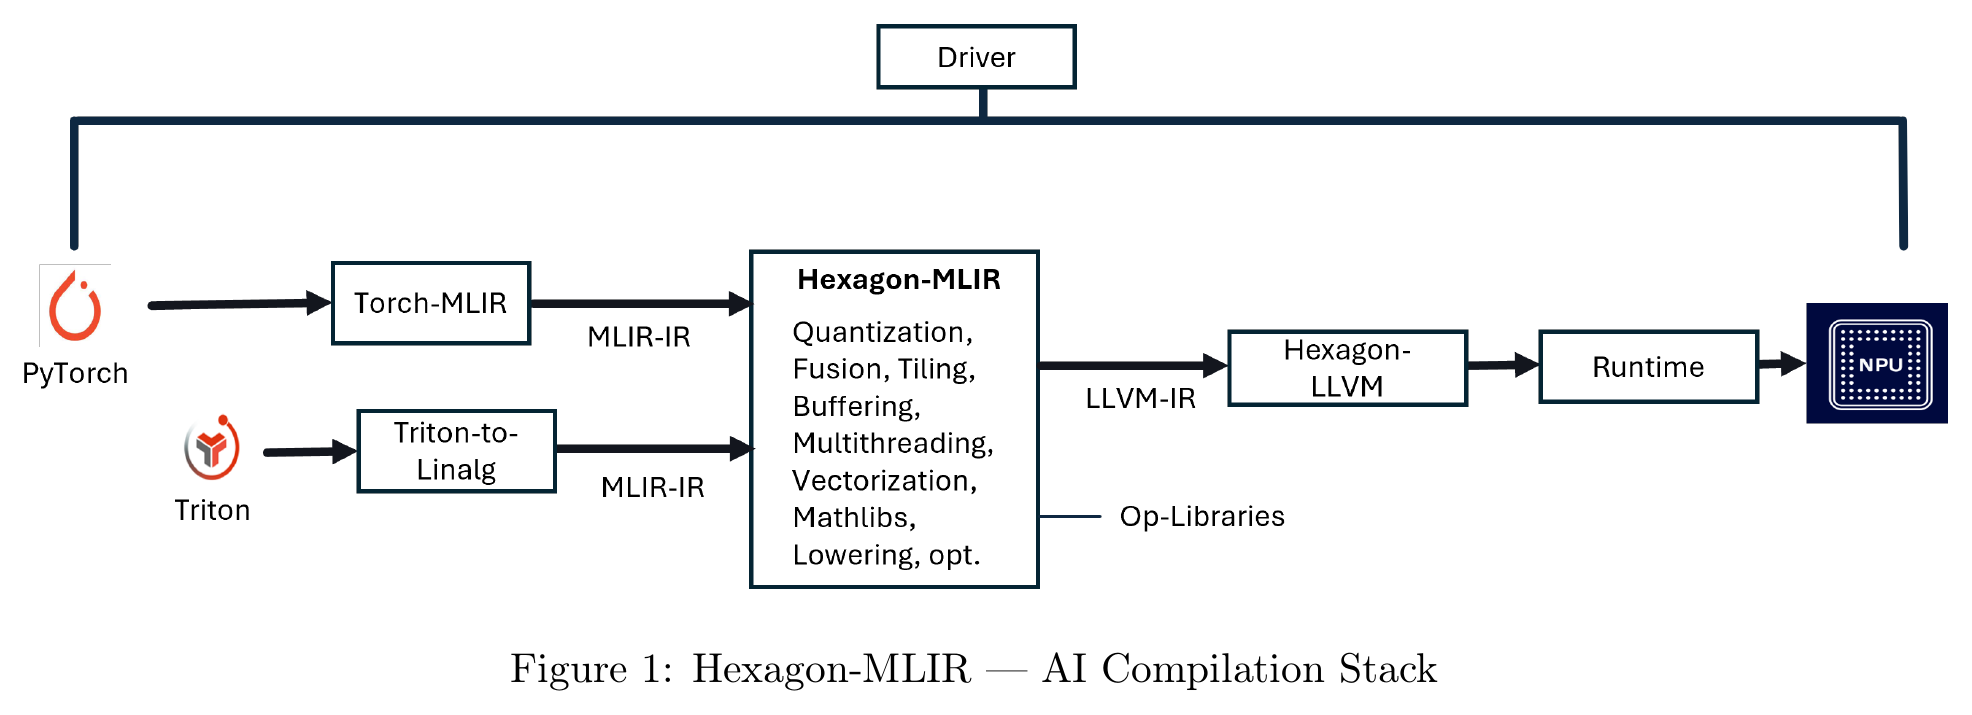
图 1|两类输入汇合到共同的硬件优化流程(取自论文 Figure 1[1])。PyTorch 经 Torch-MLIR,Triton 经 Triton-to-Linalg 转换后,进入 Hexagon 特定优化,再经 LLVM 后端与 runtime 在设备执行。图中的库接口表示编译器也可利用已有优化实现。
两条入口的共同点是先将输入转成以 Linalg 为主、结合其他 MLIR dialect 的计算表示,再做硬件相关优化。这样可以共享后续优化,而不必为 PyTorch 和 Triton 各实现一整套硬件编译流程[1](§3)。
其核心流程可以按职责理解:
- 接收计算语义:导入 Triton kernel 或 PyTorch 图中的操作、形状、索引和控制流。
- 做融合与布局优化:尽早消除不必要的中间结果,处理硬件所需布局及其传播。
- 映射到存储层级:把大工作集切成可放入 TCM 的 tile,显式表示搬入和搬出。
- 组织计算与并行:对 tile 内的计算向量化,将合法并行工作分给 HVX 执行上下文。
- 安排搬运与计算重叠:对符合条件的循环生成双缓冲和同步。
- 生成可执行代码:把结构化表示逐步转成 LLVM IR、设备代码与所需 runtime 调用。
这是一种阅读顺序。编译器把一次分析或变换称为 pass,按顺序组织起来就是 pass pipeline。真实流程会穿插规范化、公共子表达式消除和清理;其中 bufferization 是把 tensor 层的值与计算落实到内存缓冲区及其访问,lowering 是将较高层的表示逐步转换为更接近设备执行的表示。部分编译路径也会绕过某些优化。
现行源码可以确认 Triton 入口会调用转换工具生成 Linalg 路径的 IR,见转换入口。PyTorch 和 Triton 两条入口最终共享硬件优化,并不表示所有 PyTorch 模型都必须先转成 Triton。
3. Linalg-Generic 与 Operator Fusion:计算如何表示,又如何合并?
3.1 先区分 dialect、operation 和 kernel
Linalg 是一套表达张量计算的规则;operation(操作,简称 op)是 IR 中的一次具体计算;kernel 是最终交给设备执行的程序。 三者不是一一对应关系:一个矩阵乘可以是一个高层 op,降低到更具体的表示后会展开成循环和许多计算;一个 kernel 也可以包含多个 op 的计算。
论文标题中的 Linalg-Generic 指 Linalg 的通用结构化操作,实际 IR 名称为 linalg.generic。这里 generic 的含义是:操作的计算体可以自定义,用同一套外层结构描述不同的张量计算。它仍是 MLIR 的一种操作表示;出现一个这样的 op,并不表示已经生成一个独立设备 kernel[1](§4.2)。
例如,逐元素加法与“先减法、再指数”的融合计算,数学内容不同,却都可以描述为“遍历张量的每个位置,读取相应输入,执行计算,产出结果”。通用结构化操作就是把这套共同结构显式保留下来。
3.2 一个通用结构化操作里,到底有哪些信息?
可以按五部分阅读论文 §4.2 的表示:迭代空间、索引映射、迭代类型、输入与输出,以及计算体[1]。下面以长度为 的两个向量相加为例。为了先看懂语义,使用说明性伪代码;实际字段与 IR 可对照官方向量加法示例。
目标:C[i] = A[i] + B[i]

迭代空间:i 从 0 到 N-1
索引映射:A 取 A[i],B 取 B[i],C 对应 C[i]
迭代类型:i 为 parallel
输入:A、B
输出目标:C
每个迭代点的计算体:接收 a、b,计算 a+b,产出这个位置的结果
第一,迭代空间说明有哪些计算位置。 向量加法是一维位置 ;矩阵乘则需要输出行 、输出列 和累加维度 。这时 IR 还不必承诺最终使用哪一种机器循环、线程划分或向量宽度。
第二,索引映射说明每个迭代点访问张量的哪个位置。 同样遍历 ,一个输入可以读取 ,另一个可以只读取 ,从而表达按列广播;读取 则可以表达转置访问。映射让编译器看见这些访问关系,而不必只从底层地址运算中重新推导。
第三,迭代类型说明维度的计算性质。 parallel 表示该维度在操作语义上具有可并行的结构,并不是已经创建了硬件线程;reduction 表示多个迭代点共同更新同一输出,例如求和。能否用某种顺序并行归约,还取决于操作与数值规则。矩阵乘中, 对应不同输出, 共同累加到同一个输出位置。
第四,输入与输出目标说明操作读取和生成哪些张量。 官方 IR 用 ins 与 outs区分它们。在 tensor 语义下,输出目标还提供结果的形状与目标关联,并非一次立即执行的内存写入。对于逐元素覆盖计算,计算体可以不使用输出的原值;对于累加归约,初始值则参与语义,不能省略或当作任意未初始化数据。
第五,计算体说明单个迭代点上具体做什么。 外层索引选出输入元素后,计算体处理这些标量值,并通过 linalg.yield交出该点的结果。这里写成标量操作,是为了表达计算语义;后续向量化可以把多个点组织成 HVX 向量操作,不代表最终必须逐个元素执行。
因此,“结构化”具体指的是:遍历关系和计算内容被放在一起描述,但仍能分别分析与变换。 编译器可以改变分块、遍历次序和执行方式,同时保留原来的数学计算。
3.3 为什么要在这一层进行优化?
如果过早把矩阵乘完全变成普通循环、地址计算和内存读写,编译器往往需要重新识别:哪些下标对应同一输出、哪个循环负责归约、哪些写入彼此独立。结构化表示保留这些信息,使后续融合、分块和向量化有更明确的分析依据。
论文还强调在 tensor 层进行融合的好处:中间张量表现为一个计算产生、另一个计算消费的值,数据依赖直接可见。等到 bufferization 时,再落实实际缓冲区、共享存储和复制;若已经变成内存读写,优化就还需要判断不同访问是否指向同一片存储,以及能否安全重排[1](§4.2–4.4)。
但一个通用结构化操作不是所有程序的万能容器。数据相关控制流、非仿射索引,以及完整的 softmax、prefix-sum、TopK 等计算,可能需要多个操作和额外控制流。统一表示的价值是保留可分析的结构,不是把任意计算都压成一个 op。
3.4 Operator Fusion 是什么?合并的是哪一层?
Operator Fusion(算子融合)是一种程序变换:在保持所要求计算语义的前提下,把多个操作的计算组织到一起,减少它们之间不必要的数据存储与读取。 论文 §4.3 重点展示的是生产者/消费者融合:前一个操作产生中间结果,后一个操作使用它[1]。
设操作 产生 ,操作 计算 。若索引关系与依赖允许,就可以在消费位置计算所需的 ,再立即执行 。对于简单逐元素情况,合并后的计算体就是 。
这里至少要区分三件事:
- IR 操作融合:把两个结构化操作改写为一个计算体,或把生产者计算移入消费者的 tile 范围。论文的减法与指数例子展示了前一种。
- 设备 kernel 融合:把原本可能分开启动的计算放进同一个设备程序。是否减少启动,需要看融合前后实际的 kernel 边界;两个 IR op 原本也可能已经属于同一个 kernel。
- 多引擎重叠:让 HMX、HVX、DMA 在依赖允许时同时推进不同工作。融合扩大了可优化范围,但还需要任务切分、资源映射、缓冲和同步,才可能形成重叠。
因此,看到融合后的一个通用结构化操作,可以说明计算被合并到同一表示中;还不能仅据此断言启动次数减少,或矩阵与向量引擎已经并行执行。
3.5 Softmax 示例:沿着数据依赖看融合前后
对一行输入 ,令 为该行最大值,稳定的 softmax 为:
论文 Listing 2–3 演示的是其中 减法 → 指数 这段局部链条。以下假设行最大值已经计算完成,采用说明性伪代码展示遍历变化[1](§4.3):
融合前:
    对每个 i:
        tmp[i] = x[i] - m
    对每个 i:
        numerator[i] = exp(tmp[i])

融合后:
    对每个 i:
        t = x[i] - m
        numerator[i] = exp(t)
融合前,第一个操作生成完整的中间向量,第二个操作再读取它。融合后,每个位置的减法结果直接传给同一计算体内的指数操作;只要没有其他用途,就不再需要保留完整的中间向量。中间物化指的正是把这种中间结果落实成可供后续读取的存储对象。
为理解潜在访存收益,假设两个向量遍历原本确实分别读写内存、只有这一条消费链,长度为 ,每个元素占 字节,并忽略已算出的行最大值和其他开销。融合前的张量数据流量约为 :读输入、写中间量、读中间量、写输出;融合后约为 :读输入、写输出。省下的是中间量的一写一读。
这个估算不是论文测得的 DDR 流量。 中间量原本可能在片上存储或缓存中,实际生成代码也可能已经做了其他优化;融合后的临时值通常有机会留在寄存器中,但是否溢出到内存仍由后端决定。消除 IR 中的完整中间张量,不等于无条件省下同等数量的 DDR 传输。
完整 softmax 仍然有行最大值与分母求和的归约依赖。要计算最终归一化结果,需要得到相应的行统计量;将减法与指数融合,并没有让整个 softmax 变成完全独立的逐元素计算,也不能允许各块在缺少全行统计量时直接产出最终结果。
3.6 什么时候能融合?什么时候不一定划算?
首先要判断计算是否合法。消费者需要的每个值,都必须能从融合后的输入、索引和执行顺序中得到;不能遗漏某个用途、在数据准备好前读取,或错误地改变归约与副作用顺序。广播和转置的索引不同,不能简单照搬“相同位置拼接计算体”的例子。
其次要检查中间结果还有谁在用。如果同一个减法结果还被另一个分支读取,将其融合进指数操作后,也不能直接删除原结果。编译器可以保留必要输出、扩大融合范围,或者在允许时重新计算;这些选择的存储和计算成本不同。
第三要判断资源代价是否抵消收益。融合后可能增加同时存活的值、寄存器压力和片上工作集,也可能使高效的库实现难以使用。减少一次中间存储与增加一次昂贵计算之间,需要按实际形状与实现取舍。因此,合法融合并不保证更快,融合范围也不是越大越好。
现行 FusionPass.cpp 的逐元素融合控制同时检查可融合性,以及生产者是否只被使用一次或是否允许重计算。它的另一条多用途融合路径还检查全并行迭代、循环维数、同一代码块和消费者的执行关系。这些是具体路径的条件,不能推广为所有 Linalg 融合必须具备完全相同的限制。
从研究分类看,论文这个例子是沿生产者/消费者依赖的纵向融合。将彼此独立的矩阵任务和向量任务放到同一设备程序、利用不同资源并行推进,则属于另一类横向融合与调度问题。前者主要展示数据复用,后者还必须证明独立性与资源互补;二者的收益来源需要分别验证。
4. Tile 如何落到片上存储、线程与向量?
4.1 算法 tile 和片上存储 tile 是两个层次
Triton 程序可以先决定一个逻辑计算块处理哪些元素。后端还可能继续把这个块切成适合片上存储的较小块,因此源程序中的块尺寸不必等于最终 VTCM tile 尺寸。
官方 Flash Attention 示例显式按 K/V 块循环,在每个块上计算并更新归约状态,见分块计算体。这确认了算法层面的 tile 编程能力。该教程开头同时说明它没有展开 HMX、DMA 和布局转换的特殊处理,见示例范围;不能仅凭这个示例就推断完整的 HMX attention 流水实现。
4.2 存储分块:先让工作集放得下
论文 §4.4 生成外层 tile 循环,循环体中仍保留结构化计算;输入切片被复制到 TCM,计算完成后再把需要的结果写回。循环顺序也可以调整,使适合向量化的维度位于内层[1]。
对一个 tile,基本约束是:同时存活的输入、输出、中间量、布局转换空间和其他 scratch 的总占用不能超过可用预算。采用双缓冲后,还必须计入额外的缓冲副本;仅计算单块输入大小不足以确定合法尺寸。
现行实现既支持覆盖 tile 尺寸,也会根据工作集估计和 VTCM 预算选择尺寸,见预算下的尺寸缩减逻辑与用户覆盖分支。这是存储约束下的启发式策略,不能自动视为对所有 tile、线程和流水方案进行了全局性能搜索。
4.3 多线程:将合法并行工作分给多个 HVX context
论文 §4.5 将并行化分成两步:先根据迭代空间形成虚拟线程,再转换成异步执行区域及其完成等待。可整除时使用块划分,也讨论了为负载均衡采用块循环划分[1]。
这里的“异步”首先表示 fork–join 并行和依赖等待。 它并不自动意味着存在动态 ready-task 队列,或运行时能够为任意 HMX、HVX 工作寻找最优配对。
4.4 向量化与数学函数:把每个线程里的工作做快
向量化把一批标量操作映射为 HVX 向量计算。指数、双曲正切等函数还需要高效实现;论文 §4.7 讨论了利用 Qualcomm 数学库或多项式近似,以受控数值误差换取吞吐[1]。
因此性能与数值策略需要一起理解。不同 dtype 的速度差异,可能来自向量宽度、类型转换和函数实现;启用近似、fast-math 或精度转换后,也应按对应误差要求检查结果,而不是只比较运行时间。
5. 双缓冲:它确实会自动生成 tile 级流水
5.1 从“搬完再算”变成“预取下一块,同时计算当前块”
单缓冲循环中,每个 tile 依次经历搬入、计算和写回;下一块常需等待当前缓冲不再使用。双缓冲为工作数据准备 ping/pong 两套空间,让下一块搬入另一套缓冲,同时计算当前块[1](§4.6)。
图 2|双缓冲的控制流程。依据论文 §4.6 与 Listing 6[1]整理。预取被提前发起,其传输可与后续计算重叠;这张图表达控制顺序,不表示传输与计算耗时相等,也不承诺输出写回一定隐藏在计算之后。
论文把转换拆成两层:第一层识别符合要求的单缓冲 tile 循环,构造序言、两套缓冲和交替执行的主体;第二层将复制替换为异步搬运,并插入完成等待。一个解决循环与缓冲的组织,另一个落实实际搬运和同步。
现行源码仍有对应的两阶段实现:DoubleBufferGenericS1.cpp 的职责和覆盖范围,以及DoubleBufferGenericS2.cpp 的 DMA 转换。后者的写回实现发起搬运后紧接等待,所以不能把这个机制直接描述成输入、计算、输出任意三级完全重叠。
5.2 自动变换有匹配条件,也有开启条件
当前第一阶段的循环检查要求可确定的边界和步长、零起点及整除关系。文件开头还把更广的 DMA 维度、归约循环、多缓冲和更广模式覆盖列为后续扩展方向。
现行 Python 配置的 enableDoubleBuffering 默认关闭;C++ pipeline 中也只有开启该选项才加入第一阶段和第二阶段。所以“支持双缓冲”与“每个 kernel 都默认生成双缓冲”是两回事。
5.3 为什么最理想也未必有很大收益?
令 为每块可重叠的搬运时间、 为计算时间,暂时忽略序言、尾部、写回和同步。串行时间为 ,完全重叠后的稳态时间为 ,理想加速为:
两者接近时,潜在收益最大;若某一项远大于另一项,只能隐藏较短的部分。论文 Figure 4 画的是这个理想关系,不是某个 kernel 实测达到的性能曲线[1](§5.4)。实际还存在有限 tile 数、缓冲占用、排队和同步成本。
6. 到底支持哪一种 tile 级编程与调度?
表 2|将“支持 tile”拆成可核实的能力
| 能力层次 | 核查结论 | 证据与限制 |
|---|---|---|
| 在程序里表达算法分块与块间迭代 | 支持 | Triton Flash Attention 示例显式逐块更新计算状态,见 §4.1 |
| 将工作集切到 VTCM 中计算 | 支持 | 有预算估计和尺寸覆盖,见 §4.2 |
| 自动生成 DMA/HVX 双缓冲流水 | 支持,需满足条件 | 论文 §4.6 和两阶段源码均提供证据,见 §5 |
| 将矩阵乘拆成 HMX tile 微操作 | 当前快照存在该路径 | 见 §7;属于晚于论文的实现证据 |
| 用户在 DSL 中显式指定多级缓冲与流水阶段 | 现有接口证据不足以确认与 TileLang 等价 | 调优开关与完整的存储/流水编程原语不同 |
| 任意 HMX/HVX 任务图的联合排程或动态均衡 | 本文核查未得到充分证据 | 固定分块循环和局部双缓冲不能单独证明这种能力 |
对实际调优,现行 HexagonOptions 配置暴露了融合、VTCM tiling、双缓冲、多线程、向量化和 HexKL 等选项;其中 tileSizes 明确注释为调试用的用户尺寸配置。“有尺寸覆盖入口”应理解为可干预编译策略,不宜描述成稳定、完整的 schedule DSL。
还有一个容易误判的细节:同文件的 num_stages、num_warps 等兼容字段被注释为当前未使用。因此,不能把 GPU Triton 上相同参数名的语义直接套到这个 Hexagon 后端。
语言覆盖也有限制。当前开发指南的限制说明列出了动态形状操作、部分形状操作、高级访存、原子操作、复杂嵌套控制流及部分循环结构等不支持项。移植一个现有 Triton kernel 时,需要先确认具体特性可用,再讨论性能调优;“能接收 Triton”不等于完整兼容全部 Triton 语言和优化方式。
7. HMX 路径:已有 tile 分解,但还要看调度范围
论文 §4.8 说矩阵乘和卷积会较早识别,并通常交给矩阵引擎;为此需要布局转换,并通过布局传播减少不必要的转换[1]。但论文没有像 HVX GELU 一样详细展开 HMX 路径,也没有报告通用 HMX/HVX 联合流水的机制消融。
晚于论文的当前源码补充了更具体的信息:在 enableHexKL 分支中,矩阵乘可以走 macro API,也可以分解成 micro ops。因此,将当前 HMX 路径全部归为不透明的整算子库调用并不准确。
具体的 DecomposeHexKLMatmulPass.cpp建立 VTCM 工作区并设置累加器;随后形成按行、列和归约维度遍历的 tile 循环:
这证明编译器可以看见并生成矩阵 tile 级操作序列。 但上述片段本身是嵌套循环与操作顺序,尚不足以证明它会自动将不同 tile 的 HMX 计算、HVX 布局处理和 DMA 组织成通用并行流水,更不足以证明任意子图的联合调度。
设备覆盖也要按路径区分。当前用户指南列出的测试架构包括 v73、v75、v79、v81,同时注明 HexKL 选项目前不适用于 v81;支持某个架构不意味着全部执行路径都能在该架构使用。
8. 与 TileLang 的区别是什么?
DSL(Domain-Specific Language,领域专用语言)是为某一类任务设计的编程语言或专用语法。这里的 tile DSL 专门表达分块计算:一个块处理哪些元素、数据放在哪里、何时搬运,以及块之间如何组织流水。它可以采用 Python 风格的写法,但这些设备计算描述会被编译成目标代码,而不是让 NPU 执行 Python 解释器。TileLang 是具体的 tile DSL 与编译器项目;“使用 tile DSL”是一种编程方式,不等于已经具备 TileLang 对某个硬件的后端支持。
Hexagon-MLIR 和 TileLang[3] 都包含编译能力,主要区别在于输入抽象、用户直接表达的执行组织,以及目标后端。
表 3|Hexagon-MLIR 与 TileLang 的编程职责比较
| 维度 | Hexagon-MLIR | TileLang |
|---|---|---|
| 主要入口 | Triton kernel、PyTorch 图,汇合到 MLIR 优化 | 用 tile DSL 编写 kernel,再经编译器生成设备代码 |
| 分块表达 | 源程序可有算法分块,后端进一步做存储分块 | 用户可在 kernel 中直接组织 tile 计算与存储 |
| 片上 buffer | 主要由后端变换和配置引入、分配与规划 | 可显式声明 shared buffer、fragment 等,具体语义依后端 |
| 流水表达 | 由符合条件的编译器 pass 生成双缓冲 | 可在语言层写流水循环并指定阶段数 |
| 调度职责 | 编译器完成融合、分块、线程和搬运等目标优化 | 用户表达更多执行组织,编译器继续处理 lowering、布局与同步等 |
| Hexagon 可用性 | 有专门的编译、运行与测试路径 | 所核查的官方支持矩阵未列出 Hexagon |
TileLang 官方 GEMM 示例通过 T.alloc_shared、T.alloc_fragment、T.Pipelined、T.copy 和 T.gemm,直接描述“哪些块放在何处、每轮如何搬运与计算,以及采用几级流水”。这比单纯设置优化开关更接近显式组织设备执行,但也不意味着用户手工指定每条机器指令或所有同步细节。
两者都能表达在矩阵结果上继续执行逐元素操作等融合模式。差别不应概括成“TileLang 能融合、Hexagon-MLIR 不能”,也不能概括成“一个支持 tile、另一个不支持”。更有用的区分是:哪些执行意图由 kernel 作者直接写出,哪些由后端识别与生成,以及这些能力在哪个目标上成立。
截至核查快照,TileLang 的官方后端表包含 CUDA、ROCm、Ascend、Metal 等,未列出 Hexagon。因此,TileLang 的 GPU 或其他 NPU 流水代码不能直接视为高通 VTCM、DMA、HMX/HVX 的现成实现。若要迁移这种编程模型,还需要相应后端、存储语义、布局与同步映射。
AMD GPU 与 AMD NPU 也必须分开判断。 上述支持表的 AMD ROCm/HIP 项明确对应 CDNA/RDNA GPU,并未列出 Ryzen AI 的 XDNA/XDNA 2 NPU。2026-10-19 再核对官方支持表,仍未看到 XDNA NPU 或 Hexagon NPU 的支持项。因此,不能说这两类端侧 NPU 已经都有官方 TileLang 后端;也不能从“有其他 tile 编程工具”推出“已支持 TileLang”。AMD NPU 的 MLIR-AIE/IRON 编程路线见站内架构与编程笔记,Hexagon-MLIR 则是本文介绍的另一条目标编译路线。
更详细的 TileLang 与 PipeThreader 关系见站内笔记tilelang-background;当前 TileLang 的后端能力也不应全部归因于某一篇早期调度论文。
9. 实验实际证明了什么?
9.1 向量化收益很大,但要认清基线
表 4|论文报告的向量化加速结果(取自论文 Table 1[1])。保留原表的 dtype、shape 与说明;这是论文编译配置间的比较,不是相对于 QNN、手工汇编或 TileLang 的统一对比。
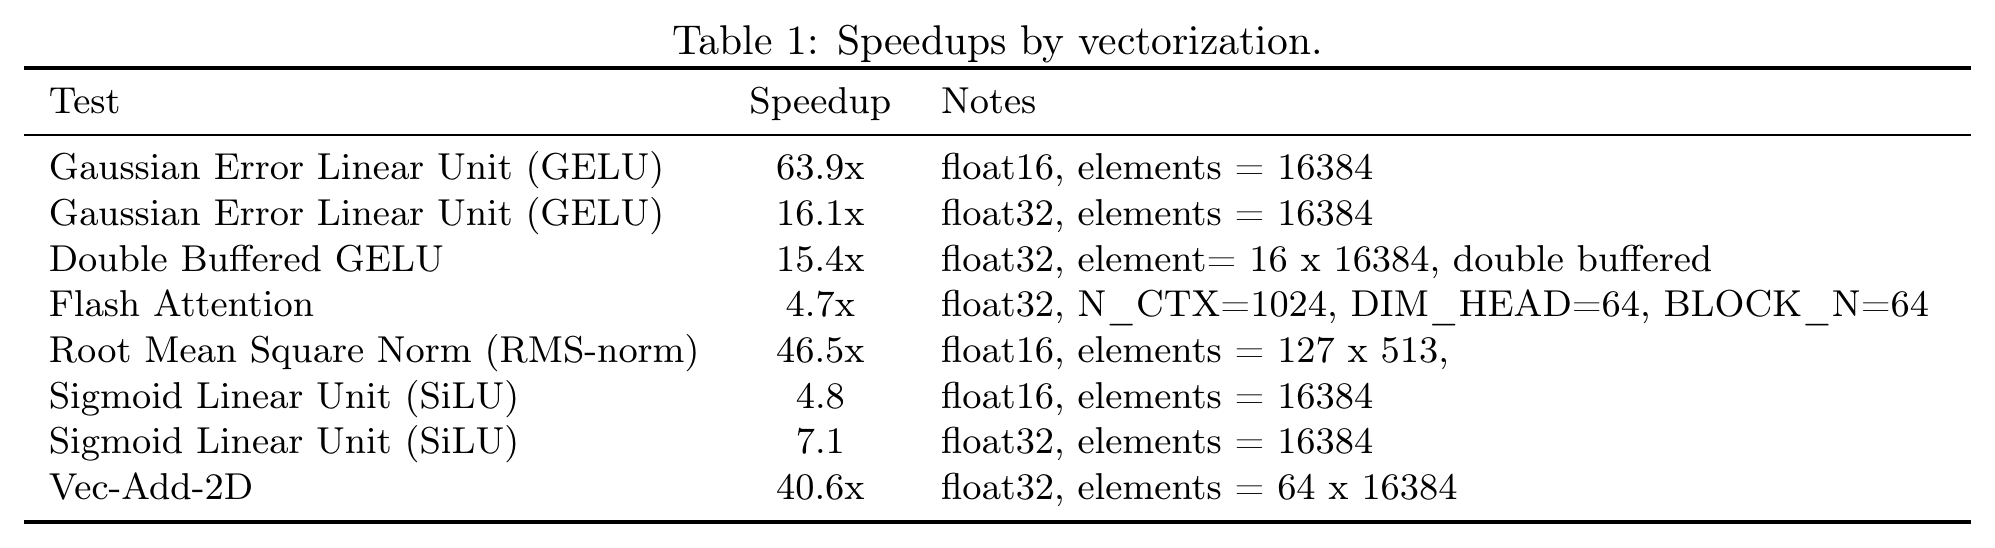
例如,论文报告 GELU 的 FP16 向量化加速为 63.9×、FP32 为 16.1×,RMS-norm 的一个 FP16 形状为 46.5×。这些数字支持“利用 HVX 向量资源很重要”,不能单独归因为 fusion,也不能作为优于商业工具链的证据[1](§5.1)。
论文对部分运行条件交代有限,Table 1 也没有逐项展开完整编译配置。读这些数字时应保留原来的 dtype 和形状,避免跨行计算收益,或从 kernel 加速直接推出模型吞吐提升。
9.2 多线程存在规模门槛
论文 Figure 2–3 与 §5.2 表明,小规模 GELU 的多线程版本可能更慢,因为线程启动、token 管理和屏障成本无法摊薄。随着工作量增长,多线程才表现出明显收益;收益也不是随尺寸单调增加[1]。
这说明线程数并非越多越好。线程划分应与 tile 大小、向量化后的实际计算量、VTCM 压力及同步开销一起考虑。
9.3 双缓冲有增益,但不能和向量化收益混算
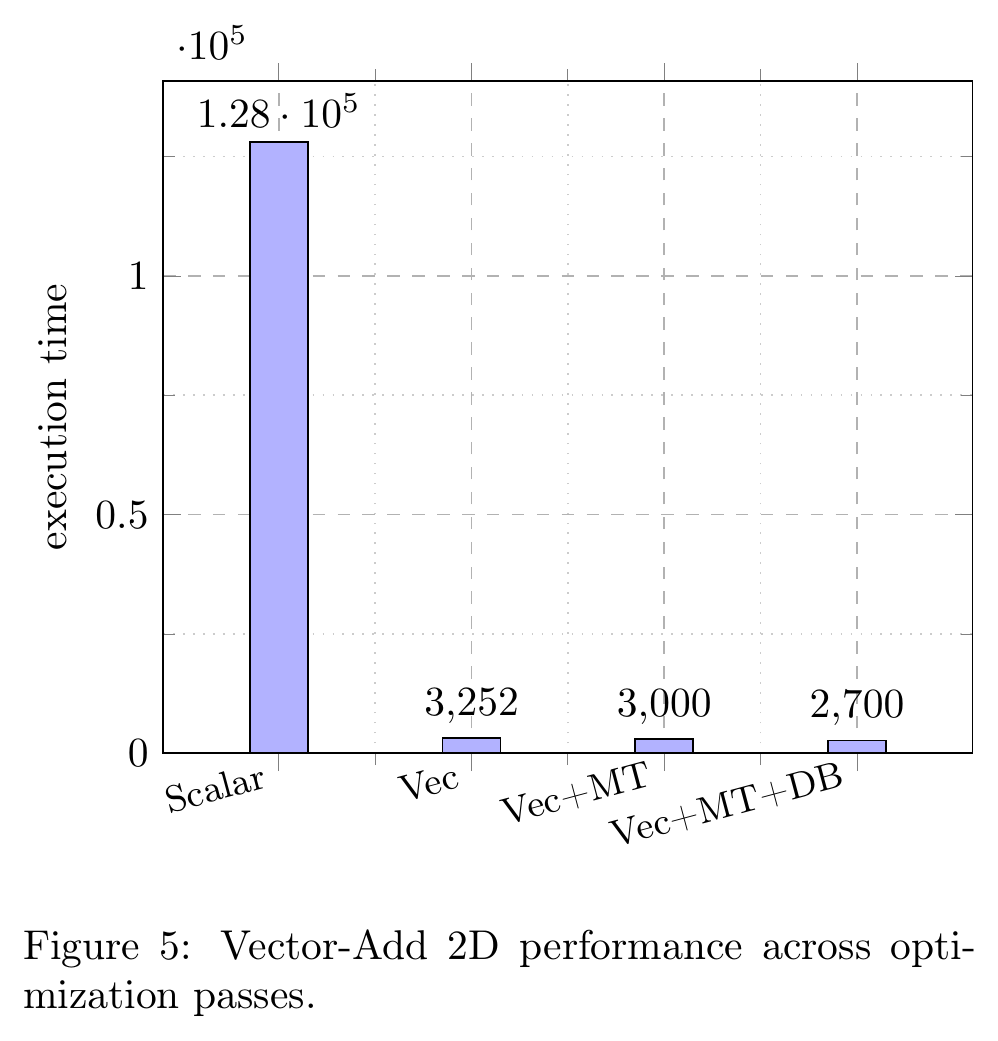
图 3|Vector-Add 的逐阶段性能(取自论文 Figure 5[1])。向量化是主要收益来源,随后多线程和双缓冲继续改善。纵轴按论文原图保留,不自行补写时间单位。
图 3 中,开启多线程后的数值为 3,000,再加双缓冲后为 2,700。按图示计算,后一步的加速约为 倍,即延迟下降约 10%。这个比较才对应在既有向量化与多线程之上的双缓冲增量。原图 scalar 到 vector 的比值也不应与 Table 1 的条目直接拼接为同一实验,论文未明确给出两者配置一一对应关系。
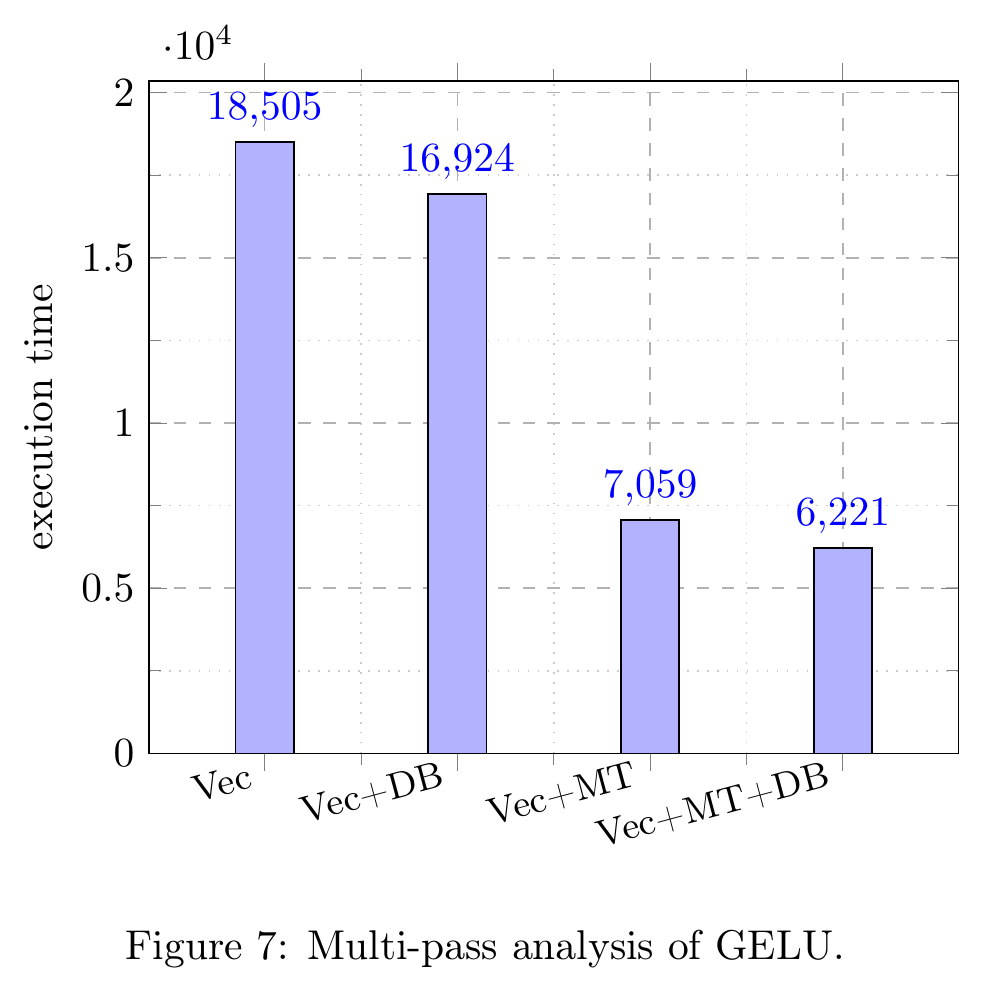
图 4|GELU 的多 pass 交互(取自论文 Figure 7[1])。图中依次比较向量化、向量化加双缓冲、向量化加多线程,以及三者组合。判断某项优化贡献时需要使用相应的相邻配置。
图 4 的数值给出以下区别:
- 仅在向量化上增加双缓冲:18,505 → 16,924,约 1.09× 加速。
- 在向量化上增加多线程:18,505 → 7,059,约 2.62× 加速。
- 在向量化与多线程上再增加双缓冲:7,059 → 6,221,约 1.13× 加速,延迟下降约 11.9%。
这些由原图数值计算的比值说明:优化收益取决于当前瓶颈,不能直接相加。 向量化和多线程缩短计算后,搬运占比会上升;但当搬运已经占绝大多数时间时,又缺少足够计算去隐藏它。论文 Figure 4 的理想模型正是在解释这个边界。
9.4 论文没有覆盖的验证问题
这篇论文提供了编译流程、IR 变换实例和代表性 kernel 的 pass 对照。其主要实验并未系统回答以下问题:
- 相对于成熟商业工具链或手工 HMX/HVX 融合实现,端到端模型有多少收益?
- 固定工作量和布局后,HMX/HVX/DMA 并行分别贡献多少?
- 更复杂任务依赖、有限缓冲和阶段失衡下,调度策略还能节省多少时间?
- 能否把论文的性能结果完整对应到确定的 SoC、频率、运行环境和源码版本?
因此它更适合作为编译机制与实现入口的依据,而不是通用调度效果或端到端领先性的完整证明。
10. 对高通 NPU kernel fusion 研究的启发
最可直接利用的是现成的 IR 与变换入口。 已有的融合、VTCM 分块、HVX 并行化、双缓冲及 HMX 微操作分解,为进一步研究缓冲生命周期、资源映射和流水安排提供了基础。
需要单独验证的是从局部流水到跨资源调度的增量。 对同一 tile,矩阵输出、布局处理和向量后处理可能存在依赖;不同 tile 之间有时可以重叠,但是否可行还取决于缓冲数量、数据布局和共享资源。拥有微操作或异步 IR,只是使这些问题可以被表示,尚未解决调度策略本身。
一个具体的验证顺序是:选取既有请求中的矩阵计算与向量后处理子图,固定算法和总工作量;先比较融合调用内部串行与现有双缓冲,再引入 HMX/HVX 重叠,最后比较不同 tile、缓冲预算和任务顺序。报告请求总延迟,并分别观察计算等待、搬运等待、缓冲复用与流水尾部。这样才能区分局部性收益、资源重叠收益和新调度策略的收益。
阅读这篇文章后,应保留三个判断:它是一条真实面向 Hexagon 的自动编译路线;它明确支持自动 tile 双缓冲;它提供了继续研究异构融合与调度的基础,但论文并未完成任意任务图的联合调度证明。
11. 资料版本与复核入口
源码链接全部按固定 commit 核对,集中列出如下:
- 论文:arXiv:2602.19762v1。正文、图表与性能描述以该 PDF 为准[1]。
- Hexagon-MLIR:
9ec15e80d9d53aa7fb97654da00bfd7047a77ead。可从编译配置、双缓冲 pipeline和HMX tile 分解继续阅读[2]。 - TileLang:
390ecf34918ce1e4d7d9967df254f507b10557d8,沿用站内相关笔记的快照。对比依据为官方 GEMM 示例与后端表[3]。
若要自行复核生成结果,现行开发指南给出了IR dump 方法和独立优化工具用法。应重点检查实际生成的 tile 循环、片上分配、DMA 启动/等待和 HMX 调用顺序,再结合设备 profiling 判断是否实现预期重叠。
hexagon-background. Hexagon 编程架构:Q6、HVX 与 HMX。 ↩
tilelang-background. PipeThreader 与 TileLang:kernel 表达、专用单元映射与流水搜索。 ↩
参考文献
[1] ABSAR M J, BASKARAN M, SHARMA A, et al. Hexagon-MLIR: an AI compilation stack for Qualcomm's neural processing units (NPUs)[J/OL]. arXiv preprint arXiv:2602.19762, 2026. https://arxiv.org/abs/2602.19762v1.
[2] QUALCOMM TECHNOLOGIES. Hexagon-MLIR: compiler source and documentation[EB/OL]. [2026-10-19]. https://github.com/qualcomm/hexagon-mlir/tree/9ec15e80d9d53aa7fb97654da00bfd7047a77ead.
[3] TILE-AI. TileLang[EB/OL]. [2026-10-19]. https://github.com/tile-ai/tilelang/tree/390ecf34918ce1e4d7d9967df254f507b10557d8.