PipeThreader 与 TileLang:kernel 表达、专用单元映射与流水搜索
PipeThreader[1] 的核心是把融合计算拆成带依赖的 tile 任务,显式描述每个任务使用的专用执行单元,再联合选择 tile 与流水顺序。TileLang[2] 则提供可编程的 tile DSL 和编译后端,将这些操作、布局、缓冲区和同步落实为设备代码。 两者有明确的项目关联:PipeThreader 论文摘要直接把 TileLang 仓库列为开源地址[1];但不能把当前 TileLang 每个后端都当成论文调度算法的原样实现。
本文分三层回答:论文如何设计 → NVIDIA 如何落地 → Ascend 两条实现路线如何落地。源码核对日期为 2026-10-14,所有链接固定到文末列出的 commit。论文页码使用出版页码,PDF 页码包含封面。
当前 TileLang 主仓库已经支持 Ascend 950;A2/A3 的适配属于外部 Ascend 项目。TileKernels 也已加入 Ascend 950 后端。PipeThreader 2025 论文评测的是 NVIDIA H100 与 AMD MI300X,没有报告 Ascend 实验[1]。下文对 Ascend 的说明来自现行源码,不是论文对 Ascend 的性能结论。
1. 三个仓库是什么关系?
表 1|论文、DSL、Ascend 适配与算子库的分工
| 对象 | 负责什么 | Ascend 状态与依据 |
|---|---|---|
| PipeThreader 论文[1] | sTask/sEU 抽象,tile 与流水的联合搜索,布局推导和设备代码生成 | 论文 §5–6 实现和评测覆盖 NVIDIA/AMD;未评测 Ascend |
| TileLang 主仓库 | tile DSL、通用编译基础设施及各设备后端 | 支持矩阵区分主仓库 Ascend 950 与外部 A2/A3 适配;2026-09-30 公告记录 950 后端加入 |
| tilelang-ascend[3] | 面向 Ascend 的 TileLang 变体,保留 tile 语法,增加 NPU 存储、Cube/Vector、流水和同步 lowering | 代码生成分支分别调用 Ascend C 与 PTO 后端;目标优化流程包含跨核与核内流水、内存规划、同步插入 |
| TileKernels[4] | 用 TileLang 编写并针对设备优化的算子库 | 项目说明与依赖明确基于 TileLang,2026-09-30 加入 Ascend,要求 Ascend 950、CANN 9.2.0、TileLang ≥0.1.15 |
所以“TileKernels 在 Ascend 上是否仍基于 TileLang”的答案是:是;当前这条路径使用主仓库的 Ascend dialect,不能笼统说成依赖外部 tilelang-ascend。 在量化算子的后端选择中,同一个 Python API 按设备选择 CUDA 或 Ascend 实现;Ascend 实现直接导入主仓库 Ascend language 并使用 JIT。这是统一上层 API + 分别优化的设备 kernel,不是把一份 CUDA kernel 原封不动重新编译。
同一个量化例子的参数选择还限定输入条件、按 dtype/shape 选 tile,并固定两级流水。这说明生产算子库可以结合手工经验配置,不代表每次调用都会执行 PipeThreader 的自动联合搜索。
2. 论文的动机:融合后为什么仍有 bubble?
Fusion 将算子放进同一个 kernel,省去部分中间结果回写和 kernel launch,却没有自动决定不同硬件单元应该什么时候处理哪个 tile。矩阵乘结束后再做归约时,Tensor Core 和通用计算资源可能交替工作;即使整个 GPU 看起来很忙,单元利用率仍然偏低[1]。
PipeThreader §2–3 将问题从“如何给更多线程分工作”推进到“如何给不同专用单元分阶段工作”:同一个 tile 必须遵守生产者/消费者依赖,但不同 tile 的矩阵、向量与搬运阶段可以交错。下面的原图同时展示任务划分、排程与 profiling 反馈。
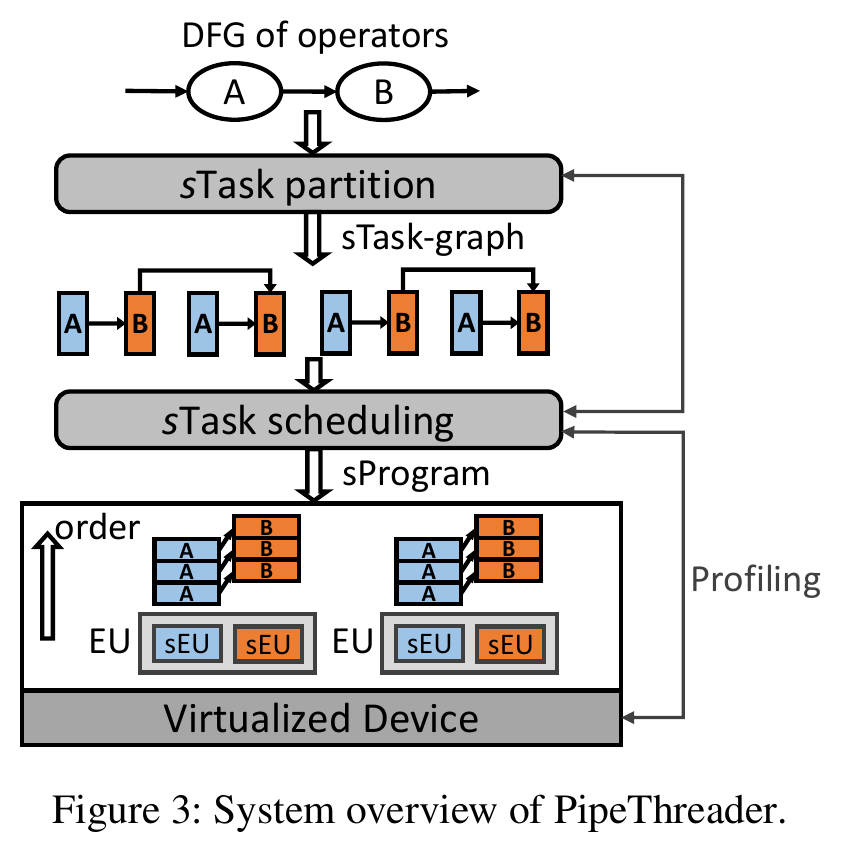
图 1|PipeThreader 的整体设计(取自论文 Figure 3[1])。算子数据流经过分块生成 sTask-graph,再将任务放到各 EU 内的不同 sEU 上,形成 sProgram。Profiling 同时反馈到任务划分和流水排程,表示二者需要联合优化。
这里优化的是 tile 操作到资源的映射与执行顺序。 论文 §3 明确区分这种 software-guided scheduling 与 GPU 硬件的线程/warp dispatch:编译器不替代硬件 warp scheduler,也不直接给每条线程指令指定某个物理 Tensor Core。
3. 论文如何表示一个 kernel?
3.1 计算表示:sTask-graph
论文 §3.1、Figure 4 把一个 sTask 表示为以下信息[1]:
- tensor expression:这个任务计算什么,例如 tile 矩阵乘、逐元素指数、归约或搬运。
- TileShape:各空间轴与归约轴的 tile 大小。
- target_sEU:这个操作能够在哪类专用单元执行。
- 依赖边:输入来自哪些其他 tile 任务,以及跨循环迭代需要保留哪些依赖。
一个高层算子可对应多个 sTask,例如矩阵乘包含输入搬运与矩阵计算。因此,sTask 不等于一个完整算子,也不等于一条硬件指令,更不等于一次 Host kernel launch。
前端可接收简化的 sTask IR,也可将模型图转换成任务图。论文 §5.1 使用 TVM TIR 表达 tile 计算,再标注执行单元类型。Loop 不必完整展开,Figure 6 的脚注说明它以有限迭代窗口建模。
3.2 硬件表示:Device → EU → sEU
论文用两层执行资源表达空间并行和异构流水[1]:
Device 包含多个等价的 EU,EU 之间分配输出 tile;每个 EU 内部包含不同的 sEU,用于不同类型的工作。在 H100 例子中,EU 对应 SM,sEU 包括 TMA、Tensor Core、CUDA Core。sEU 还记录是否支持异步执行。
这里的 sEU 是编译器可利用的资源类型与执行接口,不能将其机械理解为一个独占的物理核编号。资源类型确定后,后端还需要决定指令、线程绑定、数据布局与同步方式。
3.3 执行表示:sProgram
sTask-graph 只表示计算和依赖,sProgram 才表示执行方案。论文 §3.2 将每个 EU 内的方案写成二维数组:
sProg[sEU][order] = 当前资源上的下一项 sTask 或 barrier-sTask
完整方案还包含 EU 分配和 tile 选择。barrier-sTask 引用前驱的〈EU、sEU、order〉,消费者必须等待相应任务完成。这允许不同资源独立推进,同时保留数据依赖;缓冲区复用导致的等待也必须加入。
以“矩阵乘 → 求和”为例,一个合法方案可以让 Tensor Core 计算第 1 块矩阵结果时,CUDA Core 对第 0 块做求和。对第 0 块的依赖并未消失,只是等待范围缩小到了该块。
因此,从论文角度描述一个融合 kernel,需要“tile 计算图 + 执行资源 + 各资源上的顺序 + 同步 + 中间存储”,只有算子列表并不够。 论文不是把 sProgram 当成需要每次 Host 解读的任务清单;后端将它生成设备程序。
4. NVIDIA:操作如何落到专用计算单元?
4.1 论文的 H100 映射
论文 §3.3、§5.2–5.3 将 FlashAttention 拆为载入、两次矩阵乘、在线 Softmax、输出重缩放与累加[1]。
表 2|PipeThreader 在 H100 上的任务与硬件实现
| 工作 | 专用单元 | 后端落实的机制 |
|---|---|---|
| 大块输入搬运 | TMA | 异步 bulk copy;论文举例使用 PTX 的 bulk async copy 指令 |
| 两次矩阵乘 | Tensor Core | 异步 WGMMA;提交后不必立即阻塞所有后续工作 |
| Softmax、归约、逐元素变换、重缩放 | CUDA Core | 通用计算指令;在其他异步操作尚未完成时推进合法工作 |
| 跨阶段依赖 | 同步设施 | PTX mbarrier 等等待/完成协议 |
| producer/consumer 分工 | 不同 warp 角色 | producer 发起搬运,consumer 执行计算;在适用方案中形成 warp specialization |
论文 §5.2 还指出 Tensor Core 与 CUDA Core 对寄存器的使用可能互相干扰,因此用寄存器双缓冲减轻影响。允许异步执行只是重叠的前提;正确的缓冲区所有权、等待点与数据布局才让重叠可用。
4.2 Layout 决定 tile 内的数据和线程映射
“选 Tensor Core”之后还有一个关键问题:矩阵 tile 的元素应该由哪些线程持有、放在哪些寄存器或 shared memory 位置,才能符合矩阵指令的 operand layout?
论文 §5.2、Figure 11 用 Layout 表示逻辑索引 → 物理存储位置/线程位置的映射。先从矩阵指令的强约束得到布局,再沿任务图传播到相邻的通用计算任务。冲突由带优先级的布局推导解决;必要时产生数据复制或布局转换[1]。
因此,映射有两个层次:操作类型选择执行资源/指令,Layout 选择数据与线程组织。写矩阵乘公式本身不能跳过第二层。
4.3 当前 TileLang 的 kernel 表达与编译路径
当前 TileLang 可以使用 Python JIT 函数表达 tile 程序;显式构造形式则返回 TVM 的 primitive function。以基础 GEMM为例:
- 张量声明、kernel grid 与 buffer allocation指定 shape、dtype、输出分块、线程数以及 shared/fragment 存储。
- 归约循环内的 copy、gemm 与流水注解描述跨 tile 的搬运/计算,程序员在该例中明确选择 tile 和流水深度。
- 显式 primitive function 示例说明另一种前端写法;这些 Python 代码是在构造可编译 IR,运行 kernel 时不是逐元素执行 Python。
源码中的CUDA pass 流程先处理适用的 warp specialization,再进行流水规划、软件流水重写、布局推导和 tile 操作 lowering。其中自动 warp specialization 的注释明确标为 opt-in,不能将所有 kernel 都描述成自动分割了 producer/consumer warp。
资源映射最终落实为目标架构支持的指令与数据布局。 Hopper 的异步能力不能直接推广到所有 NVIDIA GPU;同样,也不能把普通同步 copy 的名字看成 TMA 已经生效的证据。应查看生成代码,并在设备上核对时间线。
5. 论文如何减少 bubble:预测、搜索还是实测?
三者结合,但不是无约束的全排列 sweep,也没有零 bubble 保证。 论文 §4.2、Figure 9 的具体策略是:外层枚举合法输出 tile,内层用 profiling 指导的贪心策略构造流水,最后实测完整方案[1]。
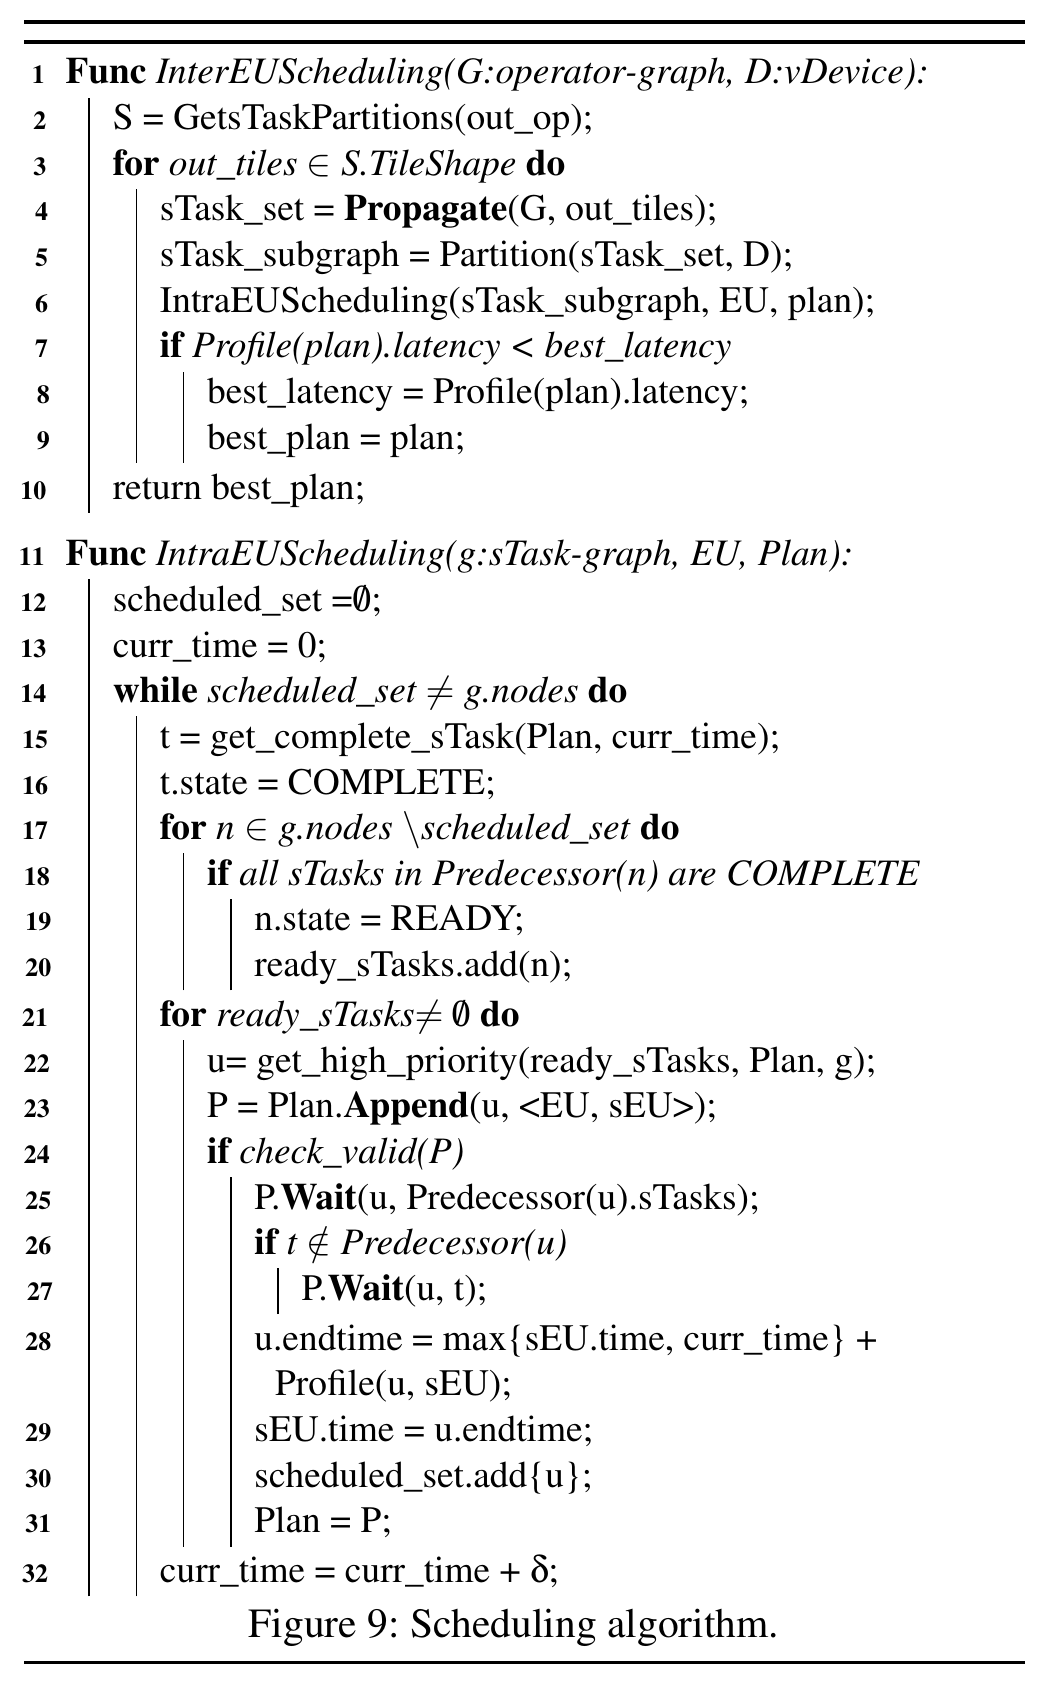
图 2|tile 枚举与流水构造的两层策略(取自论文 Figure 9[1])。外层传播 tile 并比较完整方案实测时延;内层维护任务完成时间、ready 集合、资源可用时间与存储约束,逐步形成执行方案。
5.1 先测单任务,用测量值估计时间线
Profiler 提供:单个 sTask 在目标 sEU 上的执行时延、局部存储与寄存器消耗,以及完整 sProgram 的实际时延。论文明确说明隔离生成并运行 sTask 的设备代码,取得单任务测量值。
排程时根据资源可用时间、前驱完成时间与测得的任务时延推导结束时间。Figure 9 的第 28 行可概括为:
这里 来自单任务 profiling,当前时间与 ready 集合由调度器推进。这是以测量为基础的时序估计;不是靠运行时精确计时发射每个任务,也不是靠预测保证数据一定已到达。 最终设备程序仍通过同步协议确认完成。
5.2 外层搜索 tile,内层优先释放下游工作
外层选择输出 tile,反向传播输入区域,再把子图均匀分配给 EU。内层优先安排依赖较少、异步、并能解锁下游任务的 ready 工作;在允许重叠的同时检查存储可行性。
这能处理两个互相牵制的目标:大 tile 通常有利于数据复用与单次矩阵计算效率,但深流水需要更多同时存活的中间缓冲区。tile 大小和流水深度不能各自独立取“越大越好”。
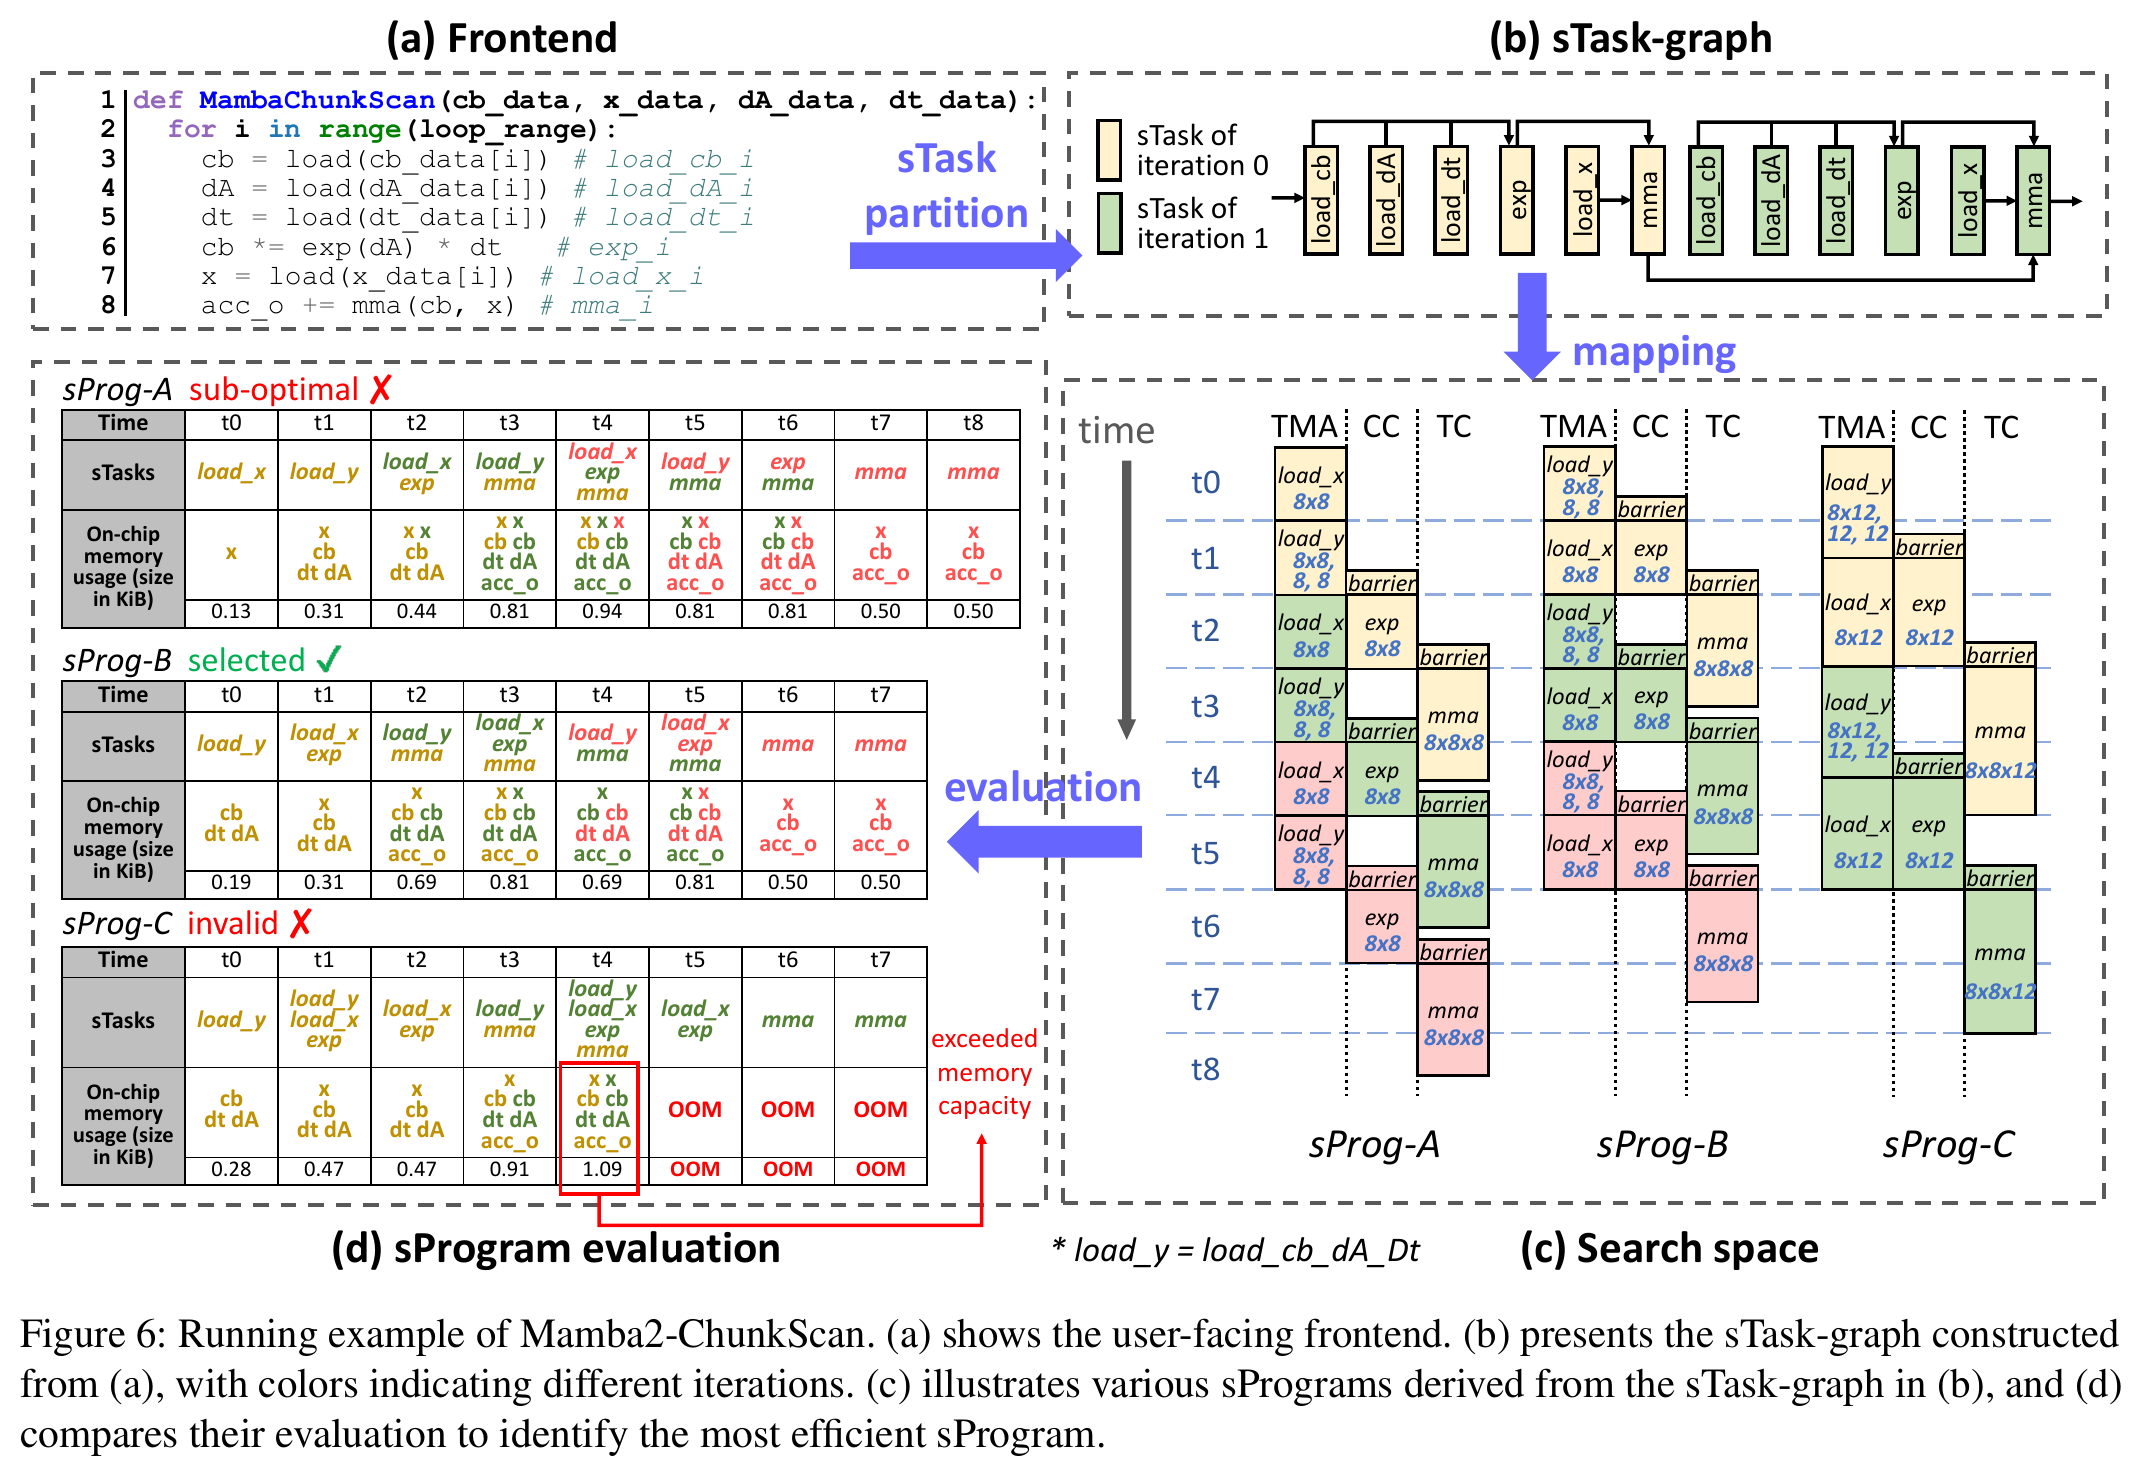
图 3|顺序、tile 与存储约束的联合权衡(取自论文 Figure 6[1])。A 提前载入矩阵的另一输入,使指数变换的前置数据较晚就绪,关键路径被延迟;B 先载入能解锁指数变换的数据,使后续矩阵计算更早推进;C 增大 tile 后超过示意的片上存储容量,被判为非法。图中的容量和时隙是说明机制的示例,不是 H100 硬件容量或实测周期。
5.3 完整方案仍然实测,最终比较完成时间
单任务时延不能完整捕获并发时的带宽争用、寄存器干扰和同步代价。论文的外层调度因此用整个生成方案的实测 latency选择结果。搜索空间可以包含大量合法顺序,但论文实际策略通过贪心构造压缩探索,而不是保证穷尽全部排序。
其优化目标是缩短完成时间。有限循环的填充/排空、真实递归依赖、资源吞吐差异仍会造成等待。某个单元出现空白并不自动表示排程失败;当没有合法 ready 工作或另一资源已成为瓶颈时,该空白可能不可消除。
6. Ascend:相同的 tile 思路,两条不同的工程路径
6.1 外部 tilelang-ascend:Cube/Vector 分工与同步 lowering
外部适配器的FlashAttention kernel 声明与存储分配显式使用 NPU kernel、核心/子核心索引、L1、L0C 和 UB。其循环主体把矩阵计算、Softmax、输出更新及跨核数据搬运写在同一循环中。
该路径的核心分工是:
Cube 处理矩阵乘,Vector 处理 Softmax/归约/逐元素计算;copy 根据源、目的的存储类型落到搬运路径。 L1、L0、UB 不是 interchangeable 的“片上 shared memory”;每种存储与可访问它的计算/搬运单元相连。
编译器的前期 lowering推导 buffer scope、向量化并推导布局。随后目标优化阶段执行跨核流水、Cube/Vector 合并、核内流水、存储规划和自动同步插入;最后分别生成 Ascend C 或 PTO 代码。
跨核流水文档展示的是经 workspace 传递的 Cube/Vector producer/consumer:生产者写完发布完成信号,消费者等待对应数据,再使用缓冲区;跨迭代复用还必须防止生产者覆盖未消费的数据。该文档的图表是阶段关系示意,不能直接作为实测时间线。
这一实现有明确的表达约束,例如不支持嵌套流水循环。因此,“能表达核内流水和跨核流水”不等于任意嵌套的融合图都会自动得到最优排程。
在这条已核对的编译路径里,流水主要来自阶段规划、循环重写、缓冲与依赖分析。不能仅据这些 pass,就说它完整实现了论文的单任务 profiling + 贪心时间线 + 完整计划实测搜索。
6.2 主仓库 Ascend 950:任务级自动调度和 Z3
950 后端复用前端,但有专属调度与代码生成。GEMM + ReLU 示例用固定 block grid 处理 persistent tiles,将归约循环流水化,再把矩阵结果送到 Vector 做 epilogue;示例说明明确矩阵计算使用 Cube,SIMT/SIMD vector function 使用 Vector,两者在同一次 kernel 内组合。
这里必须和旧硬件路径区分:该例用直接 L0C → UB 的 dual-copy 路径,不能把外部适配器示例中的 GM workspace 往返当成所有 Ascend kernel 的必经步骤。
编译流程中的自动调度序列依次完成:
- 规范化控制流并生成调度单元。
- 分配执行核心,识别可多缓冲的对象。
- 估计 latency 与 initiation interval(II)。
- 求解任务排程,规划多缓冲。
- 固化 Cube/Vector 分工,插入同步并生成实际缓冲区版本。
它如何知道操作应该去哪? 核心分配逻辑依据任务的资源 pipe 与存储访问约束推导:Cube 操作进 AIC,Vector 操作进 AIV;MTE2 搬运根据目标是 L1 还是 UB 选择可执行侧。一个不能被单一执行侧合法承担的原子任务会被拒绝,不能任意混用两类核心私有存储。
它如何预测运行时间? 搬运估计考虑数据量、带宽、descriptor 与完成开销;计算估计考虑操作数量、Vector 带宽和矩阵 shape/dtype 的吞吐。Vector 任务也允许使用用户注解的实测延迟。II 估计另行刻画资源接受新任务的间隔:异步操作的完成 latency 与可再次发射的 II 不是同一个值。
它如何找流水方案? 当前实现包含 Z3:直线任务调度输入显式列出 latency、II、资源、数据依赖及存储所有权冲突;约束和目标保证合法顺序,并最小化模型中的 makespan。对于循环,modulo schedule用迭代距离表示依赖、加入缓冲版本数与容量约束,再二分搜索可行 II。
Z3 检查的是“给定模型和约束下,这个 II 是否可行”,不是每试一个 II 都在 NPU 上跑一次。自动排程也不代表自动穷尽所有 tensor tile 形状。用户仍需选择或调优 tile、block 数、流水深度和实现方式;模型最优方案的真实表现需要设备测量。
后端按同步插入与多缓冲落实流程生成实际依赖协议。预测用于排序和重叠优化;实际完成信号用于正确性。 即便实际执行比模型慢,消费者应等待信号,结果不会因为“预计已经完成”而提前读取;性能则可能出现额外等待。
7. 如何回答“预测了,还是会 sweep 测试复杂均衡”?
表 3|各实现的调度依据、搜索方式与边界
| 路径 | 排程依据 | 实测/搜索发生在哪里 | 不能保证什么 |
|---|---|---|---|
| PipeThreader 论文 | 单任务实测时延与资源占用;两层调度与贪心顺序 | 枚举 tile,构造合法方案,再实测完整 sProgram | 未承诺全局最优或所有 sEU 无 bubble |
| 当前 TileLang CUDA | tile 程序、流水注解、目标指令能力与布局/依赖分析 | 可另开 autotuner,测试 tile、线程数、流水深度等配置 | 仅写流水循环不代表执行了论文全套联合搜索 |
| 外部 tilelang-ascend | NPU 存储/核心分工、阶段规划与同步分析 | 已核对流程主要生成流水;性能参数仍需另行测量调优 | 不支持任意嵌套流水;未据此证明实现论文 profiler 策略 |
| 主仓库 Ascend 950 | latency/II 模型、依赖、资源 pipe、存储约束与 Z3 | 模型内求解排程;设备 benchmark 用于验证与外围参数调优 | 不保证真实时延等于估计,不保证自动穷尽 tile 空间 |
| TileKernels | 每个算子的设备实现与经验配置 | 部分形状/dtype 规则直接选配置;测试与 benchmark 验证 | 统一 API 不代表 CUDA/Ascend 使用同一执行计划 |
例如 TileLang 的GEMM 搜索空间包含 tile 三个维度、流水深度、线程数及遍历策略;autotuner 配置与运行执行正确性检查和 profiling。这是明确的配置 sweep,但它是选用 autotuner 时的行为,不能推广为每次 JIT 都会自动 benchmark 所有合法配置。
对于复杂均衡,建议把实际问题拆成三项:是否存在合法 ready 工作,是否有足够缓冲区承载重叠,瓶颈资源能否持续获得工作。 单纯提高流水深度只能增加在途数据,不能增加瓶颈计算单元吞吐,也不能解除真实递归依赖。
8. 对独立任务 Kernel Fusion 的启发
本文的研究问题是独立矩阵任务与独立向量任务的资源互补,参见分类入口fusion-page。PipeThreader 的直接启发,是把两项工作拆成能标记资源、依赖和存储生命周期的 tile 任务,让编译器看见异构并行;它的主要例子则包含有依赖的算子链,不能直接当成独立任务共置的实验结果。
迁移到新的 NPU 时,至少需要回答:矩阵/向量/搬运是否有可独立推进的执行接口;中间存储由谁访问;哪些事件确认完成与缓冲释放;并发下的吞吐和内存竞争如何变化。可复用的是 tile 任务图、资源约束与联合调优思路;具体指令、layout、同步域和成本模型必须按硬件重新实现和测量。
9. 源码版本与证据范围
本页固定使用以下版本,链接均精确到行:
- TileLang:
390ecf34918ce1e4d7d9967df254f507b10557d8。 - tilelang-ascend:
1d5daf0385156cbe0c499a16c10935c5190642a4,默认分支为ascendc_pto。 - TileKernels:
c1cf914a82e6901c679445f872051ce44ac2cc63。
论文结论来自原文 §3–5 与 Figure 3/4/6/9/11;仓库关系、设备支持与现行 pass 机制来自上述源码。本次在 macOS 上完成论文与源码审计,未执行 NVIDIA/Ascend 设备 benchmark,因此不把静态时间线或成本模型的结果称为实测性能。
fusion-page. NPU 上的 Kernel Fusion:独立任务的资源互补与多引擎调度。 ↩
参考文献
[1] CHENG Y, WANG L, SHI Y, et al. PipeThreader: software-defined pipelining for efficient DNN execution[C/OL]//19th USENIX Symposium on Operating Systems Design and Implementation (OSDI 25). USENIX Association, 2025: 767–783. https://www.usenix.org/conference/osdi25/presentation/cheng
[2] TILE-AI. TileLang[EB/OL]. [2026-10-14]. https://github.com/tile-ai/tilelang/tree/390ecf34918ce1e4d7d9967df254f507b10557d8
[3] TILE-AI. TileLang-Ascend[EB/OL]. [2026-10-14]. https://github.com/tile-ai/tilelang-ascend/tree/1d5daf0385156cbe0c499a16c10935c5190642a4
[4] DEEPSEEK-AI. TileKernels[EB/OL]. [2026-10-14]. https://github.com/deepseek-ai/TileKernels/tree/c1cf914a82e6901c679445f872051ce44ac2cc63